2026.10.16
モデルルーティングでAI品質とコストを両立する実践法
IT関連
モデルルーティングとは、AIへの依頼内容に応じて最適なモデルへ自動振り分けする設計です。すべてを高性能モデルに任せず、品質を守りながら費用と応答時間を抑えられます。
生成AIを業務に組み込むと、問い合わせ分類、議事録作成、コードレビュー、契約書要約などで求める精度が異なります。一律のモデル選択では、簡単な依頼にも過剰な推論コストがかかり、難しい依頼では品質不足が起こります。
本記事では、ルーターの役割、代表的な方式、カスケード設計、評価指標、障害対策、ガバナンスまでを解説します。日本語の業務文書を扱う企業が、段階的に実装するための判断基準も整理します。
モデルルーティングの仕組みと必要性
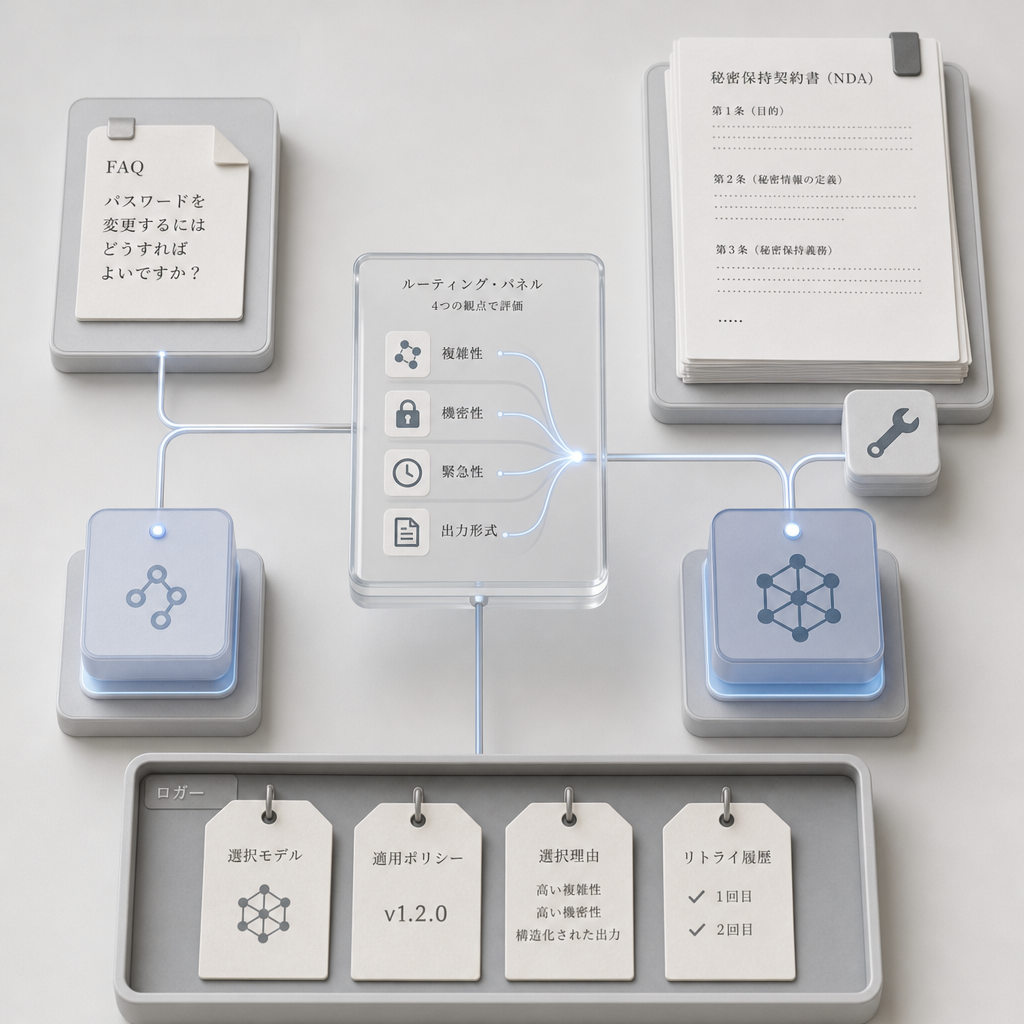
モデルルーターは何を判断するのか
モデルルーターは、入力の難易度・機密性・緊急度・必要な出力形式を読み取り、候補モデルから実行先を決める制御層です。単なるAPIの中継ではなく、要求に対する最適な処理経路を選ぶ役割を担います。
例えば、短いFAQへの回答は低価格・低遅延のモデル、法務文書の矛盾確認は推論性能の高いモデルへ送ります。ツール呼び出しが必要な依頼では、関数スキーマへの対応状況もルーティング条件に含めるべきです。
判断結果には、選択モデル、ポリシーのバージョン、判定理由、再試行履歴を記録します。後から「なぜこの回答になったのか」を追跡できれば、品質事故の調査とポリシー改善を確実に進められます。
- 入力分類:用途、言語、文書長、リスクを判定
- 出力要件:JSON、引用、ツール利用の可否を確認
- 実行制御:タイムアウト、予算、障害状況を考慮
APIゲートウェイとの違い
APIゲートウェイが認証、レート制限、ログ収集、API公開を横断的に扱うのに対し、ルーターはどの推論能力を使うかを決めます。両者は競合せず、ゲートウェイの内側または後段にルーターを置く構成が実務的です。
ゲートウェイだけでは、同じPOST /chat/completionsを受けても、要約と高度な設計レビューを区別できません。一方、ルーターだけでは認証や組織別の利用上限を安全に統一できないため、責務を分ける必要があります。
エージェント構成では、親エージェントが作業を分解し、各サブエージェントのタスク単位で実行先を選びます。会話全体を一つのモデルに固定せず、検索、抽出、推論、検証を別々に最適化できます。
- ゲートウェイ:認証、課金、通信制御
- ルーター:モデル選択、フォールバック、品質制御
- エージェント:タスク分解と実行順序の制御
最初に解くべき経営課題
導入目的は「最も安いモデルを選ぶこと」ではなく、品質目標を満たす総保有コストを下げることです。モデル料金のほか、ルーター推論、キャッシュ、監視、再試行、運用担当者の工数まで予算に含めます。
代表例として、100,000 daily requests のうち 70% of them to the cheaper tier とする設計があります。単純な定型処理を安価な層へ寄せ、残りを上位層で処理することで、高品質が必要な案件へ予算を集中できます。
開発支援では、軽い補完、リポジトリ検索、複雑な設計提案を分けると効果的です。ALION株式会社のように開発チームが伴走する場合も、要件定義段階で業務別の品質基準と許容遅延を合意しておくことが重要です。
- 品質目標:正確性、根拠、形式遵守
- 費用範囲:推論料だけでなく再試行と監視費
- 対象業務:件数が多く、難易度差が大きい領域
目的に合うルーティング方式の選び方
ルールベースは導入初期に向く
ルールベースは、文書種別、文字数、部署、キーワード、利用者権限などの明示条件で振り分ける方式です。判断根拠を説明しやすく、対象業務が限定的なら最短で安全な運用を始められます。
たとえば「契約」「個人情報」を含む入力は承認済みの閉域モデルに限定し、500文字未満の定型問い合わせは軽量モデルへ送れます。業務ルールが明確なほど、分類器を先に作るより失敗が少なくなります。
ただし、表現の揺れや複数意図には弱く、ルールが増えすぎると保守不能になります。例外を追加し続ける前に、誤判定ログを集め、次の段階で分類器や意味検索を併用する判断を行います。
- 強み:説明可能性と実装速度
- 適用例:権限別の送信先制限
- 注意点:例外ルールの増殖
分類器と意味判定は複雑な依頼に強い
分類器ベースは、過去の入力に「軽量」「高精度」「人手確認」といったラベルを付け、モデル選択を学習させる方法です。意味的に近い依頼を扱えるため、キーワードだけでは分けにくい日本語の業務依頼に有効です。
Embeddingによる近傍検索は、既知の問い合わせパターンを素早く参照する用途に適します。a million vectors を扱っても under 5 milliseconds とする検索基盤はありますが、実運用ではベクトル更新や誤分類の監視も設計に含めます。
LLMに判断させる方式は柔軟ですが、ルーター自身の費用と遅延が増えます。短い入力なら under 50 tokens の分類プロンプトに絞り、判断を複雑にしすぎないことが、費用対効果を保つ基本です。
- 分類器:ラベル付きデータで判定を学習
- 意味検索:類似案件を根拠に候補を選択
- LLM判定:未知の意図に柔軟、ただし監視が必要
方式は段階的に組み合わせる
実務では、単一方式よりルール、分類器、LLM判定を段階的に通す構成が安定します。まず機密情報や契約上の制約をルールで除外し、次に分類器で候補を絞り、曖昧な案件だけを上位判断へ回します。
7B-parameter model は軽量な分類や要約に使いやすい一方、70B model は複雑な推論で有利になり得ます。モデル規模だけを基準にせず、日本語の敬語、固有名詞、長文参照、専門語を含む検証セットで比較します。
高性能モデルは 10 to 50 times more per token になる場合があります。したがって、上位モデルへ送る条件は「難しそうだから」ではなく、評価済みの失敗パターン、信頼度、利用者への影響で定義します。
- 第1段階:ポリシー違反の入力を遮断
- 第2段階:軽量分類で候補を限定
- 第3段階:曖昧な案件だけを高度判定
カスケード設計で品質と速度を両立する
信頼度しきい値で上位モデルへ送る
カスケードとは、まず低コストモデルで回答し、信頼度が不足する場合だけ上位モデルへ引き上げる設計です。全件を最高性能で処理するより、通常ケースの費用と待ち時間を抑えながら品質下限を管理できます。
two-tier cascade では、一次モデルの回答に自己評価、形式検証、根拠の有無を付けます。しきい値を下回る場合、元の入力、一次回答、検証結果を上位モデルへ渡し、再作成またはレビューを依頼します。
ただし自己評価だけを信頼してはいけません。偽陰性、つまり誤った回答を高信頼と判定する失敗を、業務別の正解データと人手レビューで測定し、しきい値を定期的に見直します。
- エスカレーション条件:低信頼、形式違反、根拠不足
- 検証対象:事実性、JSON妥当性、引用の有無
- 重要指標:偽陽性と偽陰性の件数
フォールバックは障害を前提に設計する
フォールバックは、選択したモデルが遅延、障害、レート制限に陥った際、別の実行先へ安全に切り替える仕組みです。fallback to a different model if latency exceeds 2 seconds のように、利用者影響から明確な条件を決めます。
切り替え先は、単に利用可能なモデルでは不十分です。コンテキスト長、JSON出力、関数呼び出し、コンテンツポリシーが互換かを事前に検証し、非互換なら回答を返さず再試行または人手確認へ進めます。
タイムアウトが連鎖すると、再試行で負荷が増し、全体障害を広げます。サーキットブレーカーで不調なプロバイダーへの送信を一時停止し、指数バックオフとリクエスト上限を組み合わせることが必要です。
- 切替条件:遅延、HTTPエラー、利用上限
- 安全策:互換性テストと再試行回数の制限
- 復旧策:サーキットブレーカーと段階的復帰
キャッシュ認識で繰り返し処理を減らす
キャッシュ認識ルーティングは、長い共通プロンプトや規程集などが既にキャッシュ済みのモデルを優先する考え方です。同じ文脈を頻繁に送る業務では、料金だけでなく初回応答までの時間も改善できます。
一部の料金体系では、キャッシュされた入力は 10% of the uncached input cost です。社内規程、商品カタログ、定型システム指示を分離し、変更頻度の低い部分を安定させると効果を得やすくなります。
ただし、キャッシュキーに顧客IDや秘匿情報を不用意に含めてはいけません。テナント分離、保存期間、削除手順を定め、入力内容が他ユーザーの応答へ混入しない設計を優先します。
- 有効な対象:共通指示、規程、定型ナレッジ
- 設計要点:変動部分と固定部分を分離
- 安全要件:テナント分離と保存方針
導入効果を測る評価と改善の手順
品質・費用・遅延を同時に評価する
効果測定では、品質、コスト、レイテンシーを別々に見るだけでは不十分です。利用者が許容できる回答品質を下限として定め、その範囲で1件当たりの総コストとp95遅延を最小化する目的関数を置きます。
公開事例には、最上位モデルの品質を約95%保ったまま、コストを約85%下げられたケースがあります。ただし、自社でも同じ結果になるとは限らないため、業務固有の正解例と失敗例で再現性を確認します。
評価セットには、短文だけでなく、敬語、社内略語、表記揺れ、長文の参照関係、否定表現を含めます。特に法律、経理、顧客対応では、もっともらしい誤答の見逃し率を独立した指標として追跡します。
- 品質:正解率、根拠の適切さ、形式遵守
- 費用:1完了タスク当たりの総額
- 速度:平均値だけでなくp95・p99遅延
A/Bテストでポリシーを安全に比べる
ルーティングポリシーの変更は、A/Bテストで比較するのが安全です。send 50% of traffic to inference provider A and 50% to inference provider B のように分割し、同種の依頼で品質、費用、障害率を同時に確認します。
Cursorの数百万件のリクエストにまたがるA/Bテストでは、コストを約60%削減しました。大規模な結果は有用な目安ですが、業務の言語、プロンプト、ツール利用が異なるため、そのままの設定をコピーするのは避けます。
実験中は、モデル名だけでなく、プロンプト版、ルール版、分類器版、評価データ版を固定して記録します。比較条件が動くと、改善なのかデータ変化なのかを判別できず、誤った意思決定につながります。
- 分割単位:利用者、組織、タスク種別
- 比較項目:品質、費用、遅延、離脱率
- 記録対象:ポリシーとプロンプトのバージョン
ダッシュボードは誤判定を可視化する
監視の要点は、平均コストの低下ではなく、ルーターの誤判定が利用者へ与える影響を早期に見つけることです。選択先、しきい値、結果、ユーザー評価、再試行を一つの追跡IDで結びます。
アラートは、上位モデルへの転送率急増、特定モデルの形式違反、フォールバック率上昇、p95遅延悪化に設定します。急な変化は、プロバイダー障害だけでなく、入力傾向やプロンプトインジェクション攻撃の兆候にもなります。
品質ドリフトを検出するため、固定した評価セットを継続実行します。日々の実トラフィックだけに頼ると、難しい依頼が減っただけでも改善に見えるため、比較可能な基準を残す必要があります。
- 必須ログ:選択理由、結果、再試行、評価
- 主要アラート:転送率、失敗率、遅延、費用
- 検証方法:固定評価セットと実トラフィックの併用
安全な企業運用へ落とし込む実装原則
入力データの送信先をポリシー化する
企業利用では、どの入力をどのベンダーへ送れるかを先に定義することが最重要です。個人情報、営業秘密、顧客データ、国外移転の制約を分類し、ルーターが選べるモデルプールをデータ区分ごとに制限します。
HIPAA、SOC 2、FedRAMP などの要件は、モデル性能の比較とは別に確認します。認証の有無だけで判断せず、データ保存、学習利用、ログ保管地域、削除要求、委託先を契約と技術設定の両面で確認します。
プロンプトインジェクションによって「高性能モデルへ送れ」と入力が誘導しても、入力本文にルーティング権限を与えてはいけません。選択ポリシーはシステム側で固定し、利用者の指示とは分離して評価します。
- データ分類:公開、社内、機密、規制対象
- 送信制御:許可済みモデルプールのみを参照
- 攻撃対策:入力命令と制御ポリシーを分離
変更管理と監査証跡を残す
安全な運用では、モデル切り替えを設定変更ではなく業務変更として扱います。誰が、いつ、どの根拠で、どのポリシーを変更したかを残し、重要業務は承認者とロールバック手順を必須にします。
モデル提供元の更新で出力形式やツール呼び出しが変わることがあります。変更前に、JSONスキーマ、関数引数、最大コンテキスト、エラー応答を含む回帰テストを実行し、互換性を確認してから公開します。
本番への反映は、小さな利用者グループから開始します。異常があれば旧ポリシーへ即時に戻せるよう、設定をコード化し、実行ログにポリシー識別子を必ず付与します。
- 承認対象:モデル追加、しきい値変更、送信先変更
- 事前試験:形式、ツール、長文、障害時の挙動
- 復旧準備:版管理、段階公開、即時ロールバック
小さく始めて対象業務を広げる
導入の第一歩は、件数が多く、結果を判定しやすく、失敗時に人が確認できる業務を一つ選ぶことです。たとえば社内FAQの分類と下書き作成なら、ルーティングの効果を比較的短期間で測れます。
最初の段階では、ルールベースと二層カスケードに限定し、複数ベンダーを急いで増やしません。運用チームがログの意味を理解し、例外対応を回せる状態になってから、分類器やキャッシュ最適化を追加します。
モデルルーティングは一度作って終わる機能ではありません。実際の問い合わせ、障害、利用者の評価からポリシーを更新するため、開発、業務部門、情報セキュリティが同じ指標を見て改善を続ける体制が必要です。
- 開始業務:定型的で評価しやすい処理
- 初期構成:ルールと二層カスケード
- 改善体制:開発・業務・セキュリティの共同運用
まとめ
モデルルーティングは、複数のAIモデルを使い分け、品質、費用、速度、安全性を同時に整えるための運用設計です。ルールによる制約から始め、評価データ、フォールバック、監査証跡を整えながら段階的に高度化しましょう。
要点
- 最初に品質下限とデータ送信ルールを定義する
- 軽量モデルから上位モデルへ上げるカスケードを設計する
- 品質・費用・遅延・誤判定を同じダッシュボードで監視する
- モデル変更はテスト、承認、ロールバックを伴う運用にする
- 日本語の業務文書を含む自社データで必ず評価する
まずは対象業務を一つ選び、入力の種類、許容品質、許容遅延、送信可能なモデルを棚卸ししてください。要件整理から評価基盤、AIシステム開発まで、伴走できる体制を整えることが継続的な成果につながります。
よくある質問
Q1. モデルルーティングは小規模なチームにも必要ですか?
はい。複数モデルを利用し、依頼ごとに品質や費用の差が大きいなら有効です。まずは機密情報の送信制御と、軽量・高性能の二層構成から始めると運用負担を抑えられます。
Q2. ルーターにLLMを使うと費用が増えませんか?
増える可能性があります。短いルールや軽量分類器で判定できる入力を先に除外し、曖昧な案件だけをLLM判定へ送る構成にすると、判断コストを管理しやすくなります。
Q3. フォールバック時に回答品質が落ちる場合はどうしますか?
代替モデルの互換性と品質を事前に評価し、基準を満たさない場合は自動回答せず、人手確認や後続処理へ切り替えます。障害時の品質下限をポリシーとして明文化することが重要です。
Q4. 日本語の業務文書では何を評価すべきですか?
敬語、固有名詞、略語、長文の参照関係、否定表現、専門用語を含むテストケースを用意してください。一般ベンチマークだけでは、実際の文書で起こる誤判定を十分に捉えられません。
Q5. 複数ベンダーを使う最大の利点は何ですか?
特定のモデル障害や価格変更への耐性を高め、用途ごとに性能と契約条件を選べる点です。ただし、データ送信先、出力形式、監査ログを統一しなければ運用が複雑になるため注意が必要です。
参考文献・出典
 ## AI経営手帖 サイト内検索 # モデルルーティングとは…
keieiax.jp
# A Comprehensive Guide to Model Routing **Model routing is the practice of intelligently choosing the best model at the lowest cost for each incoming AI…
www.notdiamond.ai