2026.11.13
LLMOpsダッシュボードで生成AI運用を可視化する方法
IT関連
LLMOpsダッシュボードは、生成AIを本番で安全に使い続けるための運用画面です。回答品質、遅延、トークン消費、セキュリティ上の兆候を一つの流れで把握できます。
LLMアプリケーションは、モデルを呼び出して終わりではありません。プロンプト、検索データ、ツール呼び出し、モデル更新が相互に影響するため、障害や品質低下の原因をログだけで追う運用には限界があります。
本記事では、必要な指標、RAGを含む監視設計、インシデント対応、ガバナンス、導入手順を解説します。担当者別に何を見るべきかも整理し、実務で使える運用の基準を示します。
LLMOpsダッシュボードが担う役割
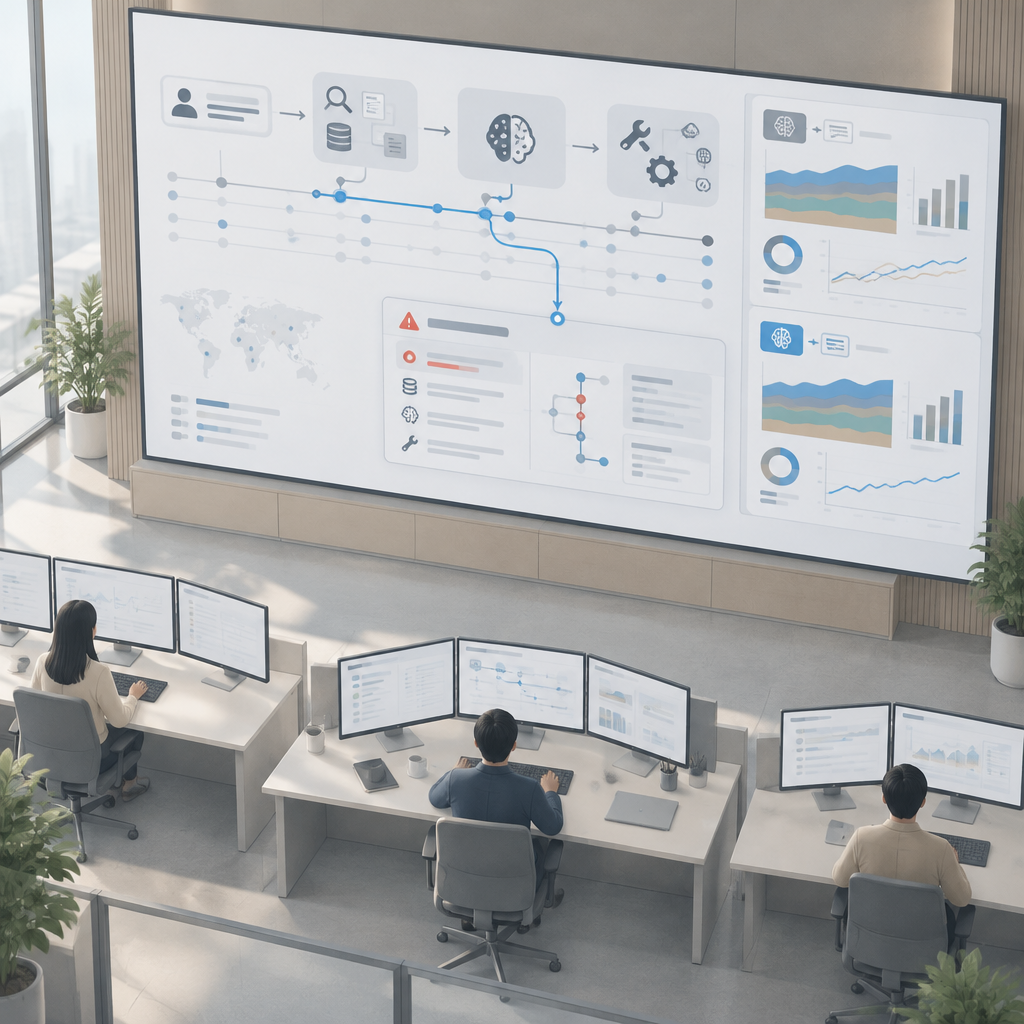
本番の生成AIを横断的に観測する
結論として、ダッシュボードの役割は利用者の一回答を、入力から出力まで追跡可能にすることです。アプリ、検索、モデル、外部ツールの記録を同じリクエスト単位で結び、障害の発生地点を短時間で絞り込みます。
従来のMLOpsは学習データやモデル性能の管理が中心でした。一方でLLM運用では、プロンプトの文言、会話履歴、取得した文書、推論先モデルが毎回変わるため、実行時の文脈を残す必要があります。
画面には、サービス全体の健康状態だけでなく、個別トレースへ掘り下げる導線を用意します。要約が遅い、根拠のない回答が増えた、といった事象を利用者報告だけに頼らず、観測可能な事実として扱えます。
- リクエスト単位でアプリからモデル応答までを相関付ける
- 品質・速度・費用・安全性を同じ時系列で確認する
- 集計値から個別トレースへドリルダウンできるようにする
ライフサイクル管理の判断を速くする
結論として、モデルやプロンプトの更新は、比較可能な証拠を残して判断します。デプロイ後の数値だけを見るのではなく、変更前後のトラフィック、評価結果、失敗例を並べることで、安全なリリース判断ができます。
たとえば属性として「gen_ai.response.model」に「gpt-4.1-mini-2025-04-14」、「gen_ai.prompt.version」に「4.2.0」を記録します。これにより、品質変化をモデル変更とプロンプト変更のどちらに結び付けるかを検証できます。
実装では、プロンプト、評価セット、ダッシュボード定義もコードとして管理するのが有効です。レビュー、リビジョン管理、ロールバックを開発フローに含めれば、誰が何を変えたかを監査可能な形で説明できます。
- モデル、プロンプト、検索設定を変更単位として記録する
- 本番評価とオフライン評価を同じ基準で比較する
- 失敗時に前の設定へ戻せる手順を用意する
担当者ごとに必要な画面を分ける
結論として、全員に同じ画面を見せるより、意思決定に必要なビューを役割別に分ける方が有効です。経営層、プロダクト担当、SRE、MLエンジニアでは、確認すべき粒度と判断の時間軸が異なります。
経営・プロダクト側は、利用量、費用推移、業務成果に近い品質指標を確認します。SREはエラー率、レイテンシ、依存先の失敗を追い、MLエンジニアは評価スコア、失敗カテゴリ、プロンプト別の変化を分析します。
閲覧権限も画面設計の一部です。顧客入力や会話ログを含むパネルは最小権限で公開し、集計画面と詳細画面を分離します。必要な人が必要な情報だけを確認できる構成が、運用速度と情報保護を両立します。
- 経営層には費用・利用・品質の要約を示す
- SREには可用性と依存関係の異常を示す
- 開発者にはトレースと評価データを示す
可観測性を支える指標とテレメトリ設計
トレースは原因究明の基盤になる
結論として、トレースは一回の応答が遅い、または不適切だった理由を再現するための基盤です。親スパンを利用者要求に置き、検索、再ランキング、モデル呼び出し、ツール実行を子スパンとして接続します。
OpenTelemetryの属性では、入力と出力のトークン、モデル名、キャッシュ利用、評価イベントを関連付けられます。OpenTelemetry Python SDK 1.44.0を使う場合も、アプリ固有の属性名を乱立させず、共通規約に寄せることが重要です。
ただし、すべての本文を無制限に保存してはいけません。調査に必要なメタデータを優先し、本文はマスキング、ハッシュ化、短期保持を組み合わせます。観測性はログを増やすことではなく、再現可能な証拠を残すことです。
- リクエストIDを全スパンへ伝播する
- 検索・推論・ツール実行を分離して計測する
- 本文と個人情報の収集範囲を事前に定義する
遅延とスループットを利用体験で読む
結論として、レイテンシは平均値だけでなく、利用者が待つ長い側の応答で判断します。特にストリーミング型のチャットでは、最初のトークンが表示されるまでの時間と、回答完了までの時間を分けて追跡します。
要約APIのp95が倍増した場合、モデルそのものだけを疑うのは早計です。長い入力、ベクトル検索の待ち、外部ツールの再試行、フォールバック回数などを同じトレースで確認し、ボトルネックを分解します。
負荷試験の結果は、実運用の目標設定に役立ちます。たとえば「350+ RPS on 1 vCPU」や「~3–4 ms latency」といった測定値も、モデル推論時間を含むのか、どの区間を測った値なのかを明記して比較する必要があります。
- p50だけでなくp95・p99を確認する
- 初回表示までの時間と完了時間を分ける
- 検索、モデル、ツールの待機時間を比較する
トークンと費用をモデル別に分解する
結論として、費用は請求総額ではなく、テナント、機能、モデル、入力・出力トークンへ分解して監視します。これにより、利用増による自然な上昇と、設計不備による異常な増加を区別できます。
計測値には「gen_ai.usage.input_tokens: 812」「gen_ai.usage.cache_read.input_tokens: 640」「gen_ai.usage.output_tokens: 137」のような値を残します。キャッシュ読み取りを別に把握すれば、最適化が実費と応答速度へ与える影響を評価できます。
月額のモデル請求額が40%上昇したとき、単に利用制限をかけるのは適切ではありません。40ページの契約書を貼り付ける1人の利用者が、通常の千件超のリクエストより高くなる場合もあり、入力長と機能単位の分析が不可欠です。
- 入力・出力・キャッシュ読取トークンを分ける
- 機能別・テナント別・モデル別に費用を見る
- 長大入力を検知して利用者へフィードバックする
品質低下を早期に見つける評価とRAG監視
品質は単一の正解率では測れない
結論として、生成AIの品質は用途に応じて複数の評価軸で監視します。正確性だけでなく、根拠性、関連性、形式遵守、安全性、利用者による再編集の有無を組み合わせると、現場の失敗を捉えやすくなります。
評価イベントには「gen_ai.evaluation.score.value: 0.82」のように、スコアと評価方法を保存します。自動評価だけで確定せず、高リスクの業務では人手レビューの結果も加え、評価器そのものの偏りを定期的に点検します。
品質指標は全体平均で安心しないことが重要です。特定の部署、言語、文書種別だけで品質が落ちることがあります。フィルタ可能なダッシュボードにし、失敗サンプルへ直接遷移できる導線を設計します。
- 根拠性・関連性・安全性を用途別に選ぶ
- 評価スコアに評価方法と対象バージョンを添える
- 全体平均とセグメント別の差を併読する
RAGは検索から回答まで一連で評価する
結論として、RAGの問題は回答画面だけでは切り分けられません。質問、クエリ書き換え、埋め込み、検索結果、再ランキング、コンテキスト、最終回答を一つのトレースに残す必要があります。
根拠性の合格率が0.94から0.88へ下がった場合、モデル変更だけでなく、更新されたデータソース、チャンク分割、埋め込みモデル、検索フィルタを順に確認します。取得できていない情報をモデルだけで補うことはできません。
運用では、検索ヒット数や参照文書の鮮度と、回答評価を同じ期間で比較します。RAGの品質、モデルコスト、レイテンシはトレードオフになり得るため、どこで悪化したかを依存関係として可視化します。
- 検索クエリから最終回答までを追跡する
- 参照文書の版とデータソースを記録する
- 検索品質と回答品質を別々に評価する
本番評価で改善の優先度を決める
結論として、本番評価は、実際の利用条件で改善順位を決めるために行います。オフラインの代表データだけでは、長文入力、曖昧な質問、想定外のツール操作といった現実の偏りを十分に捉えられません。
A/Bテストでは、変更群と比較群のトラフィック条件を揃えます。プロンプトやモデルの差だけでなく、入力長、利用機能、失敗率を比較し、改善が特定条件だけで成立していないかを確認します。
評価結果は是正ループへつなげます。失敗を分類し、プロンプト修正、検索改善、ガードレール追加、モデルルーティング変更の候補に変換します。評価は報告のためではなく、次の安全な変更を選ぶ材料です。
- 本番データを匿名化・抽出して評価対象にする
- 比較条件と対象バージョンを固定する
- 失敗分類から改善タスクを作成する
LLMOpsダッシュボードで行う障害対応
アラートは利用者への影響から設計する
結論として、アラートはメトリクスの変化ではなく、利用者影響と対応行動に結び付けて設計します。通知を増やしすぎると重要な兆候が埋もれるため、警告、緊急、情報のように担当と判断を明確に分けます。
たとえばエラー増加、p95遅延の悪化、費用急増、根拠性低下は、単独では異なる原因を持ちます。アラート本文には対象機能、影響範囲、直近の変更、トレースへのリンクを含め、初動調査を短縮します。
重要なのは、数値の固定的なしきい値を他社からコピーしないことです。業務の許容時間、利用量、誤答時の影響によって適正値は変わります。ベースラインを観測してから、サービスごとに基準を合意します。
- アラートごとに担当者と初動手順を定義する
- 影響範囲と変更履歴を通知へ添える
- サービス固有のベースラインから基準を設ける
トレースへのドリルダウンで根本原因を探る
結論として、障害調査は集計グラフから個別トレースへ移り、変更点と依存関係を照合する順序が効率的です。最初から大量ログを読むのではなく、異常が起きた利用者経路を代表例として確認します。
あるワークフローが3回ではなく30回モデル呼び出しを行っていれば、ループや再試行の設計不備が疑えます。各呼び出しの目的、入力長、ツール応答、フォールバック理由を確認し、再現条件を記録します。
原因を特定した後は、モデル切替、プロンプト切戻し、キャッシュ有効化、ツール停止など、影響を抑える変更を選びます。恒久対応と暫定回避策を分け、いつ通常設定へ戻すかも明記しておきます。
- 異常時間帯と影響機能から代表トレースを選ぶ
- 再試行・フォールバック・ツール呼び出し回数を確認する
- 暫定対処と恒久対処を別の変更として管理する
インシデント後に運用ルールを改善する
結論として、復旧後の振り返りでは個人の操作ではなく、検知、判断、復旧の仕組みを改善します。事実のタイムラインを残せば、次回の担当者が同じ判断を再現でき、属人化を減らせます。
振り返りでは、最初に観測できた兆候、通知された時点、影響範囲、緩和策、完全復旧の条件を整理します。見えなかった情報があれば、新たな属性、パネル、評価データを追加する改善につなげます。
ダッシュボード定義をコード化していれば、修正もレビュー対象にできます。クエリの誤りやパネルの意図しない変更を検出し、失敗時には既知の定義へ戻せるため、監視画面そのものの信頼性も高まります。
- 事実に基づくタイムラインを残す
- 検知漏れを計測設計の改善へつなげる
- ダッシュボード変更もレビューとロールバックの対象にする
安全な運用を続けるガバナンスと導入手順
ログの保護とアクセス制御を先に決める
結論として、可観測性データは収集前に、誰が何を見られるか、どこへ保存するか、いつ削除するかを決めます。プロンプトや応答には個人情報、契約情報、機密の業務情報が含まれる可能性があります。
マルチテナント環境では、テナントIDを必ず計測属性へ付与し、検索条件だけで分離を期待しない設計にします。RBACにより、運用者、開発者、監査者、顧客管理者の閲覧範囲と操作範囲を分けます。
プロンプトインジェクションや不正なツール利用も、監視すべき運用リスクです。ガードレールの判定、拒否理由、ツール実行の許可・拒否を記録し、内容を必要以上に露出させずに監査できる形へ整えます。
- 保存対象、保持期間、削除方法を文書化する
- テナント境界とRBACをデータ層から設計する
- 安全制御の判定結果を監査証跡として残す
標準へ接続して説明可能性を高める
結論として、独自の運用ルールだけで完結させず、公開標準に接続すると説明可能性が高まります。NIST AI RMFやISO/IEC 42001を参照し、リスク管理、責任分担、証拠の保全を組織の方針と結び付けます。
OpenTelemetry GenAIのセマンティック規約は、異なる計測基盤間で意味をそろえる助けになります。12 June 2026にsemantic-conventions v1.42.0は、main repository内のすべての「gen_ai.*」定義を非推奨とし、専用リポジトリへ移しました。
標準への追随は、単なる属性名の置換ではありません。計測項目の意味、バージョン移行、後方互換性を管理する作業です。採用する規約の版、移行期限、影響するダッシュボードを一覧化して変更を計画します。
- リスク、責任者、証拠を運用ルールへ結び付ける
- テレメトリ属性の意味と版を管理する
- 規約変更の影響をダッシュボードまで確認する
小さく導入して改善範囲を広げる
結論として、導入は重要な一機能から始め、計測の正確さを確認して段階的に広げる方法が現実的です。最初から全モデル、全ログ、全評価を統合しようとすると、データ保護と運用設計の論点が複雑になります。
最初の対象には、利用頻度が高く、失敗時の影響を説明しやすいチャットや要約機能を選びます。リクエスト数、レイテンシ、トークン、エラー、評価結果を計測し、実際に一件の異常を追えることを検証します。
ALION株式会社のように、AIシステム開発を専属チームで伴走する体制を活用する場合も、要件定義では画面より先に運用責任を明確化します。業務担当、開発、インフラ、セキュリティが見る指標と対応範囲を合意することが成功の起点です。
- 重要な一機能でトレースと指標を検証する
- 異常を一件再現して調査導線を確認する
- 役割別の責任範囲を導入時に合意する
まとめ
LLMOpsダッシュボードは、生成AIの品質、費用、速度、安全性を別々に眺めるための画面ではありません。変更・実行・評価・是正をつなぎ、本番運用を再現可能にするための基盤です。
要点
- トレースで検索、モデル、ツール、応答を一つの要求として結び付ける
- 品質・費用・レイテンシはセグメント別に見て、原因を個別トレースで確認する
- プロンプト、モデル、画面定義を変更管理し、ロールバック可能にする
- ログ保護、RBAC、監査証跡を計測設計の初期段階から組み込む
- 小規模な対象機能で検証し、担当者ごとの運用ビューへ段階的に広げる
まずは本番で重要な一機能を選び、リクエストID、モデル名、トークン、レイテンシ、評価結果を結び付けて計測してください。可視化の目的を「見ること」ではなく、異常時に誰が何を判断するかへ置くことが、継続的な改善につながります。
よくある質問
Q1. LLMOpsダッシュボードと通常の監視ダッシュボードの違いは何ですか?
通常の監視がCPU、メモリ、HTTPエラーなどを主に扱うのに対し、LLMOpsではプロンプト、モデル、トークン、検索結果、評価スコア、ガードレール判定まで相関させます。生成AI固有の品質と費用を、実行文脈とともに調査できる点が違いです。
Q2. 最初に監視すべき指標は何ですか?
対象機能ごとに、リクエスト数、エラー、p95レイテンシ、入力・出力トークン、モデル別費用、品質評価を優先します。加えて、RAGを使う場合は検索結果と参照文書の版を記録してください。
Q3. ログにプロンプト全文を保存してもよいですか?
無条件の全文保存は避けるべきです。個人情報や機密情報を含む可能性があるため、マスキング、ハッシュ化、アクセス制御、保持期間、削除手順を設け、調査目的に必要な範囲へ収集を限定します。
Q4. RAGの回答品質が下がったときは何から確認しますか?
質問、検索クエリ、取得文書、再ランキング、コンテキスト、最終回答を同じトレースで確認します。モデルだけでなく、データソース更新、チャンク設定、埋め込み、検索フィルタの変更も併せて確認することが重要です。
Q5. ダッシュボード導入を小さく始める方法はありますか?
利用頻度が高い一機能を選び、リクエストID、モデル名、トークン、レイテンシ、エラー、評価結果を結び付けて計測します。実際の異常を一件追跡できることを確認してから、対象機能や運用ビューを広げる方法が有効です。
参考文献・出典
## Navigation Menu …
github.com
…
www.truefoundry.com
[Dash0 acquires Polar Signals](/blog/dash0-acquires-polar-signals) [](/) [Sign…
www.dash0.com