2026.10.22
LLM可観測性で生成AI運用を見える化する方法
IT関連
LLM可観測性とは、生成AIが「なぜその回答を返し、どこで時間や費用を使い、どの程度信頼できるか」を追跡可能にする仕組みです。画面上で回答が正常に見えても、根拠のない回答や検索失敗、再試行の増加は裏側で進行します。
従来の監視では、HTTP 200やCPU使用率を確認すれば障害の多くを検知できました。しかしLLMアプリケーションでは、プロンプト、モデル、RAG検索、ツール呼び出し、生成結果までを一連の処理として捉える必要があります。
本記事では、LLM可観測性の基本、LLMOps監視のKPI、Day 2に必要なLLMOps運用、AIコスト管理、プロンプト管理までを実務の流れで整理します。シリーズ「LLM・AI基盤の運用最適化」第1回として、導入の判断軸を解説します。
LLM可観測性とは何かを正しく定義する
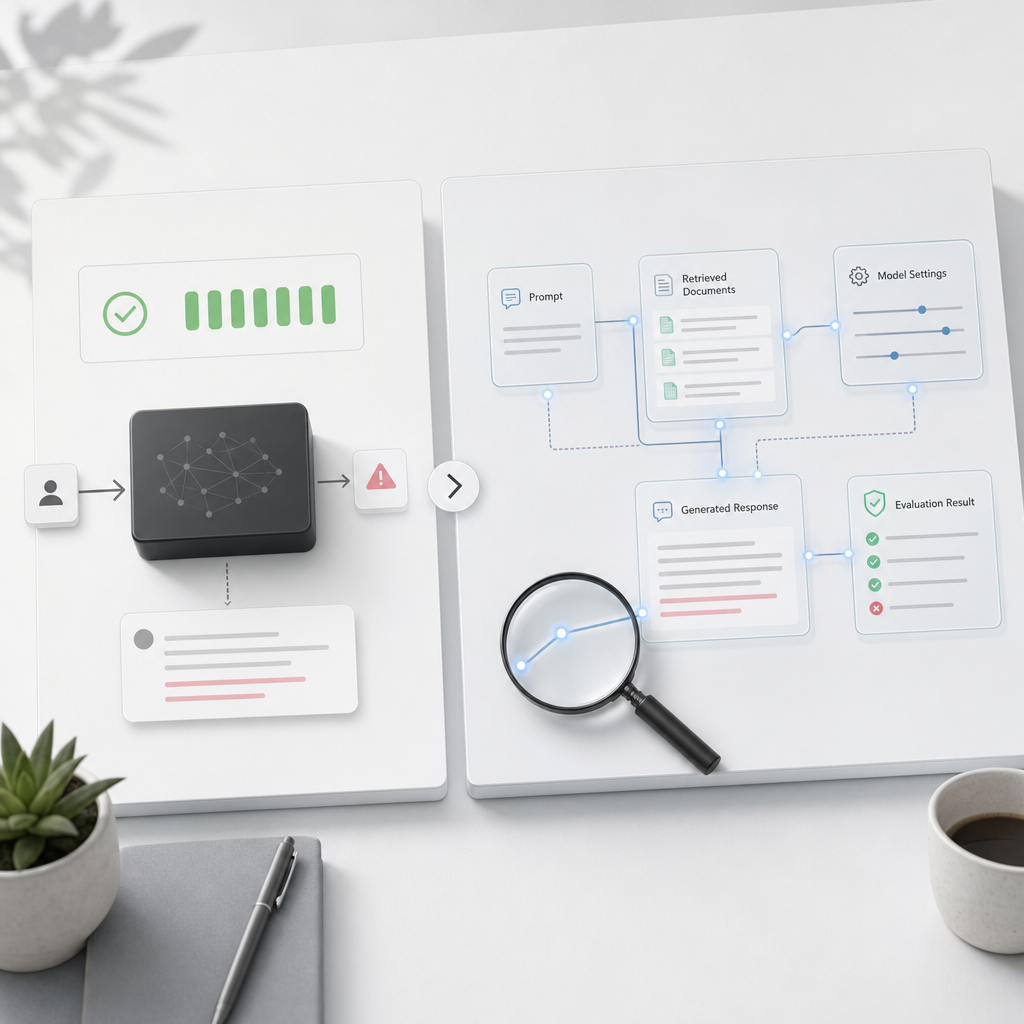
従来の監視だけでは回答品質を説明できない
LLM可観測性は、システムの稼働状態だけでなく、入力から出力までの意思決定に近い処理履歴を観測する考え方です。障害がなくても回答が不正確なら、ユーザーにとってサービス品質は低下しています。
APMはレイテンシやエラー率の把握に強く、AIモデル監視はモデル性能の変化を中心に扱います。一方でLLM可観測性は、プロンプト、検索文書、モデル設定、生成文、評価結果を関連付けて調査します。
例えばHTTP 200でも、RAGが無関係な文書を取得した結果、もっともらしい誤答が生成されることがあります。成功ステータスだけを根拠にせず、回答の根拠と利用者の反応まで記録する設計が必要です。
- 稼働状況:エラー率、レイテンシ、スループット
- 生成品質:関連性、Faithfulness、有害性、完了率
- 説明可能性:入力、参照情報、出力、評価のつながり
MELTで観測データを一貫して集める
LLM可観測性の土台は、MELT、すなわちメトリクス、イベント、ログ、トレースです。四つを分断して保管すると、急な費用増加と特定のプロンプト変更を結び付けられず、原因究明が遅れます。
メトリクスにはp50、p90、p99レイテンシ、トークン量、エラー率を置きます。イベントにはモデル切替や設定変更を残し、ログには個人情報をマスキングした入出力要約と評価スコアを保存します。
トレースは一つの利用者要求を親子スパンでつなぐ記録です。LLMコール、ベクトル検索、再ランキング、ツール実行を同じトレースIDで追えば、遅延や品質低下が起きた地点を特定できます。
- メトリクスは傾向と閾値超過を検知する
- イベントは変更点と障害発生を対応付ける
- ログとトレースは個別事象の再現に使う
分散トレースでRAGとエージェントを追跡する
RAGやAIエージェントでは、最終回答だけを記録しても原因は分かりません。質問、検索クエリ、文書ID、類似度、引用箇所、モデル出力、ツール結果を一続きで追うことが直接的な解決策です。
RAG可観測性では、検索コンテキストが質問に関連していたか、生成文が引用資料に忠実だったかを別々に評価します。検索失敗と生成失敗を混同しないため、段階ごとのスコアが欠かせません。
エージェントでは、状態遷移、推論ループ、権限付きツール呼び出しを追跡します。同じツールを3回以上呼んだ会話を検知すれば、無限ループや曖昧な指示による再試行を早期に切り分けられます。
- RAGは検索・根拠・生成を個別に評価する
- エージェントはツール成功率とループ回数を記録する
- トレースIDを利用者要求と監査記録に連携する
LLMOps監視で品質と業務成果を測る
監視KPIは業務目標から逆算して決める
LLMOps監視では、先に「何を守るか」を業務成果として定義し、その後に技術KPIへ落とし込みます。単に応答回数を増やすのではなく、問い合わせ解決、根拠提示、処理完了など、利用部門が判断できる成果に接続します。
たとえば社内検索なら、根拠付き回答率と検索失敗率を主要指標にします。顧客対応なら、タスク完了率、有人引き継ぎ率、危険な回答の発生率を追い、速度だけで成功を判定しません。
SLOは現状のベースラインを測ってから合意します。例として「過去1週間のリクエストのうち、評価スコア(Faithfulness)が0.8を下回る回答の割合を、5%未満に抑える」と定めると、対応優先度が明確になります。
- 業務KPI:解決率、完了率、根拠付き回答率
- 品質KPI:関連性、Faithfulness、ハルシネーション率
- 運用KPI:p95レイテンシ、再試行率、エラーバジェット
品質評価は自動判定と人手評価を組み合わせる
AIモデル監視における品質評価は、単一の自動スコアだけでは完結しません。オフラインのGolden Set、オンラインの利用者フィードバック、LLM-as-a-Judge、人手レビューを組み合わせ、判定の偏りを相互に確認します。
定型出力ではBLEUやROUGEも参照できますが、対話やRAGでは関連性、Faithfulness、引用の正確性を重視します。判定モデルが高評価でも、業務担当者が使えないと判断する例を定例レビューで確認します。
例えば100 real questionsを用意し、変更前後の回答を比較します。85% of queries passingという結果だけを採用判断にせず、残る15%が安全性や重要業務に関わる失敗ではないかを分類する姿勢が重要です。
- Golden Setは業務上重要な質問を中心に構成する
- 自動評価は人手レビューで定期的に校正する
- 失敗例は原因別に分類して改善バックログへ渡す
性能・安全性・費用を同じ画面で監視する
LLMOps監視は、品質、性能、安全性、費用を別々の担当だけに閉じないことが重要です。品質低下が再試行を増やし、再試行が遅延と費用を押し上げるため、四つの指標には強い因果関係があります。
性能面ではTTFT、p50・p95レイテンシ、スループット、入出力トークン、キャッシュ率を追います。安全面ではプロンプトインジェクション、PII漏洩、脱獄試行、ツール権限逸脱をイベントとして記録します。
インシデント対応を整備した組織では、調査対象を絞ることでMTTRを30%削減できます。アラートは閾値超過だけでなく、品質と再試行率が同時に悪化したような複合条件で設計すると有効です。
| 用途 | 品質指標 | 性能指標 | 安全・費用指標 |
|---|---|---|---|
| 社内RAG検索 | Faithfulness・引用正確性 | 検索・生成レイテンシ | 文書権限・トークン量 |
| 顧客対応AI | 解決率・有人引継率 | TTFT・完了時間 | PII・再試行費用 |
| 業務エージェント | タスク完了率・ツール成功率 | ループ回数・待機時間 | 権限逸脱・実行費用 |
- 速度低下はモデル、検索、ツール、再試行に分解する
- 安全イベントは入力・出力・実行権限の三層で確認する
- アラートには担当者、初動、エスカレーション先を定義する
LLMOps運用をDay 2の定常業務に変える
LLMOps運用は本番公開後からが本番である
LLMOps運用は、モデルを公開して終わる作業ではありません。本番後のDay 2では、品質劣化、検索データ更新、モデル提供元の変更、コスト急増、セキュリティイベントに対し、観測結果から安全に対応します。
日次ではアラート、失敗トレース、上位コスト要求を確認します。週次では評価セットの回帰結果と利用者の低評価をレビューし、月次ではSLO、エラーバジェット、アクセス権限、保存期間を見直します。
障害時のRunbookには、影響確認、トレース検索、直近変更の照合、モデルまたはプロンプトのロールバック、利用者告知までを記載します。手順を事前合意すれば、属人的な判断を減らせます。
- 日次:異常、失敗要求、費用上位の確認
- 週次:回帰評価、利用者評価、改善課題の整理
- 月次:SLO、権限、保存方針、容量の見直し
変更は小さく配信し、必ず戻せるようにする
モデル、検索インデックス、ツール、プロンプトの変更は、段階配信とロールバックを前提に実施します。大きな変更を一斉反映すると、品質低下の原因がモデルなのかデータなのかを切り分けにくくなります。
配信比率を5% → 25% → 100%と上げる方法なら、各段階で品質、遅延、費用、安全イベントを比較できます。重大な逸脱があれば、直前のバージョンへ戻す判断を迅速に行えます。
OpenTelemetryやOpenInferenceの属性設計を利用し、プロンプト版、モデル名、検索コーパス版、ガードレール版をトレースへ残します。再現可能な記録が、変更承認と事後検証の根拠になります。
- 変更単位ごとに識別子と承認者を残す
- 段階配信中は対照群との比較を行う
- ロールバック条件をリリース前に合意する
役割分担と承認ゲートを明確にする
安定したLLMOps運用には、開発者だけでなく、業務部門、SRE、セキュリティ、法務の連携が必要です。回答品質を判定できるのは業務部門であり、可用性と復旧を担うのは運用担当というように、責任は分かれます。
開発者は計測実装とテスト、業務部門は評価基準と例外判断、SREはSLOとインシデント運用、セキュリティ担当はデータ保護と権限設計を持ちます。責任者を曖昧にしないことが重要です。
ALION株式会社のように専属チームで伴走する開発体制では、実装側と利用側の認識差を短いレビューサイクルで埋められます。海外チームを含む場合も、監査証跡と承認経路を共通化すると運用品質を保ちやすくなります。
- 業務部門:正解基準、例外、受入判定
- 開発・SRE:計測、配信、復旧、性能改善
- セキュリティ・法務:権限、保管、監査、利用条件
AIコスト管理を品質を落とさず実行する
AIコスト管理は要求単位で原価を追う
AIコスト管理では、月額請求額だけではなく、利用者要求ごとの原価を追跡します。入力・出力トークン、モデル単価、再試行、検索、ツール実行、キャッシュヒットをトレースへ紐付けると、費用の原因を説明できます。
同じ機能でも、長いコンテキスト、出力上限、失敗後の再試行が重なると原価は急増します。特定のプロンプト版や利用部門に偏りがないかを確認し、費用を品質指標と並べて判断します。
例えば高性能モデルを全要求に使うのではなく、難易度やリスクに応じてルーティングします。誤答の修正に人手がかかる業務では、単価が低いモデルだけを選ぶことが必ずしも節約になりません。
- 要求ごとにトークン、モデル、再試行、ツール費を記録する
- 費用は部門・機能・プロンプト版で配賦する
- 品質低下による手戻りコストも評価対象に含める
LLMコスト最適化は無駄な処理から着手する
LLMコスト最適化の最初の手段は、モデルを安価なものへ一律変更することではありません。重複要求のキャッシュ、不要なコンテキストの削除、回答上限の調整、失敗時の再試行制御から着手する方が、品質を守りやすい方法です。
削減効果は処理内容に依存しますが、キャッシュやコンテキスト制御は50% Cost Leverとして扱える重要な改善領域です。改善前後は、費用だけでなくFaithfulnessと完了率が悪化していないか確認します。
一部の調査では、生成AIの費用が$1Mから$1.5Mへ膨らむ要因として、利用増だけでなく非効率な呼び出しが問題になります。$150.00の小さな異常支出も、継続すれば予算超過の兆候です。
- キャッシュは正規化した質問と権限条件を考慮する
- コンテキストは関連文書だけを選択する
- 再試行は回数・間隔・フォールバックを制御する
モデル選択は性能・費用・リスクで分ける
モデル選択では、全機能を同じモデルに統一する必要はありません。要約、分類、抽出、複雑な推論を分け、品質要件と安全要件に合うモデルを評価して選ぶことが、費用と性能の両立につながります。
たとえばGPT-5.2のような高性能モデルを難問や最終検証に使い、定型処理には軽量な候補を使う設計があります。ただしルーティングの誤判定は品質事故になるため、判断理由をトレースに残します。
新規のお客様には、Google Cloud で使用できる無料クレジット $300 分を差し上げます。検証環境では、$300 分の無料クレジットと 20 以上の無料枠プロダクトを活用して、Google Cloud で構築を開始しましょう。
- 機能別に必要な精度、遅延、根拠性を定義する
- モデル切替の判断と評価結果を保存する
- 検証費用と本番費用を別の予算として管理する
プロンプト管理と安全監視を統合する
プロンプト管理は本番品質を守る変更管理である
プロンプト管理は、文章を保管する作業ではなく、本番品質を維持するための変更管理です。システム指示、テンプレート、変数、ツール定義、出力形式を版として扱い、どの要求に使われたかを追えるようにします。
変更時は、目的、担当者、レビュー結果、評価セット、想定リスクを記録します。これにより、回答品質が急に変わった際に、モデル更新とプロンプト更新のどちらが原因かを短時間で切り分けられます。
プロンプト管理とLLM可観測性を接続すれば、各版の関連性、拒否率、トークン量、ユーザー評価を比較できます。優れた文面に見えても、コストや安全性を悪化させる版は本番採用すべきではありません。
- プロンプトをコードと同様にバージョン管理する
- 版ごとに評価結果、承認者、配信状況を残す
- モデル・検索設定・ツール定義も同時に識別する
安全監視では入力・出力・実行を分けて守る
安全なAI運用監視では、プロンプトインジェクションを入力だけの問題と考えません。危険な指示の受信、機密情報を含む出力、過剰な権限でのツール実行を別々に検知し、各段階で止める必要があります。
入力では攻撃的な命令やデータ持ち出し要求を検査します。出力ではPIIや機密情報、差別的・有害な表現を確認し、実行前にはツールの引数、対象リソース、利用者権限を検証します。
監査証跡には、生の個人情報を無制限に保存してはいけません。マスキング、アクセス制御、保持期間、削除手順を定め、調査に必要な最小限の情報だけを保持することが信頼につながります。
- 入力:インジェクション、脱獄、機密指示を検査する
- 出力:PII、有害性、根拠のない断定を検査する
- 実行:ツール権限、引数、対象範囲を検査する
観測結果を改善サイクルへ確実に戻す
AI運用監視の価値は、ダッシュボードを見ることではなく、観測結果を改善へ戻すことにあります。失敗トレースを優先度順に分類し、データ、検索、プロンプト、モデル、ツールのどこを直すべきか決めます。
利用者評価が78%にとどまる場合、全体平均だけで結論を出してはいけません。部署、質問種別、プロンプト版、検索結果の有無に分解し、品質低下が集中する条件を探す必要があります。
改善後は再び評価セットと段階配信で確認します。特に1-5%の失敗でも、高リスク業務に偏れば重大です。LLMOps監視、AIモデル監視、LLMコスト最適化を一つの改善ループに置くことが継続運用の要点です。
- 失敗を重要度・頻度・原因で分類する
- 改善案を評価セットと配信計画に反映する
- 高リスクの少数失敗は平均値とは別に扱う
まとめ
LLM可観測性は、生成AIを「動いている」状態から「品質、費用、安全性を説明しながら改善できる」状態へ進める基盤です。MELTと分散トレースで処理全体を結び、LLMOps運用の定例作業、AIコスト管理、プロンプト管理へ観測結果を戻すことで、安定したサービス運用が可能になります。
要点
- LLM可観測性では、回答品質とシステム稼働を同時に観測する。
- LLMOps監視のKPIは、技術値ではなく業務成果から設計する。
- コストはトークン量だけでなく、再試行、検索、ツール実行まで要求単位で把握する。
- プロンプト、モデル、データの変更には評価・段階配信・ロールバックを組み込む。
- 安全監視は入力、出力、ツール実行の三層で実施する。
まずは重要な1ユースケースを選び、要求ID、プロンプト版、モデル名、トークン量、評価結果を同じトレースに記録するところから始めましょう。ALION株式会社のような伴走型の開発チームと、業務部門を含めた評価・運用体制を設計すれば、可観測性を実際の改善成果へつなげやすくなります。
よくある質問
Q1. LLM可観測性と通常のAPMは何が違いますか?
APMはサービスの可用性、遅延、エラーを主に扱います。LLM可観測性はさらに、プロンプト、モデル、RAG検索、生成結果、品質評価、トークン費用を一つの要求単位で関連付けて分析します。
Q2. LLMOps監視で最初に取るべきデータは何ですか?
要求ID、利用者または匿名化したセッションID、プロンプト版、モデル名、入出力トークン、レイテンシ、エラー、検索・ツール実行結果、評価スコアを優先します。個人情報や機密情報はマスキングして保存します。
Q3. LLMコスト最適化で品質を下げない方法はありますか?
キャッシュ、コンテキスト削減、出力上限、再試行制御から始めます。その上で処理難易度に応じたモデルルーティングを行い、Faithfulness、完了率、利用者評価を削減前後で必ず比較します。
Q4. プロンプト管理はなぜ必要ですか?
プロンプト変更は回答品質、費用、安全性に影響します。版番号、変更理由、評価結果、承認者、配信範囲を記録すれば、不具合時に原因を特定し、以前の版へ安全に戻せます。
Q5. RAGの品質が悪いときはどこを確認しますか?
質問の解釈、検索クエリ、取得文書の関連性、文書権限、再ランキング、引用箇所、生成回答のFaithfulnessを順に確認します。検索失敗と生成失敗を分けて計測することが重要です。
参考文献・出典
[Artificial Intelligence](https://www.ibm.com/jp-ja/think/artificial-intelligence)…
www.ibm.com
[Skip to content](#rhdc-main-content) ## ナビゲーション メニュー Explore Red Hat AI * ### 概要 + [AI に関するニュース](/ja/blog/channel/artificial-intelligence) +…
www.redhat.com
…
www.truefoundry.com