2026.10.13
GPUコスト削減を実現する運用設計の実践法
IT関連
GPUコスト削減は、安いGPUへ単純に乗り換えるだけでは実現しません。処理時間、GPU使用率、モデル品質、運用工数までを同時に測り、ワークロードごとに最適な実行方法を選ぶことが重要です。
生成AIの利用量が増えるほど、GPU料金、API課金、ストレージ、監視、再試行の費用は複雑に積み上がります。特に学習・リアルタイム推論・夜間バッチを同じ基準で扱うと、性能不足と過剰投資が併存しやすくなります。
本記事では、右サイジング、Spot活用、LLMコスト最適化、AIコスト管理、オンプレLLMとローカルLLMの選択、AI運用保守の仕組みを順に整理します。削減額だけでなく、品質と可用性を守る判断基準も紹介します。
GPUコスト削減の出発点は利用実態の把握
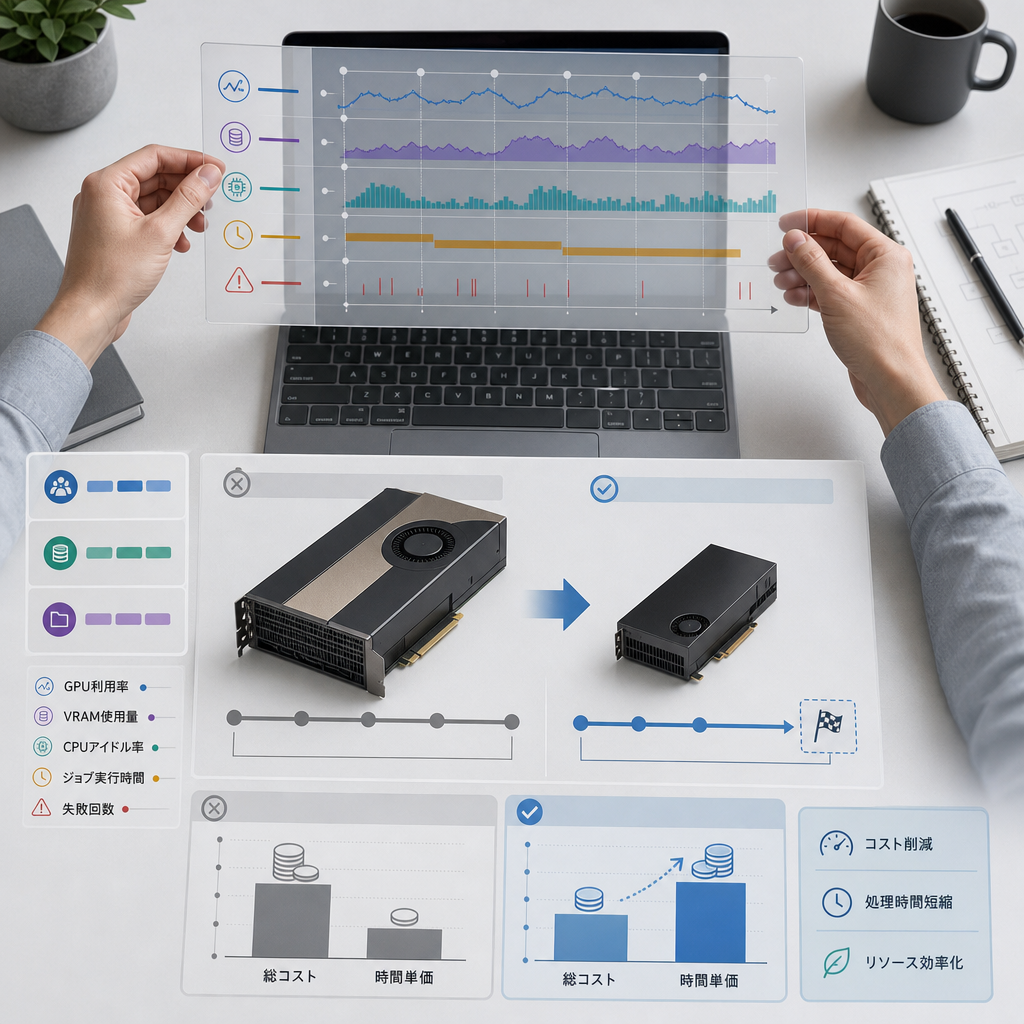
最初に測るべき指標を固定する
GPUコスト削減の第一歩は、請求額ではなく利用実態を可視化することです。GPU使用率、VRAM使用量、CPU待機、ジョブ時間、失敗回数を同じ時間軸で記録すると、過剰なインスタンスと遅い処理の両方を見つけられます。
GPU使用率が常時30%以下であれば、より小さいインスタンスへの変更を検討できます。ただし平均値だけでは判断せず、ピーク時のVRAM不足、キュー滞留、レイテンシの99パーセンタイルも確認することが欠かせません。
部署・用途・プロジェクトの3単位でタグを統一すると、誰のどの機能が費用を生んだかを追えます。GPU時間だけでなく、入力・出力トークン、再試行回数、キャッシュヒット率を結び付ける設計が有効です。
- GPU・CPU・VRAMの使用率を同時に取得する
- ジョブ、モデル、利用部門に共通タグを付ける
- 品質、応答時間、単価を同じ画面で確認する
料金単価でなく処理完了までの費用を見る
インスタンス選定は時間単価ではなく、処理完了までの総額で比較します。g4dn.xlarge: `$0.71/h` と m5n.xlarge: `$0.3/h` の差だけでは、GPU処理の速さや待機時間を含む実費は判断できません。
たとえば、低スペックのインスタンスで100時間かかる学習が、P4dなら40時間で終わる場合、トータルの請求額はP4dの方が少なくなります。性能が高い構成ほど高額とは限らない点が、選定の重要なポイントです。
比較表には、計算料金に加え、データ転送、EBS、ログ、イメージ取得、エンジニアの監視時間を含めます。とくに起動待ちが10分 以上になる環境では、GPU料金以外の損失も無視できません。
| 比較軸 | 低価格CPU中心構成 | GPU高速構成 |
|---|---|---|
| 時間単価 | `$0.3/h` | `$0.71/h` |
| 向く処理 | 軽量前処理 | 並列推論・学習 |
| 主な判断軸 | 待機時間 | 完了までの総額 |
| 見落としやすい費用 | 長い処理時間 | ストレージ・並列効率 |
- 1ジョブ当たりの完了時間と成功率を測る
- ストレージと転送費を計算対象に含める
- 待機時間を利用者の業務コストとして扱う
隠れたインフラ費用を月額に換算する
GPU料金だけを削っても、周辺インフラが膨らめば総コストは下がりません。保存先、ネットワーク、監視ログ、コンテナレジストリ、ライセンス、人件費を月次の原価へまとめることで、優先順位を誤らずに済みます。
EBSでは、gp2からgp3へ移行し、必要性能に合わせて設定を見直す方法があります。`125MB/s` から `275MB/s` のようにスループットを設計し直すと、I/O待ちが短くなり、GPUがデータ待ちで遊ぶ時間を抑えられます。
コンテナ起動、モデル重みの配布、依存パッケージの取得も測定対象です。キャッシュ設計の改善で4分短縮できる場面では、短縮分が日次ジョブやオートスケールの台数に連鎖して効いてきます。
- GPU、保存、通信、ログ、人件費を一つの原価表に集約する
- I/O待ちとコンテナ起動時間を計測する
- 毎月の固定費と処理量に連動する変動費を分ける
ワークロード別にGPUと契約方式を選ぶ
中断できる処理はSpotを前提に組み立てる
再実行可能な学習やバッチ推論は、Spotインスタンスを第一候補にできます。スポット=40〜70%安い。ため、処理の締切に余裕があり、中断から再開できるジョブでは費用対効果が高くなります。
AWS SpotインスタンスはAWSの未使用EC2容量を利用する仕組みで、オンデマンド価格から90%割引になる場合があります。一方で、Spotインスタンスは需要が高まるとAWSから2分前通知で中断されることがあります。
そのため、S3へのチェックポイント保存を数十分ごとに行う設計にしておくと、中断時の損失を最小化できます。ジョブを小さく分割し、再開位置、入力データ、乱数シードを残すことが実務的です。
- 締切が厳しいAPI処理をSpot専用にしない
- チェックポイントと再開手順を自動化する
- 中断率と再試行費用を削減額と併記する
予約は安定した基礎需要だけに適用する
リザーブドインスタンスやSavings Plansは、継続的に使う最低需要に限定するのが安全です。季節変動やPoCの増減を含む全量へ予約を当てると、未使用時間が固定費として残るリスクがあります。
まず過去の稼働ログから、毎日止まらずに動く推論基盤、定例バッチ、開発環境を分けます。そのうえで基礎部分は予約、変動部分はオンデマンドまたはSpotという組み合わせを検討します。
AWSはNVIDIA GPU高速インスタンスの料金を45%引き下げると発表しています。価格改定や新世代GPUの登場は契約後の相対価格を変えるため、長期コミット前に更新時期と移行コストを確認しましょう。
- 最低稼働量を予約対象として見積もる
- 変動需要には柔軟な調達方式を残す
- 契約前に新機種への移行条件を確認する
アイドル停止を例外なく自動化する
開発環境の自動停止は、最も再現性が高いGPUコスト削減策です。利用者の善意に任せず、無通信、ジョブなし、GPU使用率低下の条件で停止候補を通知し、承認後に停止する仕組みを作ります。
停止基準は一律にせず、実験中の長時間学習、データ転送中、デモ環境を除外します。誤停止を避けるには、所有者、目的、停止可能時間、再開手順をリソースタグとして保持することが有効です。
CloudWatch、AWS Batch、SageMakerなどでイベントを拾い、未使用インスタンスの検知から停止、通知、月次報告までをつなげます。削減額と停止件数を共有すると、開発者にも運用ルールが定着します。
- 未使用判定にGPU利用率とジョブ状態を使う
- 停止前に所有者へ通知して猶予を設ける
- 例外リストを定期的に棚卸しする
LLMコスト最適化は品質ゲートと一体で進める
モデルルーティングで高性能モデルの乱用を防ぐ
LLMコスト最適化では、全リクエストに最大モデルを使わないことが基本です。分類、要約、抽出、複雑な推論を分け、難易度と失敗時の影響に応じてモデルを振り分けると、品質を保ちながら支出を抑えられます。
Claude Sonnet 4.5 は 100 万トークンあたり $3/$15 (入力/出力)、Claude Haiku 4.5 は $1/$5 です。簡単な前処理を軽量モデルへ移すだけでも、出力が長い用途では請求差が大きくなります。
ルーティング導入時は、品質ゲートとフォールバックを必ず用意します。軽量モデルの回答が信頼度基準を下回った場合だけ上位モデルへ再送し、評価データで正答率、遅延、単価を継続比較します。
- タスク難易度と失敗の影響でモデルを分類する
- 低信頼の応答だけ上位モデルに切り替える
- モデル別に品質・トークン・単価を記録する
トークンとコンテキストを削る
入力トークンの削減は、モデル変更なしで着手できるLLMコスト最適化です。会話履歴を無制限に渡さず、要約、重要情報の抽出、RAG検索結果の絞り込みを組み合わせると、不要なコンテキストを減らせます。
主要モデルではキャッシュ読み出しが通常の入力料金の2.5〜10%に設定されています。定型システムプロンプトや頻出文書をキャッシュ対象にし、同じ入力を毎回送らない設計にすると効果を測りやすくなります。
エージェントでは、失敗したツール呼び出しや無限に近い再試行ループが隠れた費用になりがちです。最大ターン数、タイムアウト、ツール別の予算を設定し、異常なトークン増加は即座に止めるべきです。
- 会話履歴を要約して必要部分だけ再利用する
- RAGの検索件数と文書長に上限を設ける
- エージェントにターン数と予算の上限を付ける
量子化は精度試験を通して本番へ入れる
量子化はVRAMと推論費用を大きく減らせますが、用途別の評価なしに採用すべきではありません。FP32 → FP16 量子化: メモリ半減、精度ほぼ維持という特性は、多くの推論基盤で最初に検証する価値があります。
FP32 → INT8 量子化: メモリ4分の1、推論速度向上が期待できます。INT8 で約 50%、INT4 で約 75%のメモリ削減を見込める一方、固有名詞、数値、専門判断などの評価セットで品質変化を確認します。
イント4/8 BitsAndBytesやvLLMを使用する場合、推論は2〜4倍安価です。詳細な圧縮方式は、AIモデル圧縮と推論設計の解説も参照し、ロールバック可能な段階導入にしてください。
- 代表業務ごとに品質評価セットを作る
- 量子化前後でVRAM、TPS、正答率を比較する
- 問題発生時に元モデルへ戻せる構成にする
AIコスト管理で削減効果を事業成果へ結び付ける
AI支出を利用者と成果にひも付ける
AIコスト管理では、請求額を集めるだけでなく、利用者と事業成果まで追跡します。FinOpsチームの98%が現在AI支出を管理しています。AIは現在、テクノロジー支出全体の平均17.6%を占めています。
年間830億ドル超のクラウド支出を代表する約1,200人の実務者への調査では、回答者の79%が過去12か月にAI関連のコスト超過を経験しています。予算超過は技術課題であると同時に、可視化と責任分担の課題です。
モデル、APIキー、GPUクラスタ、顧客テナントを共通IDで結びます。これにより、機能別の原価、顧客別の粗利、部署別の利用量を確認でき、単なる利用制限ではない改善判断が可能になります。
- 利用ログと請求データを共通IDで結合する
- 部門別ではなく機能・顧客別の原価も見る
- コストと業務成果を同じレビューで扱う
予算アラートを段階的な制御につなげる
予算超過への対応は、通知だけで終わらせず制御ルールに変換します。AIコストを±10%の精度で予測できている企業は15%にすぎません。予測誤差を前提に、日次の異常検知と月次の見直しを併用します。
アラート後の行動は、優先度に応じて定めます。まずキャッシュ有効化やバッチ化を行い、次に軽量モデルへ切り替え、最後にレート制限や人手承認へ移る段階設計なら、急な停止を避けられます。
予算には20-30%のバッファーを持たせ、実験費と本番費を分けます。新機能の評価が本番予算を圧迫しないよう、プロジェクト単位の上限と例外申請の責任者を明確にしましょう。
- 日次の異常検知と月次の予算レビューを分ける
- 制御はキャッシュ、モデル変更、制限の順に段階化する
- 実験用の予算枠を本番原価と分離する
削減率よりユニットエコノミクスで評価する
良いAIコスト管理は、削減率ではなく1件の成果を出す原価で評価します。モデル選択だけで同一モデルファミリー内のトークン単価が10倍から20倍変わることもありますが、安価でも再試行が増えれば得策ではありません。
評価指標は、問い合わせ1件、要約1本、帳票1枚などの単位で設定します。そこに品質合格率、応答時間、エスカレーション率、売上や工数削減を重ねると、費用だけを理由に品質を落とす失敗を防げます。
具体的には「議事録作成が週3本楽になった」のように、利用者が得た成果も記録します。原価、利用量、品質、業務効果を週次で見直せば、改善対象を感覚ではなくデータで選べます。
- 業務成果1単位当たりの原価を定義する
- 再試行と人手確認も原価に含める
- 品質と生産性の両方に下限を設ける
オンプレLLMとローカルLLMを選ぶ基準
オンプレLLMは高い稼働率とデータ要件で判断する
オンプレLLMは、常時利用される予測可能な負荷と厳格なデータ要件が重なる場合に検討価値があります。月額GPU料金との比較だけではなく、購入費、保守、電力、冷却、ラック、ネットワーク、障害対応を含む総保有コストで判断します。
企業の61%がAIワークロードをパブリック/プライベート双方のインフラで運用しています。したがって、オンプレLLMかクラウドかの二択ではなく、機密処理を社内、変動負荷をクラウドへ置く分担が現実的です。
導入前には、必要な同時実行数、モデルサイズ、許容停止時間、データ持ち出し条件を文書化します。低稼働のまま専用GPUを持つと、クラウドより高コストになるため、将来需要だけで設備を決めないことが重要です。
- 設備費だけでなく電力・冷却・保守を原価化する
- 機密性と稼働率を主要な判断軸にする
- 変動負荷はクラウドへ逃がす設計を残す
ローカルLLMは用途を限定して小さく始める
ローカルLLMは、定型的で閉じた業務から始めると評価しやすくなります。文書の分類、短い要約、社内検索の下処理などは、外部APIに送るデータを減らしながら、応答品質と必要GPUを検証しやすい領域です。
30Bや70Bのようなモデル規模では、量子化、並列化、VRAM容量の条件が構成を大きく変えます。8個や16個のGPUを前提にする前に、小型モデルで業務要件を満たせるかをベンチマークしてください。
ローカルLLMの利点はデータ統制だけではありません。プロンプト、検索、モデル、推論基盤を一体で調整できるため、頻出タスクに特化した速度と原価の改善余地を持てます。
- 定型・低リスクの業務から検証する
- モデル規模より業務品質を先に評価する
- GPU台数は同時実行数とレイテンシから逆算する
ハイブリッド構成は切り替え条件を先に決める
ハイブリッド構成では、どの条件でクラウドと社内基盤を切り替えるかを事前に決めます。通常はローカルLLMで処理し、複雑な推論、急増時、長いコンテキストだけ外部モデルへ送る方法が代表的です。
切り替えには、データ分類、応答時間、品質スコア、予算残高を使います。社内処理が混雑したときに無制限でクラウドへ逃がすと、費用が見えなくなるため、上限額と承認フローを設けます。
また、同じ評価セットを両環境で定期実行します。精度、TPS、障害率、1件当たり原価を並べることで、オンプレLLMの固定費が利用量に見合うかを継続的に判断できます。
- クラウドへ送れるデータの条件を定義する
- 切り替え時の予算上限を設定する
- 両環境を同じ評価セットで比較する
AI運用保守で削減策を継続的に機能させる
監視はコストだけでなく品質劣化も検知する
AI運用保守では、コスト上昇と品質低下を同時に検知する必要があります。量子化、モデルルーティング、キャッシュは費用を下げますが、回答精度やレイテンシを悪化させる可能性があるため、片方だけの監視では不十分です。
最低限、GPU使用率、GPUメモリ、キュー長、トークン数、エラー率、再試行率、回答評価を収集します。急な単価上昇が、トラフィック増なのか、無駄なループなのか、品質低下による再実行なのかを切り分けられます。
しきい値はサービス別に設定します。夜間バッチと顧客向けAPIでは許容遅延が異なるため、同一のアラート基準にすると、重要な異常が通知の山に埋もれてしまいます。
- 費用、品質、遅延、失敗率を同時に監視する
- APIとバッチで異なるしきい値を設ける
- 異常時に原因を追えるリクエストIDを残す
変更は小さく出し、必ず切り戻せるようにする
コスト最適化の変更は、段階リリースと切り戻しを前提に行います。新しい量子化モデル、推論サーバー、Spot比率、キャッシュ設定を一度に変えると、費用変動や品質劣化の原因を特定できません。
本番の一部トラフィックでA/B比較を行い、品質合格率、応答時間、GPU使用率、1件当たり原価を測ります。精度低下 2% 未満で最大 75% のコスト削減のような成果も、業務固有の評価で再現できて初めて採用できます。
設定、モデル重み、プロンプト、評価データの版を記録し、異常時は前の構成へ戻せるようにします。AI運用保守の成熟度は、新技術を入れる速さより、安全に戻れる速さで決まります。
- 一度に変える要素を一つに絞る
- 品質・遅延・原価の合格基準を先に定める
- 設定とモデルのバージョンを保存する
外部パートナーも含めて責任分界を整える
AI運用保守を外部へ委託する場合も、コストの責任分界を曖昧にしないことが重要です。誰が利用量を監視し、誰が障害時にモデルを切り替え、誰が予算超過を承認するかを、運用手順に明記します。
内製と外注を比べる際は、開発費だけでなく、GPU調達、監視設定、障害対応、評価更新、セキュリティ確認に必要な時間を比べます。専属チームと伴走する開発体制なら、技術課題と業務要件を同時に整理しやすくなります。
月次レビューでは、削減額、品質事故、停止時間、未使用資産、次月の負荷予測を確認します。改善を一過性の施策にせず、プロダクト、開発、経理、運用が同じ数字を見る場を持つことが継続の鍵です。
- 予算、障害、品質の責任者を明文化する
- 委託費にも監視・保守・改善工数を含める
- 月次レビューで削減と品質の両方を確認する
まとめ
GPUコスト削減は、低価格なGPUを探す作業ではなく、利用率、処理時間、品質、運用工数を最適化する継続活動です。ワークロード別の調達、モデルの使い分け、可視化、停止自動化を組み合わせることで、無駄を減らしながらAI機能の価値を守れます。
要点
- GPUの時間単価ではなく、処理完了までの総コストで比較する
- Spot利用はチェックポイントと再開設計をセットで実施する
- LLMはルーティング、キャッシュ、量子化を品質評価と共に導入する
- オンプレミスとクラウドは稼働率、機密性、変動負荷で使い分ける
- AI運用保守では費用・品質・遅延を同じ監視基盤で扱う
まずは直近1か月のGPU利用を、プロジェクト、処理種別、モデル単位で棚卸ししてください。アイドル停止、過剰スペックの是正、トークン削減から着手し、必要に応じて自社の要件に合う運用設計と開発体制を検討しましょう。
よくある質問
Q1. GPUコスト削減で最初に実施すべきことは何ですか?
GPU使用率、VRAM、処理時間、失敗率、アイドル時間をプロジェクト単位で可視化することです。実測なしで契約やGPUを変えると、性能不足または過剰投資を招きます。
Q2. Spotインスタンスは本番環境でも使えますか?
中断に耐えられるバッチ処理や学習には使えます。チェックポイント保存、再開処理、代替キャパシティ、2分前通知への対応を設計し、停止できないAPI処理は別系統に残します。
Q3. オンプレLLMはクラウドより安くなりますか?
高い稼働率が続き、電力、冷却、保守、人件費を含めても利用量に見合う場合に有利です。変動負荷や短期検証では、クラウドと組み合わせるハイブリッド構成が適します。
Q4. 量子化で品質は必ず下がりますか?
影響の大きさはモデルと業務によります。FP16から検証を始め、数値、固有名詞、専門回答など実際の代表データで精度、遅延、VRAM、原価を評価して採否を決めるべきです。
Q5. AIコスト管理では何を部門別に集計すべきですか?
GPU時間、APIトークン、ストレージ、データ転送、再試行、ツール呼び出し、ライセンス、運用工数を、部署・用途・プロジェクトと共通IDでひも付けます。成果指標も併せて確認します。
参考文献・出典
[Attribute™ at re:Invent, Nov 30 to Dec 4. Bring your unallocated number. See us booth #1662Attribute™ at re:Invent, Nov 30 to Dec 4.…
www.doit.com
[メインコンテンツへスキップ](#main-content) # RouteLLM: LLM(大規模言語モデル)の使用コストを最適化するフレームワーク [![Masaya.Mori 森正弥 / CAIO (Chief AI…
note.com
[](https://keieiax.jp/) SEARCH ## AI経営手帖 サイト内検索 `⌘ K“Ctrl K`開閉 `↵`検索 `ESC`閉じる…
keieiax.jp