2026.11.04
機密情報マスキングで生成AI利用を守る実践設計
IT関連
機密情報マスキングは、生成AIへ渡す前に個人情報や営業秘密を識別・置換し、業務価値を保ちながら漏えいリスクを下げる仕組みです。便利さを優先して原文を貼り付ける運用は、最初に見直すべき対象です。
生成AIの利用範囲は、要約、翻訳、提案書作成、コード生成から社内検索まで拡大しています。一方で、プロンプト、添付ファイル、会話履歴、RAGの検索結果、外部ツール連携には、それぞれ異なる情報流出経路があります。
本記事では、マスキング対象の決め方、方式の選択、生成AI情報漏えいへの備え、RAGアクセス制御、AI権限管理を順に解説します。第1回として、現場で運用できる社内AIガバナンスの土台を作ります。
機密情報マスキングの対象を先に決める
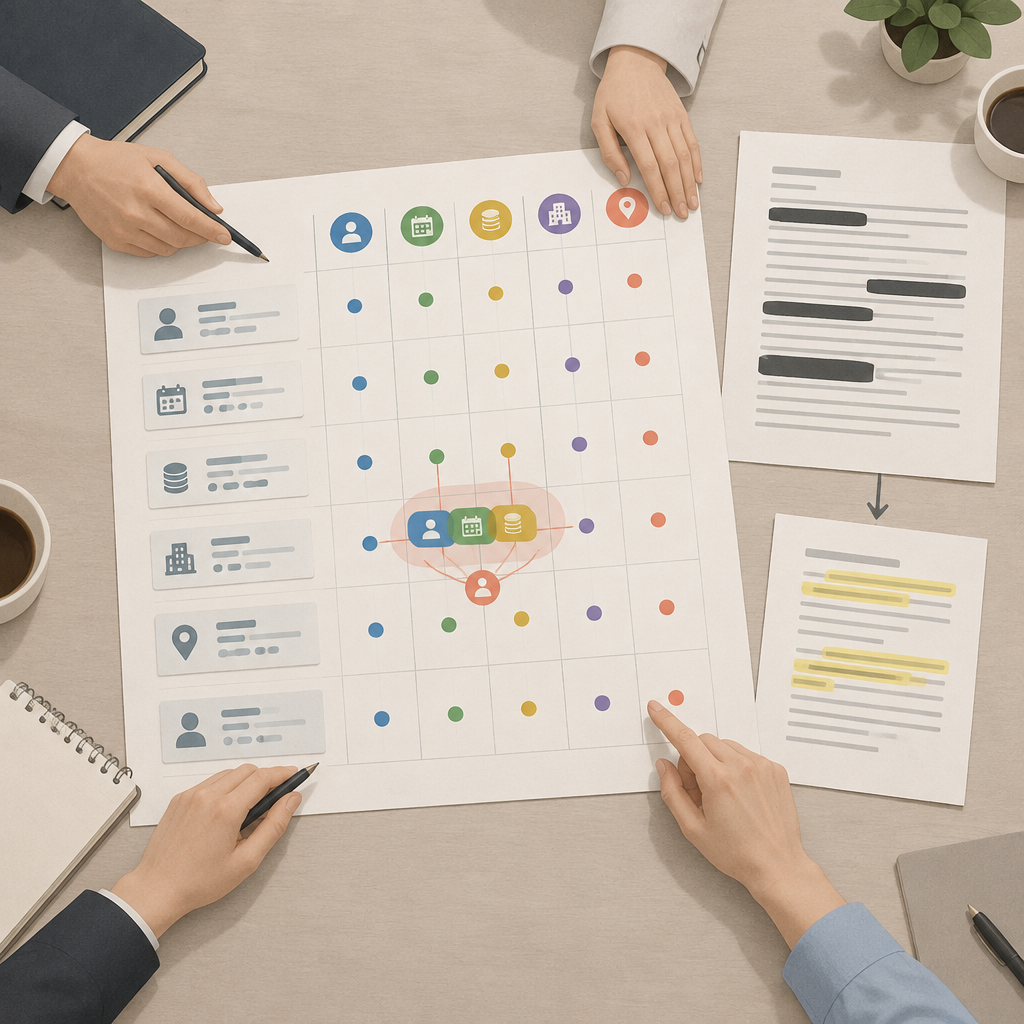
機密情報は単体ではなく組み合わせで判定する
答えは、氏名だけを探すのではなく、再特定できる情報の組み合わせを対象にすることです。顧客名、部署、日時、金額、案件名、地域が重なると、伏せ字があっても誰や何の案件か推測されるおそれがあります。
個人情報、営業秘密、認証情報、未公開の財務情報、ソースコードを台帳化し、入力禁止・条件付き利用・利用可に区分します。電話番号は下4桁だけでも、ほかの属性と結び付けば識別子になり得るため、文脈を含めて評価します。
個人情報保護法やマイナンバー法の対象だけに限定すると、競争上重要な情報を見落とします。法務、情報システム、事業部が同じ分類基準を持ち、データ所有者が最終判断できる体制にすると、現場の迷いを減らせます。
- 個人情報:氏名、住所、連絡先、顔画像、従業員ID
- 営業秘密:価格表、設計図、顧客リスト、研究データ
- 認証情報:APIキー、パスワード、アクセストークン
送信前のデータ最小化を標準にする
答えは、AIに渡す情報を目的達成に必要な最小限まで減らすことです。全文を渡す代わりに、対象段落だけを抽出し、固有名詞と識別子を置換すれば、要約や分類の品質を保ちやすくなります。
たとえば契約書のレビューでは、当事者名を「企業A」「企業B」に、金額をレンジに、担当者名を役割名に変えます。目的が条項の矛盾検出なら、実名や正確な受発注額は通常必要ありません。
マスキングは万能ではありません。元データ、置換対応表、生成された出力も保護対象として扱い、保管場所と閲覧者を分けます。対応表を同じ共有フォルダに置けば、匿名化したつもりでも復元経路を残すことになります。
- 目的ごとに必要な項目を定義する
- 原文と対応表の保管先を分離する
- 送信前後のデータ量を記録する
本文以外の情報も検査対象に含める
答えは、テキスト本文だけでなく、添付物の全要素を検査することです。PDFの注釈、Wordのコメントと変更履歴、Excelの非表示シートやシート名、画像内の文字は、通常のコピー操作では見落とされがちです。
スキャン文書やスクリーンショットではOCRを使い、画像中の氏名、住所、口座情報、QRコードを検出します。音声の文字起こしも、会議参加者名や顧客の発言を含むため、プロンプトと同じ基準で扱う必要があります。
黒塗りの見た目を作る編集と、元データを復元不能にするマスキングは異なります。共有前には別アカウントでファイルを開き、コピー、検索、メタデータ確認を行う検証工程を必ず設けましょう。
- PDF:注釈、レイヤー、メタデータ
- Office文書:コメント、履歴、非表示要素
- 画像・音声:OCR、文字起こし、埋め込み情報
用途に応じて機密情報マスキング方式を選ぶ
静的・動的・オンザフライを使い分ける
答えは、複製データを配るなら静的、閲覧者ごとに表示を変えるなら動的、AI送信直前ならオンザフライを選ぶことです。機密情報マスキングには、静的と動的の2つの基本的な種類があります。
静的方式は、開発、テスト、デモ用に安全な複製を作る用途に向きます。一度処理したデータを配布できる反面、原本の更新を反映する手順と、マスク済みデータの再配布管理が必要です。
動的方式は、同じ原本に対して役割別の表示を制御できます。オンザフライ方式は、生成AIのAPI呼び出し直前に識別子をトークンへ変換し、応答後に許可された利用者だけが復元する設計です。
| 項目 | 静的マスキング | 動的マスキング | オンザフライ |
|---|---|---|---|
| 主な対象 | 複製データ | 業務原本 | AI送信データ |
| 原本更新 | 再作成が必要 | 即時反映 | 送信時反映 |
| 適した場面 | テスト・デモ | 役割別閲覧 | 生成AI連携 |
| 復元性 | 原則不要 | 権限で制御 | 対応表で制御 |
- 静的:テスト環境、外部デモ、分析用複製
- 動的:業務画面、権限別の閲覧制御
- オンザフライ:AI入力、API連携、短時間処理
置換方法は利用目的と復元可否で決める
答えは、分析の一貫性が必要なら仮名化やトークン化、復元が不要なら削除や汎化を選ぶことです。単純に「●●」へ置換するだけでは、同一人物や同一顧客を横断的に追えなくなる場合があります。
仮名化では「顧客A001」のように一貫した代替値を使い、集計や会話の整合性を維持します。トークン化では、元の値を安全な対応表で管理し、必要な承認を得た処理だけに復元機能を限定します。
k-匿名性は、少なくともk-1個の他のレコードと区別できないようにする手法です。ただし、少数の属性でも外部情報と結合すれば再識別されるため、件数だけで安全と判断せず、実データで検証します。
- 削除:不要項目を完全に除去する
- 置換:読みやすさを残して別表記へ変える
- 仮名化・トークン化:対応表により限定復元する
品質と漏れを測定して改善する
答えは、検出精度だけでなく、業務タスクの品質低下と再特定可能性を一緒に測ることです。マスク率が高くても、要約の結論が変わる、コードの依存関係が壊れるなら、実務では利用できません。
検証用データには、日本語の表記ゆれ、全角半角、旧字体、住所の省略、社内略称を含めます。正解ラベルと照合して見逃し、誤検知、過剰置換を記録し、業務部門が結果をレビューする仕組みを作ります。
たとえば環境設定に`gemini-1.5-flash-latest`のようなモデル名があっても、周辺にAPIキーや顧客名が混在していないかを確認します。設定値は公開可能でも、同じファイル全体が安全とは限りません。
- 検出:見逃し率と誤検知率を確認する
- 品質:要約、翻訳、分類、コード生成で試験する
- 安全性:外部情報との結合による再特定を試す
生成AI情報漏えいを入力から出力まで防ぐ
漏えいの原因を二つに分けて対処する
答えは、利用者がAIへ入力して起こる漏えいと、AIを悪用した攻撃による侵害を分けることです。前者はマスキング、利用ルール、契約条件が中心であり、後者は脆弱性管理、監視、インシデント対応が中心になります。
生成AI情報漏えいでは、個人アカウントへの契約書貼り付け、会議録の添付、ソースコード送信が代表的な事故経路です。会話履歴、アップロード済みファイル、外部連携先に何が残るかを、サービスごとに確認します。
攻撃面も急速に広がっています。AIを活用した攻撃活動が前年比で89%増加したとされ、検知された攻撃の82%が、マルウェアを使わない手口だったとされています。入力対策だけで満足せず、IDとログの監視を組み合わせます。
- 入力起因:利用者、設定、契約、マスキング
- 攻撃起因:脆弱性、認証情報、外部連携、監視
- 共通基盤:資産台帳、ログ、通報窓口、訓練
入力と出力の両方にガードレールを置く
答えは、入力フィルターで送信を止め、出力フィルターで再出力や指示漏えいを止める二段構えです。入力側ではPII、秘密鍵、マイナンバー、機微な案件名を検知し、理由と代替操作を利用者に示します。
出力側では、回答に含まれる個人情報、権限外の検索結果、危険な操作指示を確認します。プロンプトインジェクションによって、文書内の悪意ある命令がシステム指示を上書きしないよう、信頼境界を明確にします。
OWASPがまとめた「OWASP Top 10 for LLM Applications 2025」でも、1番目(LLM01)にプロンプトインジェクションが置かれました。モデルの回答をそのまま実行せず、ツール呼び出し前に権限と対象データを再判定します。
- 入力:PII・秘密情報・認証情報の検知
- 出力:権限外情報と危険な指示の遮断
- 実行:人の承認と対象範囲の再確認
発見時に証拠を消さずに初動する
答えは、会話を削除する前に事実を保全し、影響範囲を切り分けることです。利用者、情シス、法務、データ所有者の連絡先を定め、プロンプト、出力、添付、時刻、アカウント、共有先を記録します。
生成AI情報漏えいが疑われる場合は、該当アカウントや連携トークンを必要最小限で停止し、同様の操作がないかログを確認します。対応表を使ったマスキングなら、対応表への不正アクセスも同時に調査対象です。
脆弱性公開後の対応も重要です。88%は公開から48時間以内に起きていましたという分析があるため、AI連携基盤の依存ライブラリ、コネクター、ブラウザ拡張を資産台帳で追跡し、優先度順に更新します。
- 保全:プロンプト、出力、添付、操作ログ
- 封じ込め:アカウント、トークン、連携先の停止
- 調査:対象者、公開範囲、再発経路の特定
RAGセキュリティは検索結果の前に守る
RAGアクセス制御を検索時に強制する
答えは、文書登録時だけでなく、検索・再ランキング・回答生成の各段階で権限を確認することです。RAGアクセス制御がなければ、ベクトル検索の類似度だけで、利用者が本来読めない資料を回答に混ぜる危険があります。
文書チャンクには、部署、案件、機密区分、所有者、保存期限、閲覧グループなどのメタデータを付与します。検索クエリを実行する前に、利用者のIDと属性でフィルターし、許可済みチャンクだけをモデルへ渡します。
共有フォルダの閲覧権限を後から外した場合も、RAGのベクトルDBやキャッシュに古い埋め込みが残っていないか確認します。削除、失効、再インデックスを連動させることが、実効性あるRAGアクセス制御の条件です。
- 登録時:機密区分と所有者をメタデータ化する
- 検索時:ID・部署・案件でフィルターする
- 失効時:原文、埋め込み、キャッシュを連動削除する
添付ファイルと外部ツールを信頼しすぎない
答えは、RAGの参照文書を信頼済み命令として扱わないことです。PDFやWebページに「前の指示を無視せよ」といった文字列が含まれていても、それは検索対象のデータであり、モデルの実行命令ではありません。
RAGセキュリティでは、文書の取得元、更新者、ハッシュ値、公開範囲を記録します。外部サイト、メール、クラウドストレージを自動取り込みする場合は、取り込み元ごとに許可リストと検査ルールを設定します。
AIエージェントがメール送信、CRM更新、ファイル共有を行うときは、回答内容と操作権限を分離します。検索できることと、削除・送信できることを同一権限にすると、プロンプトインジェクションの被害が拡大します。
- 取得元の許可リストと改ざん確認
- 検索権限と操作権限の分離
- 外部送信前の人による承認
回答の根拠を追跡可能にする
答えは、回答に使った文書、チャンク、権限判定、モデル出力を相関できるログに残すことです。これにより、誤回答と情報漏えいを分けて調査でき、どの文書の権限設定を直すべきか判断できます。
利用者には、回答の根拠文書名と閲覧範囲を示します。ただし、根拠表示そのものが機密文書名を露出しないよう、権限外の資料は存在も示さない設計が必要です。
評価では、許可された質問に正答できるかだけでなく、権限外の質問に回答しないかを試験します。部門異動、退職、プロジェクト終了など、権限が変わるシナリオを含めて定期検証しましょう。
- 回答と参照文書を相関ログで追跡する
- 根拠表示も閲覧権限で制御する
- 権限外質問に答えない試験を行う
AI権限管理と社内ルールを運用に落とす
AI権限管理は最小権限から始める
答えは、利用者、AIアプリ、RAG、外部ツールに別々の最小権限を設定することです。AI権限管理では、ログインできる人の制御だけでなく、どのデータを検索し、どの操作を実行できるかを分けて定義します。
部署共通の管理者アカウントは、誰が何をしたか追跡できず、退職や異動時の失効も困難です。SSO、多要素認証、個人単位のID、短期トークンを基本にし、特権操作は承認付きにします。
権限レビューは、システム導入時だけでは足りません。組織変更、委託先の入れ替え、データ分類変更に合わせ、利用者権限、サービスアカウント、対応表へのアクセスを定期的に見直します。
- 個人IDと多要素認証を必須にする
- 検索・閲覧・実行の権限を分離する
- 特権操作は承認とログを残す
社内AIルールは迷わない判断基準にする
答えは、「使ってよいツール」と「入力してよい情報」を具体例で示すことです。社内AIルールが抽象的だと、急ぐ現場は自己判断で無料サービスや個人アカウントを使い、統制の外にデータを持ち出します。
ルールには、許可サービス、禁止情報、条件付き利用の承認者、添付可否、ログ保管、事故時の連絡先を明記します。ChatGPTやClaude、Geminiを利用する場合も、契約プランと管理設定によって扱える情報が異なるため、一律許可にはしません。
教育は長い規程を配るより、実際の業務例で行います。契約書要約、顧客メール作成、障害ログ分析などを題材に、どこを機密情報マスキングし、どこから承認を求めるかを演習します。
- 許可ツールと利用アカウントを明記する
- 情報区分ごとの入力可否を示す
- 例外申請と事故連絡の窓口を定める
AIシャドーITを責めずに可視化する
答えは、AIシャドーITを禁止違反として探すだけでなく、現場が必要とする機能を把握して安全な代替手段を提供することです。非公認利用は、承認済み環境の使い勝手や機能不足を示す重要なシグナルでもあります。
プロキシ、CASB、IDログ、端末管理、経費精算を照合し、未承認のAIサービスと個人アカウント利用を把握します。発見後に即時処罰だけを行うと利用が地下化するため、相談と移行の手順を同時に用意します。
AIセキュリティ対策の優先度は、利用頻度、扱うデータ、外部連携、権限の強さで決めます。脅威状況では前年比44%増加という指標も報告されており、資産を把握しない組織ほど対処の順序を誤りやすくなります。
- 通信・ID・端末・購買記録を横断して確認する
- 安全な公式環境へ移行する導線を作る
- 利用実態を社内AIガバナンスの改善に反映する
社内AIガバナンスを継続改善する手順
責任者と承認経路を明確にする
答えは、データ所有者、AI運用者、情報セキュリティ、法務、業務責任者の責任を分けることです。社内AIガバナンスは、情報システム部門だけで完結せず、入力データの価値を知る事業部との共同運用が必要です。
新しいAI機能を導入する前には、利用目的、データフロー、マスキング方式、保存先、委託先、削除方法、障害時の連絡を確認します。特に外部ツール実行を伴うエージェントは、承認者を明確にします。
判断を速くするには、リスク別の標準パターンを用意します。公開情報の要約、マスク済み文書の分析、個人情報を含む処理のように区分し、承認の深さを変えると、統制と業務速度を両立できます。
- データ所有者が利用可否を判断する
- 運用者がログ・設定・障害対応を担う
- 法務とセキュリティが高リスク案件を審査する
監査ログは復元申請まで追える形にする
答えは、入力・出力だけでなく、マスキング処理、対応表へのアクセス、復元申請、承認、廃棄まで記録することです。ログが断片化していると、事故時に誰が原文へ触れたか確認できません。
ログには利用者ID、時刻、アプリ、データ分類、検知ルール、置換結果、検索対象、外部送信先を含めます。ただし、ログ自体に原文の機密情報を残しすぎないよう、参照IDやハッシュを使う設計が重要です。
監査では、マスキング漏れ、過剰なブロック、権限外検索、例外承認の増加を確認します。調査時間を最大80%短縮するには、AI任せにせず、検索可能で改ざん耐性のあるログと担当者の判断を組み合わせます。
- 原文ではなく参照ID中心でログを残す
- 復元には申請・承認・期限を設ける
- 例外利用を定期的にレビューする
小さく試し、測ってから対象を広げる
答えは、最も機密性の低い業務から始め、マスキング精度と業務効果を測って段階的に広げることです。全社展開を先行すると、例外処理や権限設計の不備が大量の利用者に波及します。
最初の検証では、代表的な文書形式、表記ゆれ、添付ファイル、RAG検索、出力の共有までを含めます。利用者が手作業で隠した箇所と自動検出結果を比較し、見逃しと使いにくさを改善します。
ALION株式会社のように開発チームと業務側が伴走する体制では、要件定義の段階からデータ分類と権限モデルを設計できます。AI機能だけを後付けせず、運用、監査、教育を一つの導入計画にまとめることが重要です。
- 低リスク業務で検証を始める
- 精度・品質・運用負荷を同時に測る
- 承認済みパターンを再利用して展開する
まとめ
機密情報マスキングは、単なる伏せ字処理ではありません。対象の特定、送信前の最小化、用途別の置換、RAGアクセス制御、AI権限管理、監査をつなぐことで、生成AIの活用と安全性を両立できます。
要点
- 機密情報は単体ではなく、日時・部署・金額などの組み合わせで判定する。
- 静的・動的・オンザフライ方式を、テスト、閲覧、AI入力の用途に応じて使い分ける。
- RAGでは文書登録時だけでなく、検索時と回答生成時にも権限を強制する。
- 社内AIルールとAIシャドーITの可視化を通じ、現場が安全な環境を選べるようにする。
- ログ、復元申請、例外承認を含めて継続的に改善する。
まずは、現在利用されているAIサービス、入力されているデータ、RAGの参照文書を棚卸ししてください。そのうえで、機密区分ごとの入力可否とマスキング方式を決めれば、実効性あるAIセキュリティ対策の第一歩になります。
よくある質問
Q1. 機密情報マスキングと暗号化の違いは何ですか?
暗号化は鍵を使ってデータを読めなくする技術で、復号すれば原文に戻せます。機密情報マスキングは、利用目的に応じて値を削除・置換・仮名化し、閲覧やAI処理に必要な範囲だけを見せる仕組みです。両方を併用します。
Q2. 生成AIの法人契約ならマスキングは不要ですか?
不要ではありません。法人契約でも、入力可能な情報、保存・削除条件、管理者ログ、外部連携、権限設定を確認する必要があります。最小化とマスキングを基本にし、例外はデータ所有者が承認する運用が安全です。
Q3. RAGで最も重要なセキュリティ対策は何ですか?
検索時に利用者の権限で文書チャンクを絞り込むRAGアクセス制御です。文書登録時のアクセス権だけでは不十分であり、埋め込み、キャッシュ、削除・失効処理まで原本の権限変更と連動させる必要があります。
Q4. AIシャドーITを見つけたら利用をすぐ禁止すべきですか?
影響の大きい利用は即時に停止すべきですが、全面禁止だけでは利用が見えない場所へ移るおそれがあります。利用目的と入力データを確認し、承認済み環境への移行、マスキング、教育、例外申請を組み合わせて改善します。
Q5. マスキングの精度はどのように確認しますか?
氏名だけでなく、表記ゆれ、画像内文字、Office文書のコメント、住所や案件情報の組み合わせを含むテストデータで検証します。見逃し率、誤検知率、要約や検索の品質、再特定可能性を定期的に評価します。
参考文献・出典
 コラムを読む 運営会社・お問い合わせ…
coplus-one.jp
[ダークモード対応について](/help/darkmode.html) [お問い合わせ](/contact/) # 生成AIに渡す前に何を隠すべきか――機密情報マスキングの原則と4つの分類 X-tech推進本部 白 ## AIに送った情報は取り消せない…
www.mitsue.co.jp
[](https://zeal-security.jp/)…
zeal-security.jp