2026.11.07
AI電力消費を抑える実践的な設計と運用
IT関連
AI電力消費は、生成AIを業務に広げる企業が避けて通れない経営課題です。モデルの学習だけでなく、日々増える推論、データ転送、GPU冷却までが料金と環境負荷を積み上げます。
電力を抑える目的は、単純な節電ではありません。応答品質や可用性を守りながら、GPUの稼働率、トークン量、冷却効率、電源の選び方を一体で見直すことが重要です。
本記事では、消費の仕組みを測る方法から、AIモデル圧縮、モデル蒸留、モデルルーティング、AI推論基盤の設計、AIソブリンティまでを実務順に解説します。
AI電力消費はどこで増えるのか
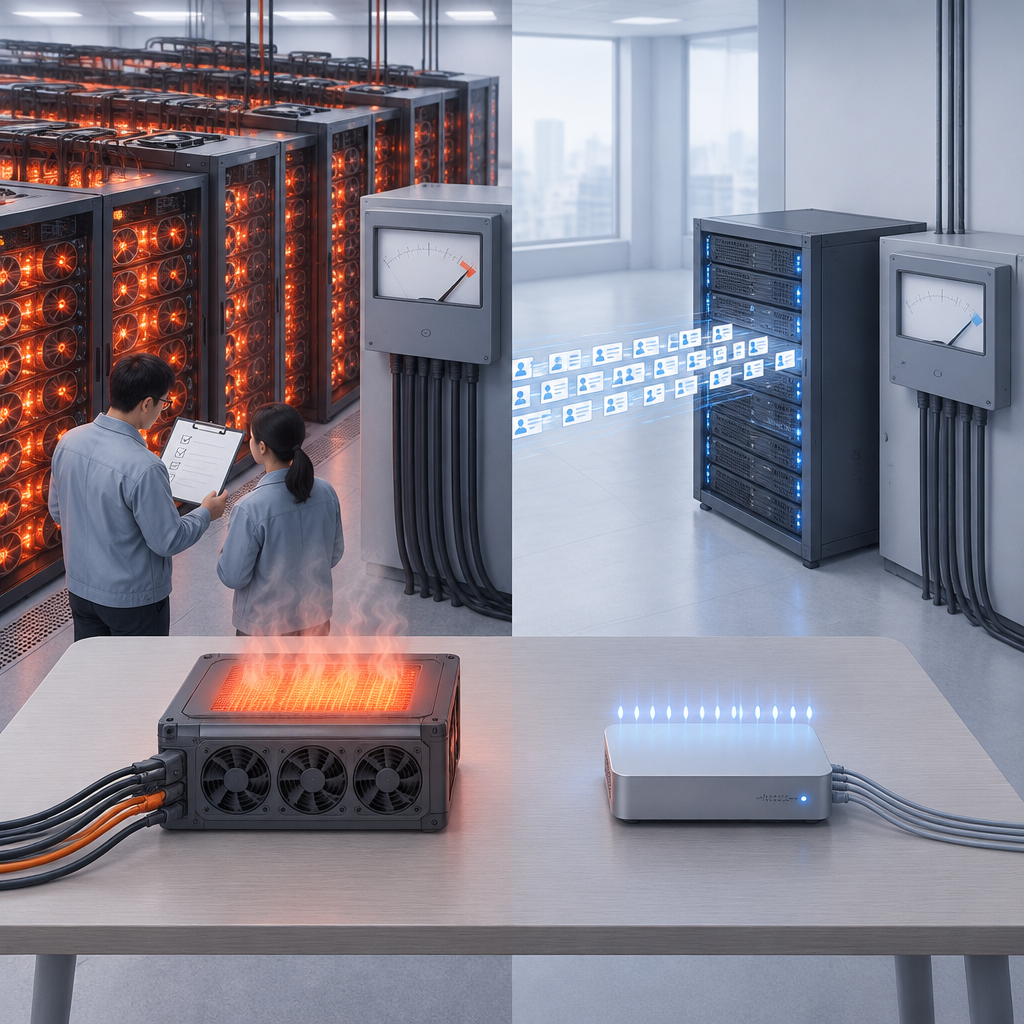
学習と推論を分けて把握する
AI電力消費の内訳は、学習と推論で分けて測ることが出発点です。学習は短期間に大きなGPU群を動かし、推論は小さな処理でも利用回数の増加により継続的な負荷になります。
BLOOMの学習では、消費電力量は433MWh(メガワット時)、排出されたCO2は25tと報告されています。大規模モデルでは、一度の学習ジョブの規模を事前承認する運用が必要です。
GPT-3では、消費電力量は1,287MWh、機械学習時のCO2排出量は502tとされています。自社で基盤モデルを訓練するか、既存モデルを利用するかは、性能だけでなく電力面でも比較すべきです。
- 学習ジョブはGPU時間・電力・排出量を記録する
- 推論はリクエスト数と入力・出力長を継続監視する
- 開発・検証・本番の環境を分けて原価を追う
1回の問いかけにも差が出る
推論時の消費は、モデル規模、入力長、生成量、再試行回数で大きく変わります。1回のChatGPT利用がGoogle検索の約10倍の電力を消費するとされ、用途に応じた使い分けが欠かせません。
Google検索1回が約0.3Whである一方、従来の生成AIモデルでは1回の質問で約2.9Whとされます。要約や分類まで常に最大モデルへ送る設計は、費用と電力の両方を増やします。
テキスト生成が0.03kWhとされる一方、画像生成は平均で約2.9kWhです。画像を何度も生成し直す業務では、プレビュー回数や解像度の上限を製品仕様に組み込むべきです。
- 最大出力トークンに上限を設ける
- 同一質問の再実行をキャッシュで減らす
- 画像生成は段階的な品質確認を採用する
電力だけでなく水と熱を見る
AIの消費負荷は電気料金だけでは測れません。GPUは高い発熱密度を持つため、空調、液冷、蒸発冷却に使う電力と水を含めて、ワークロードの実コストを確認する必要があります。
AI関連の水使用量は、2027年までに年間60億立方メートルに達するという予測があります。水ストレスが高い地域では、冷却方式と取水条件を調達要件に含めることが重要です。
サーバー冷却のための消費電力が約30%削減できる技術もあります。ただし、設備更新だけに頼らず、過剰なGPU割り当てやアイドル時間を減らすことが先決です。
- PUEだけでなく水利用も月次で確認する
- 発熱密度に応じて空冷・液冷を選ぶ
- 地域の電源構成と水制約を立地判断へ反映する
測定から始めるAIコスト管理
リクエスト単位で原価を見える化する
AIコスト管理では、請求書総額だけでなく、1リクエストの原価を追うことが重要です。入力・出力トークン、モデル名、GPU時間、ストレージ、ネットワーク、再試行を同じログに結び付けます。
タグは、事業部、プロダクト、機能、環境、モデル、顧客を最低単位にします。これにより、全社平均では見えない高コスト機能や、利用されない検証環境を特定できます。
FinOps Foundationでは、FinOpsを「Inform」「Optimize」「Operate」の3フェーズで反復的に進める考え方を採用しています。可視化だけで終えず、改善後の効果確認までを月次運用にします。
- API呼び出しに利用者と機能の識別子を付ける
- GPUにはプロジェクト別の課金タグを付ける
- 単価・品質・レイテンシを同じ画面で確認する
予算超過を自動で止める
AIコスト管理の実効性は、予算超過時の行動を決めて初めて高まります。通知だけでは利用が止まらないため、モデル切替、レート制限、承認制、処理停止の順序を事前に定義します。
月10万円かかるAIシステムでも、毎月40万円相当の業務時間を削減できているのであれば、高いROIを生み出している可能性があります。削減額だけでなく、業務価値との比率で判断しましょう。
反対に、月1万円のツールでもほとんど使われていなければ、削減対象になり得ます。利用回数、完了率、手作業削減時間を結び付け、利用者の感覚ではなくデータで継続可否を決めます。
- 日次予算と月次予算を分けて設定する
- 急増時は軽量モデルへ自動退避する
- 責任者と復旧条件を運用文書に明記する
品質を落とさない評価基準を作る
コスト対策は、回答品質を測らずに実行してはいけません。代表的な質問、正解例、禁止回答、許容レイテンシを評価セットとして固定し、変更前後の結果を必ず比較します。
エージェント型の処理では、ツール呼び出し、ループ回数、失敗後の再試行が支出を膨らませます。成功した回答だけでなく、失敗した実行の平均原価もKPIに含めることが大切です。
見積もりでは、見積もり額の30〜40%をバッファとして上乗せすることを推奨します。利用量の変動、モデル料金改定、検証工数を含め、予算に余裕を持たせましょう。
- 精度・完了率・レイテンシの下限を決める
- 失敗リクエストを別に集計する
- プロンプト変更も評価対象として記録する
モデル設計で電力と推論費を下げる
LLMコスト最適化は入力を短くする
LLMコスト最適化で最初に行うべきことは、必要な文脈だけをモデルへ渡すことです。長い会話履歴や検索結果を無差別に投入すると、料金、待ち時間、AI電力消費が同時に増えます。
RAGでは、検索上位文書をそのまま連結せず、重複除去、チャンク上限、再ランキングを組み合わせます。利用者に見せない内部説明やログまでプロンプトへ含めない設計も有効です。
出力形式をJSONなどに固定し、最大トークン数を業務要件に合わせると、冗長な生成を抑えられます。LLMコスト最適化は、モデル変更前にプロンプト設計から着手するのが合理的です。
- 入力文書数とチャンク長の上限を設定する
- 会話履歴は要約して引き継ぐ
- 出力トークンと再試行回数を制限する
AIモデル圧縮とモデル蒸留を使い分ける
AIモデル圧縮は、量子化や剪定でモデルの容量と演算量を減らす手法です。精度検証を前提にすれば、VRAM使用量を抑え、より小さいGPUやCPUで処理できる可能性が生まれます。
モデル蒸留は、大きな教師モデルの振る舞いを小さな生徒モデルへ学習させる方法です。問い合わせ分類、定型抽出、社内文書の要約など、対象業務が明確な領域で特に有効です。
学習時のコストを最大で300分の1、推論コストを最大約70分の1に抑えられるケースがあります。ただし、数値だけで採否を決めず、重要な例外データで精度低下を確認してください。
- 量子化後は業務データで精度を再評価する
- 蒸留対象は頻度の高い定型業務から選ぶ
- 安全性・根拠提示・例外処理を別途検証する
モデルルーティングで大きなモデルを節約する
モデルルーティングは、質問の難易度や機密性に応じて、最適なモデルへ振り分ける仕組みです。すべてを最高性能モデルへ送るより、品質を守りながら電力と単価を下げやすくなります。
例えば、短い分類は小型モデル、一般的な要約は中型モデル、複雑な推論だけを高性能モデルへ送ります。信頼度が低い場合のみ上位モデルへ再送するカスケード方式も実用的です。
モデルルーティングには、誤振り分けを検知する評価が欠かせません。問い合わせ種別、入力長、個人情報の有無、期待品質をルールと判定器の両方で確認すると安定します。
- 難易度別にモデルの合格基準を定める
- 低信頼度時だけ上位モデルへ切り替える
- ルーティング結果と品質を継続評価する
GPUコスト削減につながる推論基盤の設計
GPUコスト削減は稼働率の改善が中心
GPUコスト削減の基本は、安いGPUを探すことではなく、割り当てたGPUを十分に使うことです。使用率が低い原因を、データ読み込み、CPU、I/O、ネットワーク、モデル設定に分けて診断します。
GPUサーバーは1台で数千ワットを消費し、調達費も1枚で数百万円規模になり得ます。アイドル状態のGPUを自動停止し、用途別に必要なVRAMと性能を選ぶ運用が不可欠です。
スポットインスタンスは40〜70%安い一方、中断を前提にした設計が必要です。学習ではチェックポイントを頻繁に保存し、推論では代替容量へ切り替える仕組みを用意します。
- GPU使用率とキュー待ち時間を同時に監視する
- アイドル環境の停止時刻を自動化する
- 中断可能なジョブと常時稼働を分離する
AI推論最適化で同じGPUの処理量を増やす
AI推論最適化では、バッチング、継続バッチ、KVキャッシュ、量子化を組み合わせ、GPUあたりの処理量を高めます。単発リクエストを即時に処理するだけでは、GPUの空きが増えやすくなります。
4/8 BitsAndBytesやvLLMを使用する場合、推論は2〜4倍安価です。実装前後で、毎秒トークン数、待機時間、精度、エラー率を測り、単なる単価低下で終わらせないことが重要です。
AI推論最適化では、レイテンシ要件を先に分類します。対話型は応答時間を優先し、夜間処理や大量要約はバッチ化することで、同じ設備でも電力効率を上げられます。
- リアルタイム処理とバッチ処理を分離する
- キャッシュ命中率をサービス別に測る
- 性能改善後も回答品質の回帰試験を行う
AI推論基盤は総コストで選ぶ
AI推論基盤は、GPU時間単価だけで選ばないことが重要です。モデル配布、コンテナ起動、ストレージ、転送、監視、障害対応、セキュリティを含めた総保有コストで比較します。
docker pull に10分以上かかる環境では、短時間ジョブでも待機コストが積み上がります。利用地域に近いレジストリ、軽量イメージ、重みの事前配置を整え、起動時間そのものを短縮します。
AI推論基盤には、利用部門ごとの配賦機能も必要です。ALION株式会社のように専属チームで開発を伴走する体制では、要件定義の段階から監視項目と責任分界を設計できます。
- コンテナ・重み・データの配置を近接させる
- プロジェクト別にGPU原価を配賦する
- 可用性とセキュリティを単価と併記する
持続可能な運用とAIソブリンティを両立する
電源と立地を調達条件にする
持続可能なAI運用では、再生可能エネルギーの比率だけでなく、利用する時間帯と場所を確認します。証書の購入だけでなく、追加性、電源の実在性、送電網への負担まで考えることが重要です。
データセンターの電力需要は、地域の送電網や発電設備の計画にも影響します。大規模なAI利用を始める前に、クラウド事業者の地域、電力調達方針、障害時の電源を確認しましょう。
実質100%再生可能エネルギーを使用する方針を掲げる事業者もあります。しかし、自社の利用時間帯に低炭素電源が供給されているかは別の論点であり、月次の実績確認が必要です。
- 地域・時間帯ごとの電源情報を確認する
- 再エネ証書と実際の需給を区別する
- 電力制約のある地域への集中を避ける
AIソブリンティはデータ所在地の選択で決まる
AIソブリンティとは、重要データ、モデル、推論処理をどの法域と運用主体の管理下に置くかを選べる状態です。電力最適化だけを理由に、データ統制を犠牲にしてはいけません。
AIソブリンティを守るには、データレジデンシー、暗号化、アクセス権、監査ログ、モデル提供者への送信条件を整理します。機密データは国内・指定地域の基盤で処理する選択肢を検討します。
国外チームとの開発でも、権限分離と匿名化を徹底すれば、品質と統制を両立できます。国境を越えたワンチーム支援を行う際には、設計書やログの扱いを契約と実装の両面で定義します。
- データ分類ごとに利用可能なモデルを定める
- 監査ログの保管場所と期間を決める
- 越境移転の条件を契約で確認する
組織の責任分界を明確にする
持続可能な運用を続けるには、開発、事業、経理、情報セキュリティ、インフラ担当の責任を分けることが必要です。誰が利用量を監視し、誰が予算超過時に停止判断をするかを明文化します。
開発チームはAIモデル圧縮やプロンプト削減を担い、基盤チームはAI推論基盤の稼働率と電力を管理します。事業部門は、業務時間削減や売上効果を測り、投資継続の根拠を示します。
四半期ごとに、AI電力消費、GPU単価、品質、CO2、利用部門別ROIをレビューしましょう。GPUコスト削減だけでなく、利用価値と社会的な負荷を同じ会議で扱うことが要点です。
- 技術KPIと事業KPIの責任者を分ける
- 予算超過時の承認経路を定める
- 電力・品質・ROIを定例で見直す
まとめ
AI電力消費を抑える鍵は、単一の省電力技術ではなく、測定、モデル選択、GPU稼働率、推論設計、電源調達をつなぐ運用です。小さな改善でも、利用回数の多いサービスでは大きな差になります。
要点
- 学習・推論・冷却・水利用を分けて継続計測する
- AIコスト管理では、原価だけでなく品質と業務ROIを評価する
- AIモデル圧縮、モデル蒸留、モデルルーティングを用途別に組み合わせる
- AI推論最適化とGPUコスト削減は、稼働率の可視化から始める
- AIソブリンティを考慮し、電力効率とデータ統制を両立する
まずは主要なAI機能を1つ選び、リクエスト数、トークン、GPU時間、品質、電力推計を可視化してください。設計・開発・運用を一体で見直すことで、持続可能で拡張しやすいAI活用へ進めます。
よくある質問
Q1. AI電力消費を最初に測るには何が必要ですか?
モデル名、入力・出力トークン、リクエスト数、GPU時間、処理時間、再試行回数をリクエスト単位で記録します。クラウド請求データと結び付ければ、機能別・部門別の原価を把握できます。
Q2. GPUコスト削減と品質維持を両立する方法は?
小型モデルへの切替、量子化、バッチ処理を実施する前に、代表データによる精度・完了率・レイテンシの基準を固定します。基準未達なら上位モデルへ戻す仕組みを設けます。
Q3. モデルルーティングはどの業務に向いていますか?
分類、抽出、定型要約、複雑な推論が混在する業務に向いています。単純な処理は軽量モデルへ、難しい処理だけを高性能モデルへ送ることで、電力とコストを抑えられます。
Q4. AIソブリンティとクラウド利用は両立できますか?
可能です。データ分類に応じて利用リージョン、モデル、保存先、アクセス権を分け、機密情報は指定法域内の基盤で処理します。契約条件と監査ログの確認も不可欠です。
Q5. AI電力消費を最初に測るには何が必要ですか?
モデル名、入力・出力トークン、リクエスト数、GPU時間、処理時間、再試行回数をリクエスト単位で記録します。クラウド請求データと結び付ければ、機能別・部門別の原価を把握できます。
Q6. GPUコスト削減と品質維持を両立する方法は?
小型モデルへの切替、量子化、バッチ処理を実施する前に、代表データによる精度・完了率・レイテンシの基準を固定します。基準未達なら上位モデルへ戻す仕組みを設けます。
Q7. モデルルーティングはどの業務に向いていますか?
分類、抽出、定型要約、複雑な推論が混在する業務に向いています。単純な処理は軽量モデルへ、難しい処理だけを高性能モデルへ送ることで、電力とコストを抑えられます。
Q8. AIソブリンティとクラウド利用は両立できますか?
可能です。データ分類に応じて利用リージョン、モデル、保存先、アクセス権を分け、機密情報は指定法域内の基盤で処理します。契約条件と監査ログの確認も不可欠です。
参考文献・出典
1. [法人のお客さまトップ](/) 2. [コラム](/column/) 3. [BizDrive](/column/bizdrive/) 4. **AIが奪うのは仕事ではなく電力?生成AIのエネルギー事情** …
business.ntt-east.co.jp
# [ACES エンジニアブログ](https://tech.acesinc.co.jp/) ## ACESのエンジニアブログです。 # [まさにコストカット祭り – GPUサーバー代を約30%削減した話 -](https://tech.acesinc.co.jp/entry/2025/02/07/083000)…
tech.acesinc.co.jp
[メインコンテンツへジャンプ](#main) [Data + AIの基盤](/jp/blog/category/data-ai-foundations) # AIコスト管理の新たな経済学 AIコストの測定と管理方法 によって [Databricks…
www.databricks.com