2026.10.19
AIペネトレーションで実現する実践的な防御設計
IT関連
AIペネトレーションとは、AIを組み込んだシステムに対して攻撃者の視点から侵入経路と被害の連鎖を検証する実践です。モデルだけでなく、RAG、API、認可、外部ツール、運用設定までを一つの攻撃面として扱います。
生成AIの導入では、出力内容の安全性だけを確認しても十分ではありません。プロンプトインジェクションを起点に、機密データの検索、権限外ツールの実行、別テナント情報へのアクセスへ進む経路を、実害の前に確かめる必要があります。
本記事では、AIペネトレーションの範囲、AI脆弱性診断との使い分け、AIレッドチームによる深い評価、AIリスク評価からAI事故対応までを解説します。開発・運用・経営が共通の判断材料を持つための手順も紹介します。
AIペネトレーションは侵害の成立条件を確かめる検証である
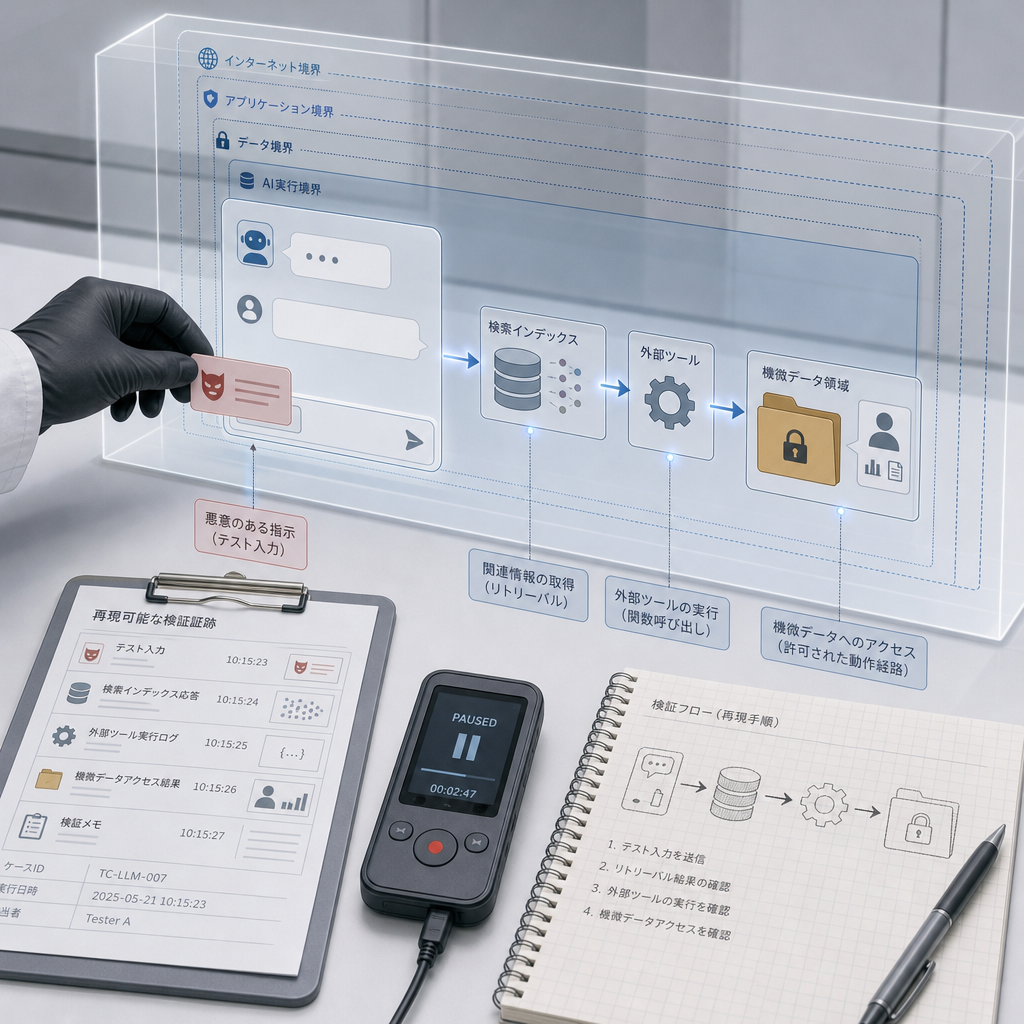
定義は「見つける」より「侵入できる」を証明すること
AIペネトレーションの目的は、設定不備や危険な応答を列挙することではなく、攻撃者がどの権限で、どの情報や機能まで到達できるかを再現可能な証跡で示すことです。脆弱性単体ではなく、連鎖したときの事業影響を確認します。
たとえば、公開されたチャット画面への指示注入だけでは深刻度を決められません。その指示でRAGの参照範囲を越えられるか、外部ツールを呼び出せるか、個人情報を取得できるかまで検証して初めて、修正の優先順位を合理的に判断できます。
従来のペネトレーションテストと同様に、スコープ、許可操作、停止条件、証跡の保存方法を事前に合意します。AIの出力は確率的に変化するため、入力、モデル設定、ツール呼び出し、通信ログをセットで保存し、再試験できる状態にします。
- 攻撃の成立可否をPoCとログで示す
- モデル・データ・API・認可を一連の経路として扱う
- 本番検証は停止条件を定めたセーフモードで行う
従来型テストとの差はAI固有の境界にある
WebアプリのXSS、SQLインジェクション、SSRF、RCE、IDORは、AI連携後も重要です。加えて、AIペネトレーションでは、システムプロンプト、ベクトルDB、ツール定義、エージェント権限など、従来は存在しなかった信頼境界を対象に加えます。
攻撃者は、モデルを直接破る必要がありません。検索文書に悪意ある命令を埋め込む間接プロンプトインジェクション、権限過大なコネクタ、検証不足のAPI引数を組み合わせれば、正規の機能だけで被害を生じさせる可能性があります。
そのため、単発のスキャン結果だけで安全と結論づけるのは危険です。認証済みユーザー、低権限の外部利用者、管理者補助者など複数の視点を置き、認可判定と業務ロジックが攻撃時にも機能するかを確かめます。
- 直接・間接プロンプトインジェクションを分けて試す
- IDORとクロステナントアクセスを実証する
- RAG文書を信頼できない入力として扱う
AIエージェントは速度を上げるが判断を置き換えない
AIエージェントは、OpenAPI仕様の探索、画面遷移の生成、入力値の変異、通信差分の整理を効率化します。数千の攻撃ベクトルを同時にテストできますが、許可なく状態変更や大量通信を実行させないためのガードレールが不可欠です。
一部のサービスでは、人間のチームが数週間または数か月かかる作業を数時間で完了しますと説明されています。これは探索と反復の速度に有効ですが、業務上の例外や、攻撃が実害になる条件の最終判断まで自動化できることを意味しません。
たとえばClaude Opus 4.8を含む複数モデルに同じ攻撃ケースを与え、再現性と証跡の質を比べる方法は有効です。ただし、モデルの回答を脆弱性の確定根拠にせず、セキュリティ担当者が通信、権限、実際のデータ到達を検証します。
- AIの提案と実通信ログを必ず照合する
- 実行権限は読み取り中心から段階的に広げる
- 人間の承認なしに本番データを操作させない
攻撃対象を可視化して侵害シナリオを組み立てる
対象範囲はモデルだけでなく接続先まで含める
AIシステムの攻撃面は、LLMや学習データだけではありません。Webアプリ、モバイルアプリ、API、クラウドIAM、CI/CD、ログ基盤、外部SaaS、ベクトルDBを棚卸しし、データと権限が移動する地点を明らかにすることが出発点です。
特にエージェント型の実装では、ツール呼び出しが権限境界をまたぎます。メール送信、ファイル検索、CRM更新、コード実行などの操作ごとに、誰が要求し、何を承認し、どの条件で拒否するかを設計書と実装の両方で確認します。
ALION株式会社のように国境を越える専属開発チームでシステム開発を進める場合も、開発環境、委託先アクセス、共有リポジトリを同じ資産台帳に入れることが重要です。責任分界点が曖昧な接続先ほど、優先的に攻撃シナリオへ組み込みます。
- 資産、データ分類、所有者、接続先を対応付ける
- エージェントの操作権限をツール単位で記録する
- 開発・検証・本番の認証情報を分離する
代表的な攻撃は連鎖として評価する
実務では、プロンプトインジェクション、ジェイルブレイク、モデル回避、データポイズニング、モデル抽出を個別に試すだけでは不十分です。最初の突破口から機密情報、権限昇格、横展開までつながるかを、攻撃グラフとして検証します。
具体例として、外部サイトの文書をRAGが取得し、その文書内の命令をモデルが信じ、エージェントが社内ファイル検索を行い、結果を外部送信する流れを考えます。各段階で入力検証、検索フィルタ、最小権限、出力制御が働くかを確認します。
攻撃の成功だけでなく、失敗時の挙動も重要です。拒否した理由がログに残るか、過剰なエラー情報を返さないか、レート制限が作動するかを見ます。防御機構が攻撃者に調整のヒントを与えていないかも評価対象です。
- 侵入、権限取得、情報取得、持ち出しを分けて記録する
- 攻撃失敗時のログと通知経路も確認する
- 秘密情報を使わないテストデータで再現する
ブラックボックスから始めて必要な情報を増やす
初回の検証は、攻撃者に近いブラックボックス方式から始めるのが有効です。公開画面、公開API、エラーメッセージ、検索結果だけを手掛かりにし、想定外の情報露出や認証回避の余地を確認します。
次に、限定した設計情報を渡すグレーボックス方式で、見つかった仮説を効率的に深掘りします。OpenAPI仕様、ロール定義、ツール一覧、データ分類を参照できれば、危険な引数や越境し得るアクセス制御を重点的に評価できます。
ホワイトボックス方式は、システムプロンプト、アクセス制御コード、監査ログ、設定値まで確認できるため、対策の有効性を検証しやすい手法です。ただし、実際の外部攻撃者が発見できる経路を見失わないよう、方式を混在させることが大切です。
- ブラックボックスで露出面を把握する
- グレーボックスで攻撃仮説を検証する
- ホワイトボックスで根本原因を確認する
AI脆弱性診断は継続検出に、侵入検証は重要経路に使う
AI脆弱性診断は広く早く異常候補を見つける
AI脆弱性診断は、既知の弱点、設定不備、危険な実装パターンを広範囲に検出し、修正候補を継続的に提示する取り組みです。リリース前の品質確認や、変更頻度が高いAPIの監視に向き、ペネトレーションテストの代替ではなく前段になります。
従来の手法では数日かかっていた異常検知がAIの活用なら数分程度で完了します。速度は大きな利点ですが、検知候補が実際に悪用可能か、どの利用者に影響するかは、権限を持つ人間が再現して確定する必要があります。
診断結果の優先順位にはCVSS v3.1スコアリングを利用できます。ただし、AI機能では機密データの種類、エージェントの実行権限、誤応答が業務判断へ与える影響も加味し、技術スコアだけで修正順を決めない運用が求められます。
- SAST、DAST、構成診断を開発工程に組み込む
- 検出候補は再現試験で真偽を確定する
- 重大度へ業務影響と到達容易性を加える
手法の選択は目的と成果物で決める
結論として、日常的な欠陥検出にはAI脆弱性診断、実際の侵入経路の立証にはAIペネトレーション、モデルの安全性や社会的影響まで問う場合にはAIレッドチームを選びます。三者を競合させるのではなく、開発成熟度に応じて接続することが重要です。
以下の表は、検証の目的と主な成果物を整理したものです。まず診断で候補を減らし、事業に重要な経路だけを侵入検証へ進めると、限られた予算でも専門家の時間を高いリスク領域へ配分できます。
価格だけで選ぶことも避けるべきです。一般的な診断の表示価格に$300 ~ $500 (約3万円~5万円に相当する米ドル範囲)があっても、対象範囲、認証済み試験、報告書の品質、再検証、データ保護の条件が異なれば、比較の前提は成立しません。
| 項目 | AI脆弱性診断 | AIペネトレーション | AIレッドチーム |
|---|---|---|---|
| 主目的 | 欠陥候補の検出 | 侵害経路の実証 | 安全性と悪用耐性の評価 |
| 主対象 | コード・設定・API | システム連鎖・認可 | モデル・RAG・運用 |
| 主成果物 | 検出一覧 | PoC・攻撃証跡 | シナリオ別改善提言 |
| 実施頻度 | 継続・定期 | 重要変更時 | 導入前・重大変更時 |
- 目的、対象、許容する操作を契約前に明文化する
- 成果物に再現手順と修正助言を含める
- 低価格プランは対象外機能を必ず確認する
誤検知を減らすには人間の承認工程が必要
AI診断が示した結果は、検出、再現、影響判定、修正確認の順に扱います。特に認証・認可、複雑な購入フロー、例外処理は業務文脈がなければ判断しにくく、機械的な深刻度だけで開発チームに修正依頼を出すと混乱を招きます。
検出率88.4%、誤検知率8.8%といった指標を評価する場合も、母数と判定基準を確認してください。検出件数が多くても、再現できない候補が多ければ、担当者の調査負担が増え、真に危険な問題の対応が遅れます。
人間のレビューでは、攻撃前提、必要権限、再現手順、影響を受けるデータ、暫定回避策を確認します。修正後は同じ入力だけでなく類似パターンも再試験し、対策が別のプロンプトやAPI経路で迂回されないことを確かめます。
- AI出力をチケット化する前に再現する
- 誤検知の理由をルール改善へ反映する
- 修正後は回帰テストとして継続実行する
AIレッドチームで想定外の安全性リスクを深掘りする
AIレッドチームは有害性と悪用可能性を横断評価する
AIレッドチームは、攻撃者の視点からAIの安全性、セキュリティ、公平性、プライバシー、運用上の悪用可能性を検証する活動です。侵入の成立だけでなく、有害な出力、誤情報、差別、知的財産漏えい、規制上の問題まで評価範囲に含めます。
評価対象は基盤モデルだけではありません。システムプロンプト、RAGの検索結果、ガードレール、プラグイン、ツール呼び出し、利用者向け画面、監査ログまでをつなげて見ます。モデル単体で安全でも、実装の組み合わせによって危険になるためです。
AIレッドチームの結果は、単なる攻撃一覧ではなく、攻撃シナリオ、成功条件、被害対象、再現性、推奨対策として整理します。開発担当、事業部門、法務・ガバナンス担当が同じリスクを理解できる成果物にすることが重要です。
- セキュリティと出力安全性を分断しない
- モデル単体とシステム全体を別々に評価する
- 攻撃成功の条件と防御失敗点を記録する
日本語の文脈を含む攻撃シナリオを設計する
AIレッドチームでは、対象の利用者が実際に使う言語と業務表現で試験する必要があります。日本語の敬語、婉曲表現、主語の省略、社内略語は、英語中心の安全対策では想定されない命令解釈やデータ開示につながる場合があります。
直接プロンプトインジェクションと間接プロンプトインジェクションを分け、検索文書、メール本文、添付ファイル、Webページなど異なる入口を用意します。さらに、正規業務に見せかけた依頼が、エージェントの権限を不正に利用できないかを試験します。
検証の観点は、拒否できたかだけではありません。拒否時に代替情報を出していないか、秘密のシステム指示を漏らしていないか、別表現で簡単に回避できないかを確認します。多様な入力での反復試験が、実運用に近い強度を測ります。
- 同義語、曖昧表現、複数ターンの誘導を試す
- 文書経由の命令注入を必ず試験する
- 拒否メッセージ自体の情報漏えいを確認する
自動化は最大80%高速化しても専門家の責任を残す
自動化されたAIレッドチームは、大量の入力バリエーションや攻撃シーケンスを反復でき、条件によっては最大80%高速化が期待されます。回帰テストやモデル更新後の比較には特に有効で、改善前後の安全性を同じ基準で測定しやすくなります。
ただし、医療、金融、法務、採用など高い影響を持つ領域では、ドメイン専門家の参加が欠かせません。技術的には攻撃が成功していなくても、誤った助言をもっともらしく提示すること自体が、利用者の意思決定に重大な影響を与えるためです。
結果を受け取ったら、モデル変更だけで終わらせず、検索データの整備、ツール権限の縮小、確認画面の追加、監視ルールの改善を検討します。LLMガードレールの設計と評価方法も参照し、入力から出力まで多層で防御してください。
- 同一シナリオで更新前後を比較する
- 高影響領域には業務専門家を加える
- モデル対策とシステム対策を分けて実装する
AIリスク評価とAI事故対応を運用に組み込む
AIリスク評価は影響と悪用容易性で優先順位を決める
AIリスク評価では、脆弱性の有無だけでなく、扱うデータ、利用者、外部公開の有無、エージェントの権限、検知可能性を組み合わせて優先順位を決めます。攻撃が成立しやすく、影響範囲が大きく、気付きにくい経路から対策を始めるのが原則です。
重要なのは、技術リスクを事業リスクへ翻訳することです。機密情報の漏えいなら対象データと閲覧者数、権限濫用なら実行可能な操作、サービス停止なら業務への影響を明記します。これにより、経営判断と開発の修正計画を接続できます。
AIリスク評価は一度で終わりません。モデル変更、プロンプト変更、RAG文書の追加、外部ツールの接続、権限設計の変更は、すべて新しい攻撃面を生みます。変更管理の承認条件に評価と回帰試験を組み込むことが必要です。
- 資産価値、攻撃容易性、検知可能性を評価する
- 技術的な弱点を業務影響へ置き換える
- 重大変更を再評価のトリガーにする
AI事故対応は止める・残す・知らせるを同時に行う
AI事故対応の初動では、被害の拡大停止、証跡保全、関係者への連絡を並行して進めます。悪意ある指示を受けた可能性がある場合、モデル利用の全面停止だけでなく、問題のツール連携、検索コネクタ、特定ユーザーのトークンを限定的に止める選択肢も検討します。
ログは、入力と出力だけでは足りません。利用者ID、会話ID、モデルと設定、参照文書、ツール呼び出し、認可判断、外部API応答を時系列で保全します。個人情報を含むログはアクセス権を絞り、改ざんされない保管先へ退避します。
AI事故対応では、原因がモデル、データ、プロンプト、認可、運用手順のどこにあるかを切り分けます。対策後は同じ攻撃を再現し、停止措置を解除する条件を文書化します。場当たり的な遮断で業務影響を長引かせないことも重要です。
- キルスイッチとロールバック手順を事前に試す
- 会話・検索・ツール実行ログを関連付ける
- 復旧判断には再現試験の結果を使う
継続運用では検証結果を開発サイクルへ戻す
AIペネトレーションで得た攻撃パターンは、報告書で終わらせず、要件、設計レビュー、テストケース、監視ルールに還元します。開発初期に防げる問題を後工程まで持ち越さない、いわゆるシフトレフトが、修正コストと事故確率の両方を下げます。
運用では、検知から調査、封じ込め、復旧、振り返りまでの責任者と連絡経路を明確にします。24時間365日の継続監視を採用する場合でも、アラートを誰が評価し、どの条件で開発や経営へエスカレーションするかを決めなければ機能しません。
一部の製品では最大88%のアラート削減を掲げています。しかし、削減率だけを目標にせず、重大事象の見逃し、平均調査時間、修正後の再発率を定期的に確認してください。AIリスク評価とAI事故対応を改善し続ける体制が、防御の実効性を左右します。
- 攻撃シナリオを自動テストと監視ルールへ転用する
- アラート量より重大事象の検知品質を見る
- 振り返りで権限・ログ・手順を更新する
まとめ
AIペネトレーションは、AIの危険な応答を探すだけの作業ではありません。モデル、データ、認可、外部ツール、運用をまたぐ攻撃経路を再現し、事業への影響に応じて修正するための実践です。AI脆弱性診断とAIレッドチームを適切に組み合わせ、AI事故対応まで接続しましょう。
要点
- AIペネトレーションでは脆弱性単体でなく侵害経路と実害を検証する
- AI脆弱性診断は継続的な検出、侵入検証は重要経路の実証に向く
- AIレッドチームは安全性・悪用可能性・社会的影響を横断的に扱う
- AIリスク評価、ログ保全、キルスイッチを事故対応計画へ組み込む
- 自動化の速度を活かしつつ、専門家の再現確認と承認を残す
まずはAI資産、接続先、エージェント権限を一覧化し、最も重要な業務フローを一つ選んで攻撃シナリオを作成してください。設計・開発・運用の担当者が同じ証跡を確認するところから、実効性のあるAIセキュリティ運用が始まります。
よくある質問
Q1. AIペネトレーションと通常のペネトレーションテストの違いは?
通常のWeb、API、クラウドの攻撃面に加え、プロンプト、RAG、モデル出力、エージェント権限、外部ツール連携を対象に含める点が違いです。AI固有の経路と従来型の脆弱性を連鎖させて検証します。
Q2. AI脆弱性診断だけで十分ですか?
継続的な検出には有効ですが、発見候補が実際に侵害へつながるか、業務上どの被害が起きるかは別途確認が必要です。重要なシステムではAIペネトレーションと専門家レビューを組み合わせます。
Q3. 本番環境で検証しても安全ですか?
無制限の実施は危険です。読み取り中心の権限、レート制限、テストデータ、キルスイッチ、ロールバック、監視担当者を用意し、許可された操作だけを行うセーフモードで段階的に検証します。
Q4. AI事故対応で最初に確認すべきことは何ですか?
影響を受けた会話、参照文書、ツール実行、認可ログを保全し、被害が継続する接続や権限を止めます。その後、情報流出、誤操作、外部送信の有無を時系列で調査し、再発防止策を検証します。
Q5. AIレッドチームはいつ実施すべきですか?
初回リリース前、RAGや外部ツールを追加する前、モデルや権限設計を大きく変更する前に実施します。運用開始後も、実際の利用状況と新しい攻撃手法に合わせて定期的にシナリオを更新します。
参考文献・出典
## エグゼクティブサマリー * AIレッドチームでは医療や法律など様々な領域の専門家をチームに加えて攻撃シナリオを検討、AIシステム固有のリスクへ対応 * AIシステムを開発する米国のテクノロジー企業を中心に国内外の様々な組織でAIレッドチームの取組みを実施 * 脱獄問題や多言語・文化への対応が引き続きの課題 *…
group.nec
2026年 Gartner® Magic Quadrant™ エンドポイント保護部門のリーダー。6年連続受賞。[理由を見る](/ja/lp/gartnermq/) * [侵害を受けていますか?](/ja/global-services/get-support-now/) * [ブログ](/ja/blog/) *…
www.sentinelone.com
[](https://www.ubsecure.jp/) [](/) やっぱりセキュリティって楽しい!…
minnano.ubsecure.jp