2026.10.12
AIモデル圧縮で実現する軽量・高速推論の設計術
IT関連
AIモデル圧縮は、精度を必要以上に落とさず、モデルの容量・計算量・消費電力を減らす実践です。生成AIを本番運用すると、GPU費用や応答時間が事業拡大のボトルネックになりやすく、軽量化は機能開発と同じほど重要になります。
圧縮には、重みの表現を小さくする量子化、不要な接続を除く枝刈り、強力な教師から小型モデルへ知識を移すモデル蒸留などがあります。ただし、ファイルサイズだけを指標にすると、実機で速度が出ない、回答品質が落ちるといった失敗につながります。
本記事では、圧縮方式の仕組みから、AI推論基盤に合わせた実装、AIモデル検証とAI品質保証の進め方までを解説します。シリーズ第1回として、圧縮後のモデルを安全かつ継続的に提供するための判断軸を、具体例とともに整理します。
AIモデル圧縮は何を最適化するのか
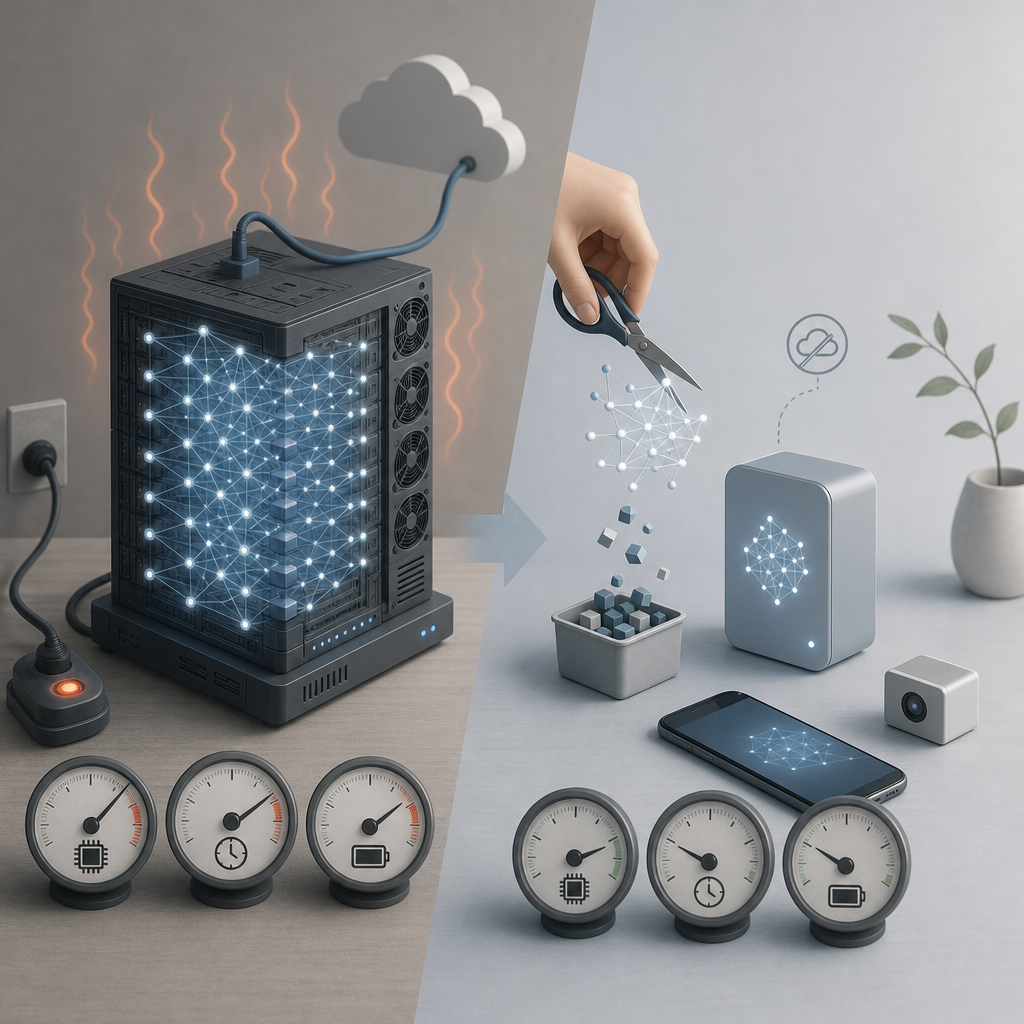
圧縮の目的は実運用の制約を外すこと
AIモデル圧縮の目的は、単に保存容量を小さくすることではありません。メモリ使用量、計算時間、推論レイテンシ、電力、通信量を同時に見直し、限られたハードウェアでもサービス品質を維持することが本質です。
大規模モデルは数百万から数十億ものパラメータを持ちます。そのままクラウドGPUへ載せれば開始は早くても、アクセス増加時の費用や待ち時間が膨らみます。圧縮は、利用規模に応じた提供形態を選ぶための技術的な余地を生みます。
特にスマートフォン、カメラ、工場センサーなどのオンデバイスAIでは、通信が切れても動くこと、発熱を抑えることが重要です。エッジAIやTinyMLでは、モデルを小さくすること自体が要件であり、後工程の付け足しにはできません。
- 削減対象は容量だけでなく、遅延・電力・通信・運用費
- クラウドとエッジでは優先する制約が異なる
- 圧縮前に業務上の許容遅延と精度を決める
軽量化の基本は三つの手段で捉える
AIモデル圧縮の代表的な考え方は、「教え込む」「枝を切る」「量を区切る」の3つです。これは順に知識蒸留、プルーニング、量子化に対応し、削れる対象と品質への影響が異なるため、単独ではなく組み合わせて検討します。
枝刈りは、影響の小さい重みやチャネルを除去する方法です。ランダムに削るのではなく、重要度を測りながら構造化プルーニングを選べば、対応ランタイムで実測速度につなげやすくなります。
量子化は、通常float32で保持する値を低ビット表現へ変換する手法です。float16、int32、int16、int8、そしてint2まで選択肢は広がりますが、実行環境がその型を高速に扱えるかを事前に確かめる必要があります。
- 蒸留は知識を移す
- 枝刈りは計算グラフを減らす
- 量子化は数値表現を縮める
圧縮率だけでは成否を決められない
圧縮の成否は、圧縮率、精度、レイテンシ、スループット、ハードウェア互換性のトレードオフで判断します。モデルサイズが半分でも、演算子が最適化されなければ、実機では処理時間が短くならない場合があります。
例えば、32ビットの代わりに16ビットや8ビットを用いることで、必要な記憶領域を大幅に減らすことができます。一般に16ビット化ならモデルサイズが2倍に減少します。8ビット化ならモデルサイズが4倍に削減されます。
一方で、圧縮済みモデルの再学習、変換、配布、監視まで含めた保守性も重要です。開発チームは、精度が数値上は維持されても、例外入力や業務用語に弱くなっていないかを後段の評価工程で確認しなければなりません。
- 容量と実測速度は別の指標
- 演算子対応とメモリ帯域を確認する
- 保守コストまで含めて採否を決める
量子化と枝刈りを実機性能へつなげる
量子化は校正データで精度劣化を抑える
量子化で品質を保つ鍵は、実際の入力に近い校正データです。学習後量子化であるPTQは短時間で導入しやすく、量子化対応学習のQATは学習中に誤差を織り込み、精度をより重視したい場面に向きます。
例えば、ある写真を見て「これは猫である」という確信度が80%、「犬である」という確信度が15%、「鳥である」という確信度が5%だとします。このクラス間の確率差まで保てるかを確認すると、単なる正解・不正解より劣化の兆候を早く捉えられます。
実務では、8ビット量子化でも1%未満の精度損失で済むケースがあります。ただし外れ値の大きい活性値、長文入力、専門領域の固有語では影響が増え得るため、平均スコアだけで安全と結論づけないことが大切です。
- PTQは導入速度を優先したい場合に有効
- QATは精度要件が厳しい場合に有効
- 校正データは本番入力の偏りを含める
枝刈りは対応ハードウェアと一緒に設計する
枝刈りは、不要な重みをゼロに近づけることで演算量を減らします。ただし非構造化スパース性は、汎用GPUや推論エンジンが十分に活用できないこともあり、モデル上の削減率と速度向上率が一致しません。
そのため、チャネル、ヘッド、ブロック単位で削る構造化プルーニングが実装しやすい選択肢になります。半分のスパース性(50%)でも性能を維持しという知見は有望ですが、対象タスクとランタイムが変われば再現性を確認する必要があります。
枝刈り後は短い再学習を行い、削った構造にモデルを適応させます。ここでファインチューニングを省くと、頻度の低いクラスや境界事例に偏った劣化が残り、本番の問い合わせで初めて問題が顕在化するおそれがあります。
- スパース率ではなく実測レイテンシを比較する
- 構造化枝刈りはデプロイしやすい
- 枝刈り後の再学習を工程に含める
LLMでは重みとKVキャッシュを分けて考える
LLMの圧縮では、モデル重みの量子化に加え、会話が長くなるほど増えるKVキャッシュの管理が重要です。応答生成ではメモリ帯域が支配的になることがあり、重みだけを小さくしても期待どおりの速度改善にならないことがあります。
報告例では、LLaMA3-8B-Instructモデルで3ビット精度を実現し、しかも従来より1.6%精度が向上しています。また、Llama-2 7Bを4ビットに落としても、フル精度とのギャップを2.9ポイントに抑えた結果があります。
さらに、W4A4KV4構成でLLaMA-3-8Bの性能ギャップを32%も削減した例は、重み・活性値・KVキャッシュを一体で最適化する価値を示します。目的は低ビット化そのものではなく、要求する会話品質と処理能力の両立です。
- LLMはKVキャッシュの使用量も測る
- 長い入力と同時接続で評価する
- ビット幅はモデル全体で一律にしない
モデル蒸留で小型モデルに判断力を移す
蒸留は教師の確率分布を生徒に学ばせる方法
モデル蒸留は、大きな教師モデルの出力分布や内部表現を、小さな生徒モデルに学習させる方法です。正解ラベルだけでは得られない、誤答候補間の近さや判断の滑らかさを移せる点が、通常の学習との大きな違いです。
生徒はハードラベルに加え、温度パラメータで滑らかにしたソフトターゲットとの距離を損失関数に含めます。温度を上げると低確率クラスの情報も見えやすくなりますが、設定が過大だと教師の曖昧さまで強く引き継ぎます。
Response-based蒸留は出力を対象にし、Feature蒸留やAttention蒸留は中間表現も合わせます。分類、要約、検索、画像認識など、何を生徒に残したいかを先に定義すると、損失関数と評価セットを合理的に選べます。
- 教師の確率分布が追加の学習信号になる
- 温度と損失重みは検証対象にする
- 出力・特徴・注意機構で蒸留範囲を選ぶ
パラメータ規模は用途別に比較して選ぶ
モデル蒸留では、小さければよいわけではなく、必要な知識量に対して適切な生徒規模を選ぶべきです。比較データには137Mで60.38、278Mで59.45、1240Mで57.87という結果があり、パラメータ数だけで性能順位を単純化できないことが分かります。
別の比較では、137Mが49.60、38Mが48.54、33Mが49.19、184Mが48.80、71Mが47.89、278Mが示されています。評価指標やデータセットが異なる数値を横並びで断定せず、自社タスクで再評価する姿勢が必要です。
教師モデルの生成結果を大量に使う場合は、誤り、バイアス、著作権、アクセス条件も学習データに持ち込まれます。教師の回答を正解として固定せず、人手確認済みデータとルールベースの検査を組み合わせることが安全です。
| 項目 | 転写対象 | 適した用途 |
|---|---|---|
| Response-based | 出力分布 | 分類・生成 |
| Feature-based | 中間特徴 | 画像・表現学習 |
| Attention-based | 注意マップ | 変換器モデル |
- 生徒規模は業務タスクの難度から決める
- 公開ベンチマークは比較の出発点にする
- 教師出力の誤りと権利条件を確認する
蒸留後にも再学習と評価が必要
蒸留の直後に、業務データでファインチューニングを行うと、汎用知識を保ちながら用語や応答形式を合わせられます。ただし学習データが狭すぎると、教師から得た汎化能力を失い、特定の質問だけに強いモデルへ偏る危険があります。
特に生成AIでは、正答率だけでは回答品質を測れません。根拠の追跡可能性、指示への追従、拒否すべき質問への対応、文体の一貫性を含めて、教師と生徒の差を定性・定量の両面から比較します。
圧縮を急ぐあまり、教師と生徒のライセンス条件や利用規約を見落としてはいけません。技術的に再現できることと、データ利用や出力利用が許可されることは別問題であり、導入前の確認項目として扱う必要があります。
- 蒸留後のファインチューニングで業務適合を高める
- 生成品質は多面的な評価軸で判定する
- モデルとデータの利用条件を確認する
AI推論基盤に合わせて圧縮効果を測る
推論基盤の要件から圧縮方式を逆算する
AI推論基盤では、圧縮方式を先に決めるのではなく、応答時間、同時接続数、可用性、費用から逆算します。オンライン推論はミリ秒単位の遅延を重視し、夜間のバッチ推論はスループットと処理単価を優先するため、最適なモデル形式も変わります。
GPUを共有する環境では、利用率が60〜80%に見えても、待機やメモリ断片化で利用者の体感性能が悪化します。軽量モデルを増やすだけでなく、リクエストのキューイング、マイクロバッチ、優先度制御を含めて設計することが必要です。
Kubernetes v1.34のようなオーケストレーション環境では、モデルの配備、オートスケーリング、ロールバックを標準化できます。しかし、コンテナ起動時間やモデルロード時間も含めて測らなければ、scale-to-zeroが短時間の要求に不利になることがあります。
- オンラインとバッチで評価指標を分ける
- GPU利用率だけで混雑を判断しない
- 配備・起動・ロード時間も測定する
実測ではレイテンシの内訳を見る
AI推論基盤で圧縮効果を判断するには、モデル推論時間だけでなく、前処理、キュー待ち、ネットワーク、後処理を分解します。圧縮後にGPU計算が短縮されても、CPU側のトークナイズやデータ転送が支配的なら、利用者には改善が見えません。
サービス品質は平均値ではなく、95%のリクエストがどの時間以内に終わるかで見るべきです。ピーク時のp95やp99を観測し、圧縮前後で同じ入力分布・同じ同時実行数にそろえることで、比較に意味が生まれます。
運用環境がOS(Debian 13.2)であれば、ドライバー、CUDA系ライブラリ、CPUバインディング、NUMA設定も記録します。モデルだけを変更したつもりでも、周辺の差異で結果が揺れるため、再現可能なベンチマーク条件が欠かせません。
- 前後処理と待機時間を含めて計測する
- p95・p99でピーク時品質を確認する
- OSとライブラリの構成を固定する
コストは単価ではなく要求を満たす総額で考える
推論コストは、GPUの時間単価だけで比較してはいけません。あるクラウドGPUが$300で利用できても、必要な台数、アイドル時間、データ転送、監視、障害対応を加えると、月額の意思決定は大きく変わります。
圧縮モデルがリソース使用量を4%未満に抑える場面でも、実際の費用対効果は要求量によります。低トラフィックでは常時稼働の固定費が支配的になり、高トラフィックではモデルごとのメモリ消費と同時実行数が効いてきます。
ALION株式会社のように専属チームで開発から運用まで伴走する体制では、モデル変換だけを切り出さず、アプリケーション、インフラ、監視を一つの設計対象にできます。圧縮の効果を事業価値へつなぐには、この横断的な視点が有効です。
- コストは台数・待機・転送・保守を含める
- 低負荷と高負荷では最適解が変わる
- 開発と運用の境界をまたいで設計する
AIモデル検証とAI品質保証で劣化を防ぐ
検証は圧縮前後の差分を証明する工程
AIモデル検証は、圧縮後モデルが元モデルと同等に業務要件を満たすことを確認する工程です。ベンチマークの一点だけでなく、通常入力、長文、ノイズ、低頻度ケース、境界条件に分け、どの利用者にどのような差が出るかを明らかにします。
検証セットは、学習・校正・最終評価で分離します。同じデータを使い回すと、量子化やファインチューニングで特定パターンに最適化されても気づきにくく、本番での精度低下を過小評価してしまいます。
LLAMA1-65Bを4ビット化するのに4.3時間しかかからないという高速な変換例があっても、評価工程まで短縮できるとは限りません。変換時間と品質確認の時間を分けて計画し、リリース判定の根拠を残すことが重要です。
- 評価データは用途別に分ける
- 圧縮前後の差分をケース単位で確認する
- 変換速度と検証速度を混同しない
品質保証は精度以外の失敗も扱う
AI品質保証では、正答率に加え、危険な誤回答、応答不能、偏った出力、個人情報の露出、レイテンシ超過を管理します。軽量化によってメモリ不足や演算子非対応が起きれば、精度が高くてもサービスは成立しません。
品質基準は、リリース前の合格条件と運用中の監視条件に分けます。前者ではタスク別スコアと負荷試験を確認し、後者ではエラー率、p95、入力分布の変化、利用者フィードバックを追跡して、劣化の早期検知につなげます。
研究例では、エンドツーエンド43%の効率向上が示されています。しかし自社環境にその数値をそのまま当てはめるのではなく、同じデータ量、同じ要求条件、同じハードウェアで再測定し、説明可能な判断材料に変えるべきです。
- 品質は精度・安全性・可用性を含む
- 合格基準と監視指標を分ける
- 外部事例の数値は自社条件で再確認する
段階リリースで安全に本番へ移す
安全な導入では、圧縮モデルをいきなり全量へ切り替えず、カナリアリリースで一部トラフィックに限定します。元モデルとの回答差、エラー、レイテンシを同時に観測し、基準を超えたら即座に戻せる設計にします。
異常検知や危険運転検知のように誤判定コストが高い用途では、軽量モデルを一次判定に使い、低信頼度のケースだけ高精度モデルや人手確認へ回す二段構えが現実的です。これにより速度と安全性を両立しやすくなります。
圧縮後もモデル、変換設定、校正データ、評価結果、実行環境を版管理します。AIモデル検証の証跡があれば、障害時に原因を追いやすく、AI品質保証を属人的な経験ではなく継続可能な運用へ変えられます。
- カナリア方式で影響範囲を限定する
- 低信頼度の処理経路を設ける
- 変換条件と評価結果を版管理する
まとめ
AIモデル圧縮は、量子化・枝刈り・モデル蒸留を用いて、容量だけでなく遅延、消費電力、推論コストを最適化する取り組みです。成功の鍵は、圧縮率を追うことではなく、AI推論基盤上の実測値と業務品質を結び付けることにあります。
要点
- 圧縮方式は、精度・速度・メモリ・対応ハードウェアの条件から選ぶ
- LLMでは重みだけでなくKVキャッシュと長文入力を評価する
- AIモデル検証とAI品質保証を、変換後の必須工程として設計する
- 段階リリースと監視により、圧縮モデルを安全に運用する。
- ファインチューニングは圧縮後の業務適合を高めるが、独立した評価が必要
まずは代表的な本番入力を集め、元モデルの精度・p95レイテンシ・メモリ使用量を記録してください。その基準があれば、最小の量子化や蒸留から試し、品質を守ったままAI推論基盤の負荷を下げる次の一手を判断できます。
よくある質問
Q1. AIモデル圧縮で最初に試すべき手法は何ですか?
多くのケースでは、実装負荷が比較的小さい8ビット量子化から始めます。その後、精度要件と対応ハードウェアを確認し、QAT、枝刈り、モデル蒸留を段階的に検討します。
Q2. 圧縮すると必ず精度は下がりますか?
必ずしも大きく低下するわけではありません。ただし、平均精度が保たれても、低頻度入力、長文、専門用語で劣化することがあります。圧縮前後を同一条件で比較するAIモデル検証が必要です。
Q3. モデル蒸留とファインチューニングの違いは何ですか?
モデル蒸留は教師モデルの出力分布や表現を生徒モデルへ移す学習です。ファインチューニングは、既存モデルを自社タスクや業務データへ適合させる追加学習であり、蒸留後に組み合わせることもあります。
Q4. AI推論基盤では何を監視すべきですか?
平均応答時間だけでなく、p95・p99レイテンシ、エラー率、GPUメモリ、キュー待ち時間、スループット、入力分布の変化を監視します。圧縮モデルと元モデルを比較できる観測設計が重要です。
Q5. 圧縮モデルを本番へ安全に出す方法は?
一部の利用者やトラフィックに限定するカナリアリリースが有効です。品質・遅延・障害指標を元モデルと比較し、事前に定めた閾値を超えた場合は即時に切り戻せるようにします。
参考文献・出典
## LinkedInはプライバシーを尊重します LinkedInとサードパーティは、必須Cookieと必須でないCookieを使用して、サービスの提供、保護、分析、改善を行い、LinkedIn内外で関連性のある広告 (プロフェッショナルや求人広告を含む)…
jp.linkedin.com
この記事を共有 InfraAcademy Blog # AIを『作る』から『動かし続ける』へ。2026年、AI推論基盤がインフラエンジニアの仕事を変える Linux・ネットワーク・AWSを、環境構築なしで実践学習できます この記事を共有 こんにちは、インフラエンジニアのryuです。…
engineer-ninaritai.com