2026.10.23
AI推論最適化で速度とコストを両立する実践法
IT関連
AI推論最適化は、生成AIを本番運用する際の応答速度、処理件数、インフラ費用を同時に改善する取り組みです。モデルの精度だけを追っても、遅い回答や膨らむGPU利用料が事業価値を損なうことがあります。
学習はモデルの重みを更新する工程である一方、推論は完成したモデルがリクエストに回答する工程です。利用者が体感する待ち時間は推論で決まり、長い入力を処理するプレフィルと、出力を生成するDecodeでは最適な対策も異なります。
本記事では、測定指標の決め方からAI推論基盤の設計、AIモデル圧縮、モデル蒸留、モデルルーティング、GPUコスト削減までを一連の判断として整理します。個別の施策ではなく、品質・速度・総コストの均衡を取る実践手順を学びましょう。
AI推論最適化で最初に測るべき指標
推論最適化の目的を学習と分けて考える
答えは、学習済みモデルを必要な品質で速く安く提供することです。学習最適化では収束速度や訓練コストを重視しますが、推論では利用者が待つ時間、同時接続時の処理量、1リクエスト当たりの費用を優先します。
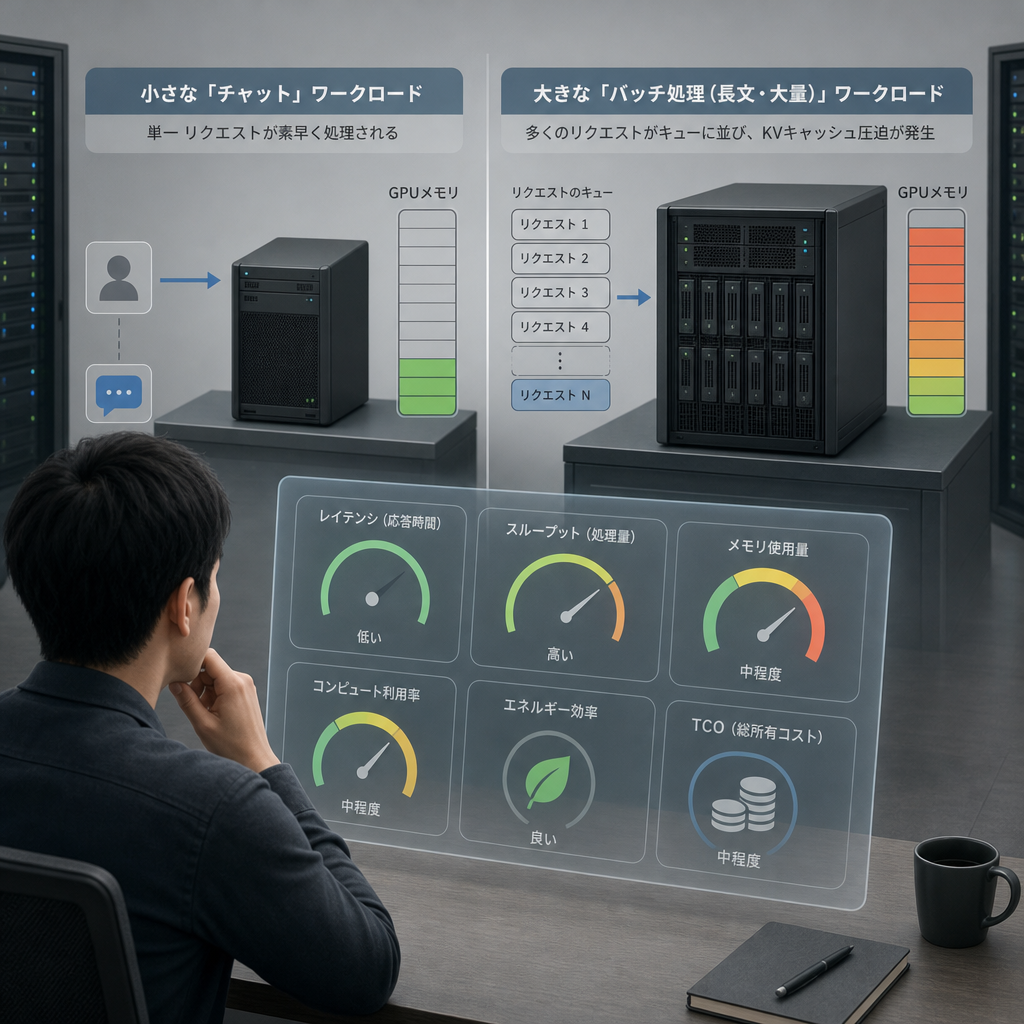
特にLLMはパラメータ数が数百億規模になり得るため、重みの配置とメモリ転送が性能を左右します。単発のベンチマークで高速でも、会話履歴が長い実運用ではKVキャッシュがVRAMを圧迫し、待ち行列が発生します。
最初の目標は「速くする」ではなく、用途別のSLOを定義することです。対話型なら1 秒未満の応答時間、夜間集計なら総処理時間を主指標に置きます。オンライン推論とバッチ推論を同じ基準で評価しないことが重要です。
- 対話型は初回応答時間とp95レイテンシを優先する
- バッチ型は総処理量と1件当たりの総コストを優先する
- 品質評価は速度・費用の変更前後で同じテストセットを使う
6つの効率指標をベースラインにする
答えは、遅延・処理量・メモリ・計算利用率・エネルギー・TCOを同時に記録することです。単一の平均応答時間だけでは、ピーク時の劣化やGPUの遊休、品質低下を見落とします。
スループット (トークン数/秒 – TPS) は、同じ品質条件で比較して初めて意味を持ちます。初回トークンまでの時間、トークン間遅延、p95・p99レイテンシ、エラー率をリクエスト属性とともに残すと、原因を分解できます。
改善効果は劇的な値だけで判断しません。量子化後の品質では<1% の低下が一般的とされる一方、業務固有の正答性や安全性は別途確認が必要です。評価データを固定し、変更ごとに比較可能な形で蓄積します。
- 初回トークンまでの時間と生成中の遅延を分離する
- GPU使用率とVRAM使用量をリクエスト量と結び付ける
- 平均値に加えp95・p99と失敗率を確認する
プレフィルとDecodeでボトルネックを切り分ける
答えは、長い入力を読むプレフィルと、1トークンずつ生成するDecodeを別々に測ることです。プレフィルは入力長とAttention計算の影響を受けやすく、DecodeはKVキャッシュの読み書きとメモリ帯域の影響を強く受けます。
既知の長文プロンプトを繰り返す用途では、プロンプトキャッシュが有効です。同一のシステム指示や文書断片を再利用できれば、毎回のプレフィルを避けられ、応答のばらつきも抑えやすくなります。
読み取りレイテンシを最大 96% 削減した事例が示すように、キャッシュ設計はモデル変更なしでも大きな差を生みます。ただしキャッシュの命中率、保存期間、テナント分離を測定し、機密情報が混在しない設計にします。
- 入力トークン数と出力トークン数を別々に計測する
- 固定文脈はキャッシュ対象、個別情報は分離対象にする
- 長文入力は検索結果や要約の設計から見直す
要件から組み立てるAI推論基盤
実行場所は遅延とデータ要件で選ぶ
答えは、クラウド、オンプレミス、エッジのうち、データの所在と許容遅延に合う場所を選ぶことです。大規模モデルを柔軟に増減したいならクラウド、通信断でも即応したいならエッジが候補になります。
個人情報や機微データを扱う場合は、ネットワーク経路、保存先、監査要件を先に確認します。モデルが速くても、外部APIへの往復やリージョン間転送が支配的なら、利用者が感じる応答時間は改善しません。
AI推論基盤では、GPUの演算性能だけでなく、CPU、ストレージ、PCIe、ネットワークも一体で設計します。GPUには数千の処理装置(または「コア」)が含まれており、給電側の処理が詰まると高価な演算資源を待たせます。
- 低遅延要件ならデータに近い実行場所を優先する
- 機密性が高い場合は経路と権限を先に設計する
- GPU以外のI/O待ちもプロファイルする
サービング基盤は共有と隔離を両立させる
答えは、KubernetesなどのオーケストレーターでGPU割り当て、モデル配備、スケールを標準化することです。Kubernetes v1.34のように基盤のバージョンを固定し、検証済みのランタイムと設定をコードで管理します。
vLLMのPagedAttentionはKVキャッシュをページ単位で扱い、異なる長さの要求を効率よく共存させる考え方です。連続バッチング、インフライトバッチング、マイクロバッチを組み合わせると、要求の到着時刻が異なってもGPUを埋めやすくなります。
共有を進める際は、重要サービスの性能を他部署のバッチ処理で損なわないよう、優先度と上限を定義します。最大7つの独立したインスタンスに分割できる仕組みでも、モデルごとのVRAM予約と待ち行列を可視化する必要があります。
- モデルごとにGPU、VRAM、同時実行数の上限を決める
- 対話系とバッチ系でキューまたは優先度を分ける
- 配備設定は手作業でなく宣言的に管理する
本番SLOは可観測性から改善する
答えは、p95・p99レイテンシ、可用性、エラー率、GPU使用率をSLOとして結び付けることです。GPU使用率が60〜80%で安定していても、待ち行列が伸びれば対話品質は悪化するため、利用者視点の指標を優先します。
エラーバジェットを設けると、速度改善のための変更を安全に進められます。例えば失敗率を4%未満に保つ条件でカナリア配備し、逸脱時は前バージョンへ戻す仕組みを自動化すると、最適化の試行が運用リスクになりにくくなります。
ログ、トレース、メトリクスの設計は、LLM可観測性の監視すべき指標・ログ設計・障害対応と併せて整備してください。入力長、モデル版、キャッシュ命中、GPU待ちを追跡すれば、遅延の原因を短時間で絞れます。
- SLOには利用者の待ち時間と基盤の健全性を併記する
- 変更はカナリア配備と自動ロールバックで検証する
- トレースにはモデル版・入力長・キュー時間を含める
AIモデル圧縮でメモリと速度を改善する
量子化は最初に試すべき軽量化手法
答えは、品質検証ができるなら量子化を最初の候補にすることです。量子化(精度を 16 ビットから 4 ビットに下げる)により、モデル重みと演算のデータ量を減らし、VRAM制約を緩和できます。
INT4-AWQ – 4 ビットデータ形式。FP8 – 8 ビット浮動小数点 (FP8)。INT8-SmoothQuant – 8 ビットデータ形式。これらは同じ「低精度」でも、対象ハードウェア、キャリブレーション方法、外れ値への耐性が異なります。
多くの場合、処理速度が 2~3 倍向上します。ただし出力品質はタスクに依存するため、要約、分類、抽出、自由回答を分けて評価します。特に数値計算や固有名詞を扱う業務では、失敗例を含む回帰テストが不可欠です。
- 代表的な実入力で量子化前後の品質を比較する
- 対応GPUと推論エンジンの精度形式を確認する
- 重みだけでなくKVキャッシュのVRAMも測定する
モデル蒸留は品質要件から設計する
答えは、大規模な教師モデルの出力を使い、用途に合う小型モデルを育てるモデル蒸留です。単に小さいモデルを選ぶより、実際の問い合わせ、正解例、失敗例を反映できるため、対象業務での費用対効果を高められます。
モデル蒸留では、教師の文章を無批判に正解とせず、人手レビュー済みの評価セットを用意します。根拠のない回答、過度な断定、禁止表現まで模倣しないよう、品質基準と拒否応答の方針を学習データに明示します。
同じ品質の結果を10分の1のコストで5倍の速度で提供できるようになりました、という改善例もあります。ただし再現性はデータ、モデル規模、評価基準で変わるため、自社の正答率と1件当たり費用で判断します。
- 教師・生徒モデルに同一の業務評価セットを適用する
- 正解だけでなく拒否すべき入力もデータ化する
- 蒸留後は安全性・幻覚・形式遵守を再評価する
Attentionとキャッシュを用途別に最適化する
答えは、長文処理ではKVキャッシュとAttention方式を先に確認することです。FlashAttentionはメモリI/Oを抑え、GQAやMQAはKVヘッドを共有してキャッシュ容量を抑えるため、Decodeの詰まりを軽減できます。
会話履歴が無制限に伸びる設計では、モデルを軽くしてもKVキャッシュが支配的になります。Sliding Window Attention、履歴要約、検索による必要文脈の再取得を使い、常に全履歴を渡さないプロダクト設計へ変えます。
KV キャッシュ 6GB → 1GB、レイテンシ 120ms → 15msという改善値は、メモリ管理の影響の大きさを示します。モデル精度を維持できるかは文脈長に左右されるため、短文・長文・混雑時の3条件で検証します。
- 長い会話は要約・検索・ウィンドウ化を組み合わせる
- KVキャッシュの容量とヒット率を別々に観測する
- Attention方式の変更後は長文品質を重点評価する
GPUコスト削減を単価ではなく処理量で判断する
費用は1リクエスト当たりのTCOで比べる
答えは、GPUの時間単価ではなく、1,000トークン・1リクエスト当たりの総コストで比較することです。GPU料金だけでなく、ストレージ、データ転送、監視、ライセンス、運用人件費、再試行まで含めると意思決定が変わります。
GPUコスト削減では、速いGPUが必ずしも高コストとは限りません。時間単価がA機種の2倍でも、処理時間が3分の1に短縮されるなら、トータルコストはA機種の3分の2に下がります。実トラフィックで測ることが前提です。
利用率が低いまま台数だけを増やすと、費用は直線的に膨らみます。GPU使用率が常時30%以下なら、バッチング、スケジューリング、モデル共有、scale-to-zeroを順に検討し、恒常的な遊休をなくします。
- 費用を入力・出力トークン、成功率、再試行込みで算出する
- GPU単価と処理時間を同じ期間・同じ品質で比べる
- 低利用率の原因を待ち行列、VRAM、I/Oに分解する
需要の形に合わせて調達方式を分ける
答えは、常時負荷にはコミットメント、変動負荷にはオンデマンドやSpotを使い分けることです。1年または3年のコミットメントは予測可能な需要に向き、短期の検証や突発需要は柔軟な方式が適します。
Spotはオンデマンド価格から90%割引になる場合がありますが、2分前通知で中断する可能性があります。中断しても失われないよう、モデル重みの配置、ジョブのチェックポイント、再開キューを設計して初めて有効な選択肢になります。
推論は2〜4倍安価です、という価格差だけで環境を決めないでください。応答保証が必要な対話サービスは安定枠を確保し、再実行可能な要約や埋め込み生成を中断許容枠に寄せると、品質と費用を両立できます。
- 中断できない対話処理は安定した容量に割り当てる
- 再実行可能なバッチ処理は中断許容枠へ寄せる
- 予約率と実使用率を月次で照合する
右サイジングはVRAMと負荷試験で決める
答えは、モデルの重み、KVキャッシュ、同時実行数を合算してVRAMを選ぶことです。ほとんどの仕事では80〜96GBのVRAMは必要ありません。過大なGPUを固定配備する前に、量子化済みモデルで必要量を実測します。
例えば `g6.xlarge`(NVIDIA L4 24GB)は約 $0.55 /h、NVIDIA A10G (24GB) は約 $1.41 /hという比較対象になります。しかし価格だけでなく、対象モデルのTPS、初回応答、同時接続数、起動時間まで同条件で試験します。
P4dはP3/P3dnと比べてML学習コストを60%削減し、深層学習性能を平均2.5倍向上とされます。推論では同じ結論にならないため、用途別に処理量当たりコストを測り、CPUや専用アクセラレータも候補に入れます。
- VRAMは重み・KVキャッシュ・実行用バッファを合算する
- 候補機種は同一負荷でTPSとp95を比較する
- 小型GPU複数台と大型GPU1台を運用負荷込みで比較する
モデルルーティングで品質と費用を使い分ける
要求の難易度でモデルを振り分ける
答えは、すべての要求を最大モデルへ送らず、難易度とリスクに応じてモデルを選ぶことです。モデルルーティングは、簡単な抽出や分類を小型モデルへ送り、複雑な推論や高リスク回答だけを高性能モデルへ送る設計です。
振り分け条件には、入力長、言語、タスク種別、機密性、過去の失敗率、利用者の優先度を使えます。ただしルーター自体の判定が遅い、または誤ると逆効果なので、ルールベースから始めて検証データで改善します。
コストを70〜90%削減し、レスポンスタイムを数秒からミリ秒に改善できる可能性は、適切なモデル選択とキャッシュの組み合わせにあります。高品質モデルへのエスカレーション条件を明文化し、安易な品質低下を避けます。
- 定型処理は軽量モデル、高リスク処理は高性能モデルに分ける
- ルールの誤振り分け率を業務評価セットで測る
- 失敗時に上位モデルへ再実行する経路を用意する
投機的デコーディングと並列化を適用する
答えは、小型モデルの候補生成を活用できる場合に投機的デコーディングを検証することです。小型モデルが先に複数トークンを提案し、大型モデルがまとめて検証することで、Decodeの待ち時間を縮められる場合があります。
モデルが1枚のGPUに収まらない場合は、テンソル並列やパイプライン並列を検討します。ただしGPU間通信が増えるため、単純に台数を増やしても速くなるとは限りません。ネットワーク帯域とバッチサイズを含めて測定します。
専用プロセッサ(GPU、TPU、カスタムASIC)を使用して、汎用CPUと比較して10〜100倍の高速化を実現します。ただしこれはワークロード適合が前提であり、短い要求や小型モデルではCPU推論の方が運用しやすい場合もあります。
- 投機的デコーディングは受理率と品質を同時に監視する
- 並列化では通信時間をGPU計算時間と分けて測る
- 小型モデルはCPU推論も含めて比較する
段階導入で最適化を継続する
答えは、ベースライン計測、1施策の変更、品質確認、段階配備を繰り返すことです。一度に量子化、ルーティング、基盤移行を行うと、改善・劣化の原因が分からず、障害時の復旧も難しくなります。
実運用では、レスポンスタイムは800msから50msに低下し、インフラストラクチャコストは73%減少し、10倍のリクエストを処理できるようになりましたという改善例があります。数値を目標に転用せず、自社の負荷条件で再現性を検証します。
最適化はリリースで終わりません。入力長、モデル利用比率、キャッシュ命中率、単位処理コストを定例で見直し、利用傾向の変化に追従します。外部の専門チームと連携する場合も、測定責任と品質基準は発注側で明確に保持します。
- 変更は1つずつ行い、前後の品質・費用・遅延を比較する
- カナリア配備中は上位モデルへの退避経路を残す
- 月次で処理量当たりコストとモデル配分を見直す
まとめ
AI推論の性能は、モデル単体では決まりません。入力・出力の特性を測り、圧縮、キャッシュ、基盤、GPU調達、ルーティングを一つの運用設計として結び付けることで、品質を損なわずに応答性と費用対効果を改善できます。
要点
- 最初にp95・p99、TPS、VRAM、処理当たりTCOのベースラインを取る
- 量子化とキャッシュを検証し、品質評価セットで安全性を確認する
- GPU時間単価ではなく、成功した1リクエスト当たりの総コストで比較する
- モデルの難易度別振り分けと段階配備で、性能と品質の両立を図る
- 可観測性を継続し、利用傾向の変化に合わせて設定を更新する
まずは代表的な1業務を選び、入力長・出力長・p95レイテンシ・GPU使用率・1件当たり費用を計測してください。数値を起点に小さく検証すれば、自社に必要な改善策と、投資すべきAI実行環境を具体的に判断できます。
よくある質問
Q1. AI推論最適化は、最初に何から始めるべきですか?
代表的なリクエストを用意し、初回応答時間、p95レイテンシ、TPS、VRAM、1リクエスト当たりの総コストを測定することから始めます。その後、量子化やキャッシュなど影響範囲の小さい施策を1つずつ検証します。
Q2. 量子化すると必ず品質は落ちますか?
品質影響の大きさはモデル、精度形式、業務タスクで異なります。一般的な傾向だけで判断せず、自社の正解データ、長文入力、固有名詞、数値を含むケースで量子化前後を比較してください。
Q3. GPUコストを下げるにはSpotだけで十分ですか?
十分ではありません。Spotは中断リスクがあるため、再試行可能なバッチ処理に向きます。対話サービスでは、モデル圧縮、連続バッチング、GPU共有、オートスケーリング、モデル振り分けを組み合わせる必要があります。
Q4. モデルルーティングはどのような業務に向いていますか?
分類、抽出、定型要約のように難易度を判定しやすい業務に向いています。高い正確性や安全性が必要な要求は上位モデルへ送る条件を定め、誤判定時に再実行できる設計にしてください。
Q5. AI推論基盤で継続監視すべき項目は何ですか?
利用者視点では初回応答時間、p95・p99、エラー率を、基盤視点ではGPU使用率、VRAM、待ち行列、キャッシュ命中率、処理当たりコストを監視します。モデル版と入力長を紐付けると原因分析が容易です。
参考文献・出典
  bloomax Token Factory # 企業向けAI推論基盤「Token Factory」…
bloomax.co.jp