2026.11.06
AI評価自動化で品質を継続的に高める実践法
IT関連
AI評価自動化は、AIやソフトウェアの出力を一定の基準で繰り返し測定し、品質低下を早く発見する仕組みです。モデルやプロンプト、検索データが頻繁に変わる環境では、人手だけの確認では見落としと遅延が起こりやすくなります。
従来のテスト自動化は、決められた入力に対する画面やAPIの挙動確認が中心でした。一方で生成AIでは、正確性だけでなく、根拠性、安全性、文脈理解、回答の一貫性まで確認する必要があります。そのため評価対象と合否基準を先に定義することが重要です。
本記事では、評価対象の切り分け、AI評価基盤とデータセットの設計、LLM・RAGの測定、CI/CDへの接続、人が担う判断を解説します。開発チームが小さくても始められるよう、導入順序と監視の実務ポイントを具体的に整理します。
AI評価自動化とは何かを最初に整理する
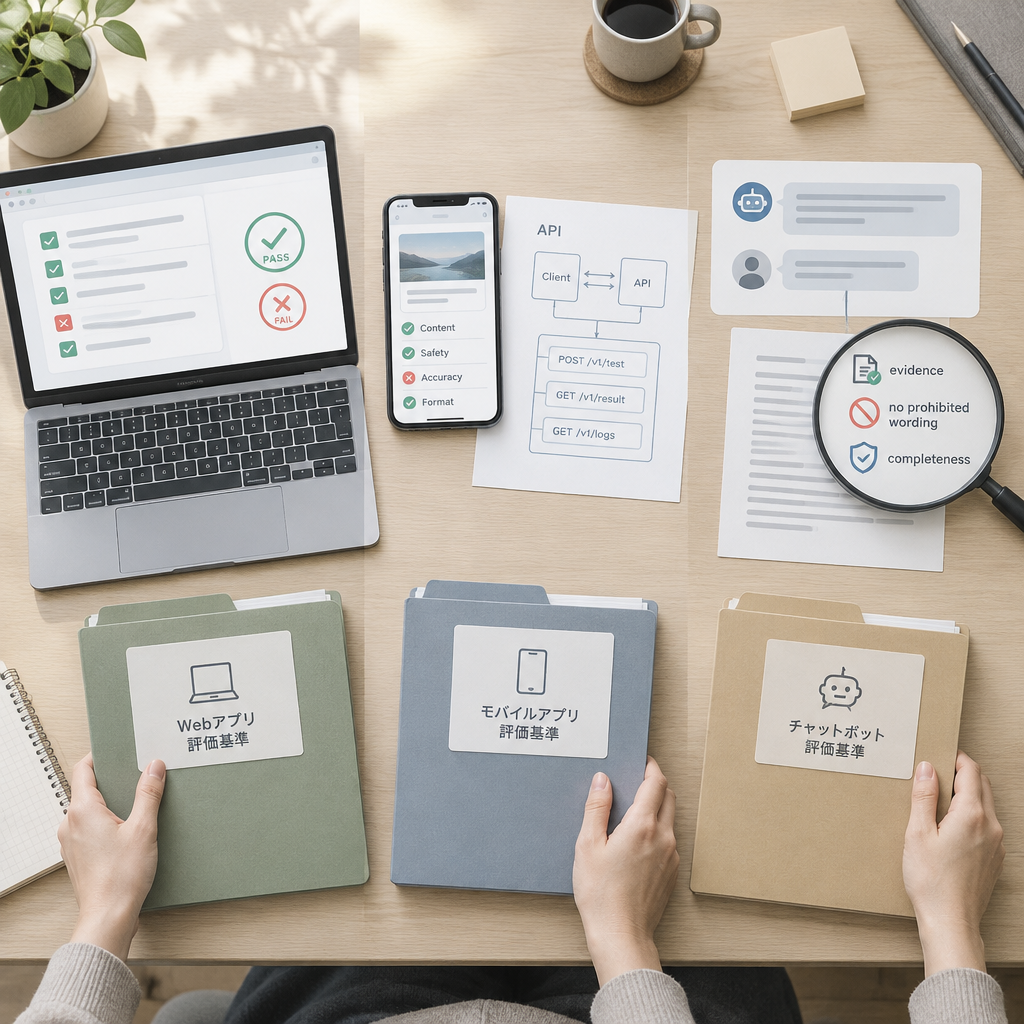
評価対象ごとに合否の意味を分ける
AI評価自動化で最初に行うべきことは、何を評価し、何を合格とするかを用途別に定義することです。Web画面、モバイルアプリ、API、LLM応答では、入力も期待値も失敗時の影響も異なります。対象を一括りにすると、意味のないスコアだけが残ります。
業務システムでは、画面遷移、権限、計算結果、API応答などをテストケースとして固定できます。生成AIでは、正答が一つに定まらない質問も多いため、根拠の有無、禁止表現、回答の完全性、利用者にとっての有用性を採点軸として追加します。
たとえば社内規程を案内するチャットボットなら、もっともらしい誤答を返さないことが重要です。回答文の流暢さだけで合格にせず、参照文書に裏付けられるか、分からない場合に保留できるかを、AI出力検証の条件に含めます。
| 評価対象 | 主な入力 | 主な判定基準 |
|---|---|---|
| 業務システム | 操作・API要求 | 仕様どおりの動作 |
| LLM応答 | 質問・会話履歴 | 正確性・安全性 |
| RAG回答 | 質問・検索文書 | 根拠との整合 |
- 評価対象:画面・API・モデル・プロンプト・検索データ
- 評価入力:固定テスト、実利用ログ、境界値、危険プロンプト
- 合否条件:機能、正確性、安全性、根拠性、応答時間
従来の自動テストとの違いを理解する
AIを使うテスト自動化は、テストケースやスクリプトの生成、実行結果の分類、失敗原因の推定、修復候補の提示までを支援します。従来型の自動化より保守範囲を広げられますが、AIが出した修正案を無条件に採用してよいわけではありません。
実務では、画面仕様、DOM構造、テストデータ、実行ログが整っているほど自動化の精度が上がります。要件が曖昧なまま生成に任せると、もっともらしいテストが増えても、重要な業務ルールや例外処理を検証できない状態になりがちです。
導入効果の例として、テスト実行工数を52%削減したケースが示されています。ただし、この数値を自社へそのまま当てはめるのではなく、実行時間、レビュー時間、失敗の再調査時間を導入前から分けて測定する姿勢が欠かせません。
- AIに任せやすい工程:反復実行、ログ分類、変更箇所の候補抽出
- 人が担う工程:業務リスク判断、仕様の優先順位付け、最終承認
- 整備すべき資産:画面仕様、DOM、テストデータ、実行ログ
自動化率ではなく信頼性で効果を測る
効果測定では、自動化率だけで成功を判断しないことが重要です。自動で走った件数が多くても、重大な欠陥を見逃せば価値は下がります。欠陥検出率、偽陽性、偽陰性、リリース遅延、人的レビュー時間を、同じ期間単位で継続して比較します。
画面変更への追従やスクリプト更新にかかる作業は、導入効果を左右する大きな要素です。メンテナンス作業を85%削減した事例があっても、対象画面の安定度、既存テストの品質、運用担当者の確認手順によって結果は変わります。
評価結果に対して人手レビューとの一致率を記録すると、判定器の過信を防げます。評価モデルが不合格とした理由、逆に通過させた危険な出力を保存し、閾値や採点プロンプトを見直す循環を作ることが、持続するAI評価自動化につながります。
- 測定する指標:欠陥検出率、再現率、偽陽性、レビュー時間
- 評価の単位:リリース、モデル版、プロンプト版、データセット版
- 見直しの契機:重大障害、評価不一致、仕様変更、データ更新
AI評価基盤で再現可能な判定を作る
評価基盤は結果を再現するための共通基盤である
AI評価基盤は、評価データ、実行条件、モデル設定、採点結果、承認履歴を一元管理する仕組みです。単なるダッシュボードではなく、同じ入力と設定なら同じ判定を追跡できるようにする、品質運用の土台として設計します。
基盤には、評価実行API、データ保管庫、結果ストア、ログ検索、通知、リリース判定を接続します。モデル名、温度、プロンプト、検索インデックス、評価者モデルの版を記録しなければ、スコア悪化が起きても原因を切り分けられません。
長文コンテキストを扱うモデルでは、入力条件の差が判定に大きく影響します。たとえば256Kコンテキストを扱える構成でも、実際に投入した文書量、切り出し方法、会話履歴を保存して初めて、評価結果の比較に意味が生まれます。
- 必須記録:モデル設定、プロンプト、検索データ版、評価結果
- 接続先:CI/CD、ログ基盤、チケット管理、承認ワークフロー
- 重要な性質:再現性、追跡性、アクセス制御、変更履歴
能動的な評価で未知の失敗を探す
固定問題だけの評価では、既知の品質しか確認できません。評価基盤は、実利用に近い質問、境界条件、攻撃的な指示、文化的に誤解されやすい表現を追加生成し、未知の失敗を探索できるようにすることが有効です。
特にハルシネーション、差別的表現、犯罪助長、個人情報の推測は、正答率だけでは検知しにくい領域です。業務の危険度に応じて、回答拒否が正解となる問題や、人間へのエスカレーションが正解となる問題も用意します。
評価環境やモデル更新の節目は、日時を含む変更記録で統制します。たとえば2025-12-17に確定した評価設定として保存すれば、後日の比較で『何が変わったか』を説明できます。日付だけでなく、承認者と変更理由も残す運用が重要です。
- 未知の失敗を探す入力:境界値、曖昧表現、敵対的指示、長文質問
- 評価する危険:誤情報、偏見、秘密漏えい、危険行為の助長
- 変更管理:実行日時、設定差分、承認者、変更理由
リリース承認へ評価結果を接続する
AI評価基盤は、スコアを眺めるだけでは成果につながりません。重大カテゴリで不合格ならデプロイを止める、軽微な劣化は担当者レビューへ送る、といった判定ルールをリリース工程に接続して初めて機能します。
すべての指標に単一の閾値を設定する方法は危険です。たとえば回答の形式不備は軽微でも、法務・医療・金融の誤案内は低頻度でも重大です。業務影響、利用者数、復旧可能性を基に、カテゴリごとの許容範囲を定義します。
ALION株式会社のように専属チームで開発伴走を行う体制では、開発者だけでなく業務担当者、品質担当者、運用担当者が同じ評価画面を見る設計が有効です。技術的な異常と業務上の受容可否を分離し、責任ある承認経路を明確にします。
- 停止条件:重大安全性違反、根拠なしの重要回答、権限逸脱
- 要レビュー条件:品質劣化、低頻度の例外、採点の不一致
- 記録すべき事項:判定、承認者、対応期限、再評価結果
AI評価データセットを品質資産として育てる
良い評価データは期待値を明文化している
AI評価データセットは、質問文を集めただけの一覧ではありません。各データに入力、期待する回答または許容範囲、採点基準、難易度、分類、出典、機密区分を持たせることで、評価の再利用性と説明可能性を高めます。
生成AIでは完全一致の正解を置けない問題もあります。その場合は、必須の事実、禁止すべき断定、必要な注意書き、参照すべき根拠を定義します。ポイントワイズ評価とペアワイズ評価を使い分け、文章の表現差ではなく業務上の品質差を測ります。
評価データセットには通常 100 以上のデータポイントが含まれています。ただし件数を先に目標化するより、重大な業務フロー、失敗履歴、利用頻度の高い質問を優先して被覆することが、初期セットの有効性を高めます。
- データ項目:入力、期待値、採点基準、分類、出典、版番号
- 優先対象:重要業務、頻出質問、過去障害、法令・安全領域
- 評価方式:完全一致、ルーブリック、ペアワイズ、計算ベース
分割と秘匿化でデータ汚染を防ぐ
AI評価データセットは、訓練用・検証用・テスト用を混在させないことが原則です。小規模データセット(1,000件未満)では70-15-15、大規模(10,000件以上)では80-10-10という分割の目安があります。
評価問題が学習データやプロンプト例に混入すると、実力ではなく記憶を測る結果になります。特に公開ベンチマークや繰り返し利用する社内問題は、アクセス権を分け、未公開のホールドアウトセットを残すことが重要です。
顧客情報や社内文書を扱う場合は、氏名、連絡先、契約番号、固有の識別子を匿名化またはマスキングします。元データへのアクセス、加工者、利用目的、削除期限を台帳化し、評価用の複製データが無制限に残らないよう統制します。
- 分割の目的:過学習防止、閾値調整、最終性能の独立評価
- 汚染対策:ホールドアウト、権限分離、問題の非公開化
- 機密対策:匿名化、利用目的の記録、保持期間、削除証跡
日本語と業務文脈の難所を設計する
日本語の評価では、敬語、否定の範囲、略語、方言、社内固有の用語によって回答品質が変わります。標準的な質問だけでなく、曖昧な依頼、複数条件、長い会話履歴、誤った前提を含む質問を入れ、実際の利用場面に近づけます。
前処理はAI開発全体の工数の70〜80%を占めるとも言われます。重複の除去、表記ゆれの正規化、出典確認、アノテーションの不一致解消を省くと、評価スコアの変動原因がデータ品質なのかモデル品質なのか判別できません。
各問題は版番号で管理し、変更理由と承認者を残します。新しい失敗が見つかったら、再発防止用の問題を追加しますが、既存スコアとの連続性も確認します。この更新履歴が、長期的なAIモデル検証の比較可能性を支えます。
- 日本語特有の観点:敬語、曖昧表現、略語、文脈依存、方言
- 品質確認:重複、出典、ラベル一致、偏り、難易度分布
- 更新ルール:版番号、変更理由、承認、旧版との比較
LLM評価とRAG評価指標を実務の品質へ結び付ける
LLM評価は正確性だけでは足りない
LLM評価では、回答が自然であるかだけでなく、指示を守るか、事実が正しいか、危険な要求を適切に拒否できるかを測ります。用途に応じたルーブリックを作り、採点者が異なっても大きく判定がぶれない状態を目指します。
LLM-as-a-Judgeは大量の出力を比較する助けになりますが、評価者モデルにも偏りや見落としがあります。人間評価との一致率を定期的に測り、特定の文体を過大評価していないか、長い回答を高く採点しすぎていないかを校正します。
AI出力検証では、正しい答えだけでなく『答えないこと』を合格にする設計が必要です。根拠文書に情報がない場合、推測を避けて確認先を案内できるかを評価し、もっともらしい補完を不合格として明示します。
- 主要観点:正確性、指示追従、安全性、完全性、文体
- 校正方法:人間評価との比較、評価者間一致、失敗例の再採点
- 拒否評価:不明時の保留、危険要求の拒否、相談先の提示
RAG評価指標は検索と生成を分けて測る
RAG評価指標は、最終回答だけでなく、検索で適切な根拠を取得できたか、回答が根拠に忠実かを分けて確認する指標です。回答が悪い時に、検索失敗なのか、生成失敗なのかを判別できるため、改善作業の優先順位を決めやすくなります。
代表的には、質問に対する文書の関連性、必要な根拠の網羅性、回答と根拠の忠実性、回答の有用性を評価します。検索上位に正しい文書がないならインデックスやチャンク設計を見直し、文書があるのに誤答するならプロンプトやモデル設定を調整します。
RAGでは更新された文書が古い回答へ混ざる問題も起こります。文書の公開日、版、権限、チャンクIDをログに残し、回答ごとに引用元を追跡できる状態にします。これにより、根拠の更新後に必要な再評価範囲を絞り込めます。
- 検索側の確認:関連性、網羅性、権限、更新性
- 生成側の確認:根拠忠実性、要約精度、引用、回答有用性
- 改善の切り分け:検索設定、文書分割、プロンプト、モデル
AIモデル検証を変更単位で実施する
AIモデル検証は、モデルを入れ替える時だけ行うものではありません。システムプロンプト、ツール定義、検索インデックス、埋め込みモデル、ガードレールを変更するたびに、同じ基準で品質が後退していないかを検証します。
変更前後のスコア差には、統計的な揺れと実質的な劣化があります。総合点だけで結論を出さず、カテゴリ別の失敗件数、重要度、再現条件を確認します。特に高リスク質問の1件の悪化は、平均点の小幅改善より重く扱うべきです。
評価結果をリリースノートや承認記録へ残せば、利用部門への説明も容易になります。モデルの能力を過大に約束せず、対応できる範囲、確認が必要なケース、利用者が報告すべき不具合を示すことが、信頼できる運用につながります。
- 評価の契機:モデル変更、プロンプト変更、文書更新、機能追加
- 比較の軸:総合点、カテゴリ別失敗、重要度、再現条件
- 判断の原則:平均値より重大リスク、改善より説明可能性
LLMOps監視と受入テストで運用を安定させる
LLMOps監視はリリース後の劣化を捉える
LLMOps監視は、リリース後に実利用データから品質変化を検知する活動です。事前評価で合格しても、質問傾向、参照文書、外部API、利用量が変化すれば、応答品質やコスト、安全性は変わり続けます。
監視する項目は、応答時間、エラー率、トークン量、拒否率、根拠なし回答率、ユーザー評価、危険表現の検知数です。単発の異常だけでなく、カテゴリ別の傾向や移動平均を見て、静かな品質低下を早めに発見します。
ログには機密情報が含まれる可能性があるため、全文保存を前提にしない設計が必要です。マスキング、アクセス制御、保持期間、目的外利用の禁止を定め、必要に応じてサンプリングした匿名化ログだけを品質分析へ使います。
- 監視対象:品質、遅延、コスト、安全性、利用傾向
- 検知方法:閾値、移動平均、カテゴリ別比較、サンプリング監査
- データ統制:マスキング、権限、保存期間、利用目的
AIモデル監視でドリフトと障害を切り分ける
AIモデル監視では、モデル自体の変化だけでなく、入力分布や検索対象の変化を観測します。利用者が想定外の質問を増やした場合、モデルが壊れていなくても合格率が下がるため、原因を混同しない分析設計が必要です。
監視アラートが出たら、まず対象モデル版、プロンプト版、検索データ版、発生カテゴリ、地域や権限などを確認します。その後、代表的な失敗例を再実行し、再現するか、特定のデータ更新に限られるかを確かめます。
LLMOps監視の目的は、すべてを自動復旧することではありません。誤答が重大な領域では、回答機能を限定し、人による確認へ切り替えることが適切です。ロールバック基準と連絡先を事前に決め、障害時の迷いを減らします。
- 切り分け軸:モデル版、プロンプト版、データ版、質問カテゴリ
- 初動:再現確認、影響範囲推定、機能制限、関係者連絡
- 復旧条件:原因特定、再評価合格、承認記録、監視強化
AI受入テストとAI品質保証に人の判断を残す
AI受入テストは、利用部門が実務上受け入れられる品質かを確認する最終工程です。技術チームの自動評価が高得点でも、現場の言い回し、業務フロー、責任分界、例外時の案内が合わなければ、本番利用での信頼は得られません。
AI品質保証では、自動評価の結果、人手レビュー、利用者からのフィードバックを統合します。自動化は反復確認を高速化しますが、倫理、法令、顧客影響、業務上の優先順位を最終的に判断する責任まで置き換えるものではありません。
試験では、通常操作に加え、権限のない利用、誤入力、緊急時、回答不能時を確認します。リリース前に半日程度の探索的テスト時間を確保すると、固定ケースでは見つからない操作上の違和感や、想定外の会話遷移を発見しやすくなります。
- 受入確認:現場用語、業務手順、例外対応、責任分界
- 人の最終判断:高リスク回答、法令影響、顧客影響、公開可否
- 探索的テスト:通常外操作、曖昧質問、権限違反、緊急時
まとめ
AI評価自動化を成功させる鍵は、ツール導入そのものではなく、評価対象・合否基準・データ・変更履歴・人の承認をつなぐことです。AI品質保証を継続的な運用として設計すれば、モデルやデータの更新速度を落とさずに、利用者に説明できる品質を維持できます。
要点
- 評価対象ごとに、入力・期待値・許容できない失敗を定義する。
- 評価データ、モデル設定、検索データの版を記録し、結果を再現可能にする。
- LLMとRAGは、最終回答だけでなく検索品質と根拠忠実性を分けて測る。
- 監視と受入テストを通じて、自動判定と人の業務判断を補完させる。
- 重大リスクの停止条件とロールバック手順をリリース前に決める。
まずは重要な1業務を選び、失敗すると困る質問や操作を100件程度に整理するところから始めましょう。評価データと実行条件を版管理し、小さな自動評価をCI/CDへ接続して、実測値を基に対象範囲を広げることが堅実な進め方です。
よくある質問
Q1. AI評価自動化は小規模なチームでも始められますか?
可能です。まずは重大な業務フローや頻出質問を対象に、入力・期待値・不合格条件を定義します。少数の評価ケースをCI/CDで定期実行し、失敗例を追加する方法が現実的です。
Q2. LLM-as-a-Judgeだけで品質判定をしてもよいですか?
単独運用は推奨されません。評価者モデルにも偏りや採点の揺れがあるため、人間評価との一致率、重大な不合格例、採点理由を定期的に確認し、評価プロンプトを校正します。
Q3. RAGの回答品質が低い場合、最初に何を確認すべきですか?
検索で正しい根拠文書を取得できているかを先に確認します。関連文書が取得できていない場合はチャンク分割や検索設定を、根拠があるのに誤答する場合はプロンプトやモデル設定を見直します。
Q4. AI受入テストで必ず確認すべきことは何ですか?
通常操作に加え、曖昧な質問、誤入力、権限外の操作、回答不能時、重大な誤案内につながる質問を確認します。利用部門が実務上許容できるかを最終判断することが重要です。
Q5. AIモデル監視でログを保存する際の注意点は?
プロンプトや出力には個人情報・機密情報が含まれ得ます。マスキング、アクセス権、保持期間、利用目的を定め、品質分析には必要最小限の匿名化データを用いる設計が必要です。
参考文献・出典
 OTSUMU KNOWLEDGE # 評価データセットとは?意味・作り方と生成AIでの使い方…
otsumu.co.jp
 1. 情報通信インフラとAI 2. 地域AXと地域経済 3. 国際競争力・経済安全保障 4. AIガバナンス 5. デジタル空間の健全性 6. サイバーセキュリティ 7.…
digital-supporter.net
![Google Cloud…
docs.cloud.google.com