2026.10.20
AIデータ系譜で築く信頼できるAI基盤
IT関連
AIデータ系譜は、AIがどのデータを受け取り、どう変換し、どの判断や出力に至ったかを追跡する仕組みです。生成AIや予測モデルを業務へ広げるほど、「なぜこの回答になったのか」を示せないことが、品質事故や利用停止の原因になります。
従来のデータ管理では、テーブル単位の来歴を把握できれば十分な場面もありました。しかしAIでは、学習データ、特徴量、プロンプト、検索結果、モデルの版数、推論結果までをつなげて管理する必要があります。データだけでなく、意思決定に至る経路そのものが管理対象です。
本記事では、AIデータ系譜の定義から、AIデータガバナンス、AIデータカタログ、AIデータ品質、AIデータ越境、AI監査対応までを実務の流れに沿って解説します。AIレジストリやAIモデルカード、AIデータ契約を連携させ、運用に定着させる方法を確認しましょう。
AIデータ系譜とは何かを正しく理解する
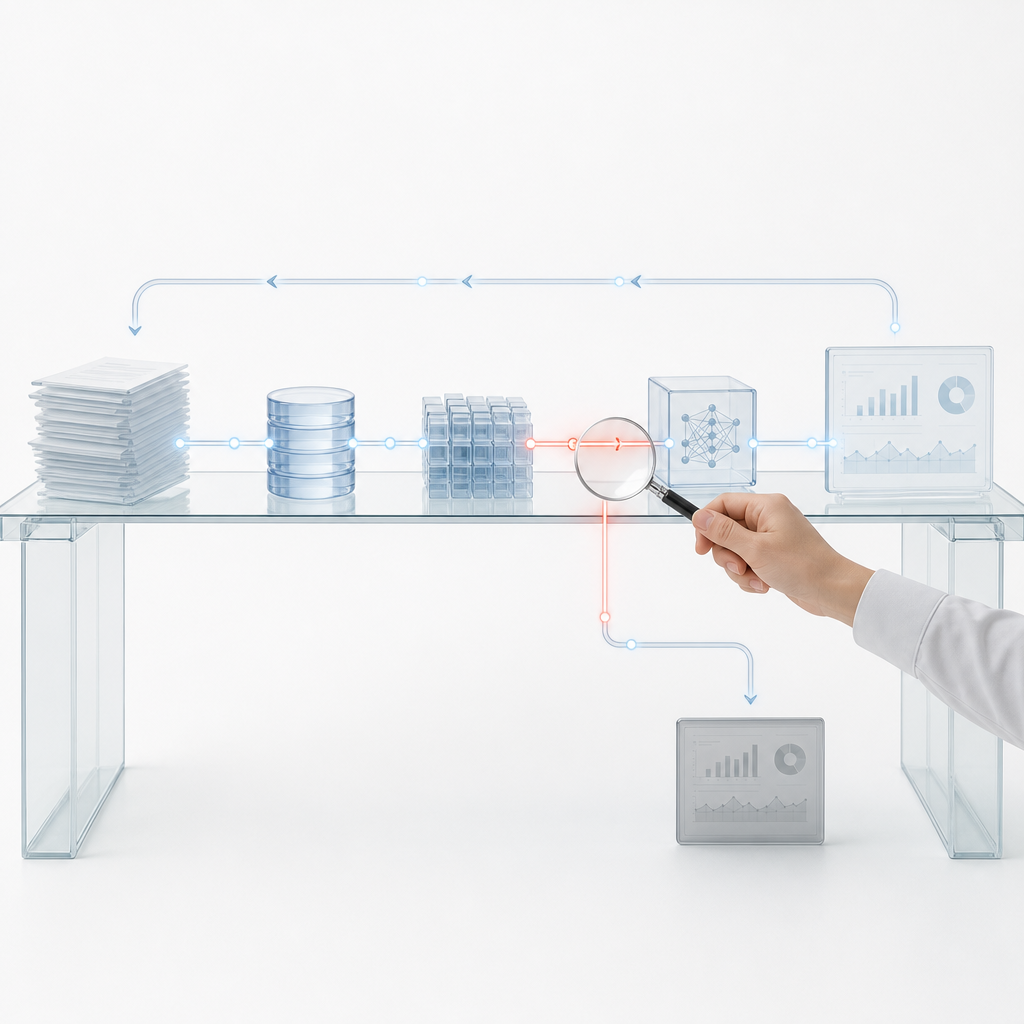
出所から意思決定までを追跡する仕組み
AIデータ系譜とは、データの出所、取得、加工、保存、利用先を連続して記録する仕組みです。AIではさらに、学習に用いたデータセット、特徴量生成、モデル学習、推論入力、最終出力までを結びます。障害や誤回答が起きた際、原因を推測ではなく証跡から特定できる点が重要です。
たとえば需要予測の数値が急変した場合、元の販売データ、欠損値補完の処理、特徴量の定義、採用モデル、推論実行日時を順に確認します。系譜があれば影響範囲を逆方向にも追えるため、誤ったダッシュボードや下流モデルを早期に止められます。
公開情報には、データ処理エラーを30%削減し、規制遵守報告時間を40%短縮しましたという導入成果もあります。数値そのものを目標にするのではなく、障害の発見から影響分析、復旧、説明までの時間を短縮する設計として捉えることが実践的です。
- 入力・変換・出力を識別子で結ぶ
- モデル版数と実行条件も記録する
- 下流への影響と上流の原因を双方向で調べる
プロヴィナンスとの違いと粒度の選び方
データプロヴィナンスは、主にデータの由来や信頼性を示す概念です。一方のAIデータ系譜は、由来に加えて処理の流れと依存関係を可視化します。両者は対立するものではなく、プロヴィナンスが「どこから来たか」、系譜が「何を経てどこへ影響したか」を担います。
粒度は用途に合わせて決めます。粗粒度ではシステムやテーブル間の流れを把握し、スキーマレベルでは項目構造の変更を追います。説明責任や個人情報の判定が必要なら、列レベルの系譜まで取得し、計算式やマスキング処理の履歴を残すことが有効です。
代表的な分類には4つのタイプがあります。業務目的で見るビジネス系譜、技術的な実装を追う技術系譜、処理実行を示す運用系譜、監査の証拠に使うコンプライアンス系譜です。最初から細粒度を全資産へ求めず、重要な意思決定から範囲を広げます。
- プロヴィナンスは由来、系譜は依存関係と変換経路
- 粒度はシステム、テーブル、列、処理ロジックで選ぶ
- 高リスク用途から列レベルの記録を優先する
AIライフサイクルで追うべき証跡
AIの説明可能性を確保するには、データ基盤だけでなくAIライフサイクル全体を追跡します。学習前には収集根拠と利用許諾、学習中にはデータ分割と特徴量、推論時には入力、プロンプト、参照文書、出力、利用者への提示内容を残します。
RAGでは、同じ質問でも検索インデックスやアクセス権、ランキング条件が変われば回答が変化します。そのため、参照した文書の版数、チャンク識別子、ベクトル化の設定、検索時刻を系譜に含めます。これにより、根拠のない回答や古い規程の引用を再現可能な形で調査できます。
データ配布 (40%)、データ多様性 (37%)、データダイナミクス (41%)は、系譜管理を難しくする代表的な要因です。バッチ処理だけでなく、ストリーミング、外部SaaS、ファイル共有を含め、取得できない経路は手動登録と承認で補完する運用が欠かせません。
- 学習・評価・推論・業務利用を一つの連鎖として扱う
- RAGは参照文書と検索条件を記録する
- 自動取得できない処理は申告・承認で補完する
AIデータガバナンスで品質と責任を整える
AI向けの統制はデータ利用の条件を実装すること
AIデータガバナンスは、AIが扱うデータの利用目的、権限、品質、保持、監視を一貫して統制する活動です。規程を作るだけでは十分ではなく、パイプライン、RAG、AIエージェントの実行時にルールが適用される状態を目指します。系譜は、その統制が実際に機能したことを示す基盤になります。
調査では、25%の企業がすでにAIと自動化に対応するためにガバナンスフレームワークを確立しています。一方で、高品質で包括的なメタデータを整備している企業は22%にとどまります。方針と現場の実装に隔たりがあるため、重要データから記録項目を絞ることが現実的です。
NISTのAIリスク管理フレームワークやISO/IEC 42001は、リスクの特定、測定、管理、説明の考え方を整理する際に役立ちます。自社の規程へ取り込む場合も、外部基準を写すのではなく、データオーナー、モデルオーナー、運用担当者が何を承認するかに落とし込みます。
- 方針をデータ処理と推論の実行条件へ反映する
- 系譜を統制の実施証跡として使う
- 責任者と承認対象を具体的に定義する
AIデータ品質は測定と系譜を結び付ける
AIデータ品質は、入力データが目的に適しているかを継続的に評価する取り組みです。正確性(実態と一致しているか)、完全性(必要な項目が欠けていないか)、一貫性(システム間で矛盾がないか)、鮮度(いつ時点のデータか)、そして一意性(重複がないか)を共通指標にします。
品質異常を検知したら、単にエラー件数を示すだけでは不十分です。AIデータ系譜で、異常がどのデータソースから入り、どの特徴量、検索インデックス、モデル出力へ波及したかを結び付けます。影響を受けない処理まで止めずに済むため、復旧判断の精度が上がります。
品質チェックが手作業・属人的で、継続できないことは典型的な失敗です。入力時の形式検証、変換後の分布監視、出力後のサンプリング評価を自動化し、人による確認は閾値変更や例外承認に集中させます。月に一度、あるいは四半期に一度の見直しも予定化しましょう。
- 品質指標を入力・変換・出力の各工程で計測する
- 異常と下流影響を系譜上で関連付ける
- 自動検査と人の例外承認を分ける
AIデータ標準化と契約で部門間のずれを防ぐ
AIデータ標準化は、名称、定義、形式、単位、分類、更新頻度をそろえ、部門ごとの解釈のずれを減らす取り組みです。たとえば「顧客」の定義が営業とサポートで異なれば、同じモデルでも集計結果や推薦結果が変わります。系譜は標準定義がどの処理に適用されたかを確認する手掛かりになります。
AIデータ契約は、提供側と利用側の間で、スキーマ、品質条件、更新頻度、利用目的、変更通知を合意する仕組みです。データ提供者が列名や値域を変更する場合、契約と系譜を照合すれば、影響を受けるモデルや帳票を事前に通知できます。
最初は10〜30個のコア用語からビジネス用語集を整えると、現場の負担を抑えられます。重要な用語にはオーナー、定義、許容値、関連するデータ資産を登録し、変更にはレビューを設けます。AIデータ標準化は一度の棚卸しではなく、運用で更新される共通言語です。
- 名称と業務定義の両方をそろえる
- 変更通知と影響分析をAIデータ契約に組み込む
- 用語集は重要度の高い用語から段階的に育てる
AIデータカタログを系譜の入口にする
カタログは資産の発見と利用判断を支える
AIデータカタログは、テーブル、ファイル、API、文書、モデルなどの資産を検索し、意味や利用条件を確認するための台帳です。データディクショナリより対象が広く、技術メタデータだけでなく、業務定義、所有者、品質、アクセス権、AIデータ系譜を関連付けて扱います。
利用者はカタログで「どのデータを使えるか」だけでなく、「誰が管理し、どの更新頻度で、AI利用が許可されているか」を判断します。RAG(Retrieval-Augmented Generation)の候補文書を選ぶ場合も、権限、機密区分、鮮度、根拠となる系譜を参照させることで、誤利用の抑止につながります。
何千ものデータ資産を抱える組織では、検索結果の量より信頼性が課題になります。AIがタグや説明文を補完しても、重要資産はデータスチュワードがレビューし、修正履歴を残しましょう。生成された説明をそのまま正とせず、人の承認を経たメタデータを利用条件にします。
- 技術・業務・運用・管理のメタデータを統合する
- 検索結果に権限、品質、系譜を併記する
- AI生成のタグや説明は重要資産で人が承認する
接続基盤の情報は再現可能な形で残す
AIデータカタログの導入では、接続設定や処理基盤の版数も記録対象です。たとえばSpark環境を使うなら、spark-3.5.6-bin-hadoopのような実行環境の識別情報を残します。障害時に同じ条件で検証でき、系譜上の変換結果と環境差分を切り分けやすくなります。
Apache Icebergを利用する構成では、iceberg-aws-bundle-1.9.2.jarのような依存コンポーネントも、パイプラインの実行情報と紐付けます。ライブラリ更新によって読み取り結果やスキーマ解釈が変わる可能性があるため、ソースコードだけでなく実行環境の証跡が必要です。
カタログの利用量も運用コストとして把握します。Purviewは$0.0165/アセット/日の従量とされるため、不要な資産を無制限にスキャンするのではなく、対象範囲と更新頻度を優先度で決めます。メタデータの鮮度と費用の両方を確認することが重要です。
- 実行環境と依存ライブラリの版数を系譜に結び付ける
- スキャン対象と更新頻度を重要度で分ける
- メタデータ更新の費用対効果を継続確認する
アクティブカタログを安全なAI利用へ接続する
アクティブなAIデータカタログは、資産情報を検索するだけでなく、利用時の制御へ反映します。AIエージェントがデータにアクセスする前に、カタログから用途、機密度、品質スコア、利用許可を取得し、条件を満たさない資産を候補から除外する設計が有効です。
MCP(Model Context Protocol)やA2A(Agent to Agent)を採用する場合も、ツール呼び出しごとに利用主体、対象資産、目的、結果を記録します。AIエージェントの利便性を優先して権限を広げると、検索プレビューやログから機密情報が漏れるおそれがあるため、最小権限を徹底します。
外部APIを使う処理では、$1/100万リクエストのような従量課金も含めて利用実績を可視化します。コスト監視は経理目的だけではありません。異常な呼び出し増加は、誤ったエージェント設定、無限ループ、意図しないデータ取得を検知する運用指標になります。
- カタログの情報を実行時の許可判定へ使う
- エージェントのツール呼び出しを監査可能にする
- コスト異常をアクセス異常の兆候として監視する
AIデータ越境と保護要件を系譜で管理する
越境利用では保存場所だけでなく処理経路を確認する
AIデータ越境では、データが保存される国や地域だけでなく、収集、変換、学習、推論、ログ保管、委託先サポートまでの経路を把握する必要があります。クラウドリージョンが国内でも、外部AIサービスへの送信や海外拠点による運用で、データ移転が発生する可能性があります。
AIデータ系譜に地域、委託先、転送目的、暗号化状態、保持期間を記録すれば、越境が発生する地点を一覧できます。個人情報、営業秘密、知的財産を同じ基準で扱わず、データ分類ごとに利用可能なモデル、リージョン、処理方式を定めることが大切です。
GDPR、HIPAA、CCPAなどの外部規制を参照する場合も、自社のデータフローに対応付けて考えます。法令名を列挙するだけでなく、どのデータがどの目的で、どの契約と同意に基づき、どの処理へ送られたかを追跡できる状態が、実務上のリスク低減につながります。
- 保存先、処理先、ログ保管先を分けて把握する
- 分類ごとに利用可能なAIサービスを定義する
- 移転目的と根拠を系譜上の属性として残す
個人情報と機密情報は利用前に制御する
保護すべきデータは、AIへ入力する前に検出・分類・制御することが基本です。個人情報や機密情報を含む列には、マスキング、トークン化、暗号化、アクセス制御を適用し、処理後に復元が必要なケースでは復元権限も分離します。系譜には適用した保護処理を残します。
RAGの文書登録では、原文にアクセスできる人と、検索結果を閲覧できる人が一致しない場合があります。チャンク化やベクトル化によって保護対象が消えるわけではないため、原文の分類を継承し、検索結果の表示やAIへの投入にも同じポリシーを適用する必要があります。
ALION株式会社のように国境を超えたワンチーム開発を支援する体制では、開発者、運用担当、委託先ごとの権限設計が特に重要です。共有範囲をプロジェクト単位で限定し、開発・検証・本番を分離したうえで、誰がどのデータへアクセスしたかを系譜と監査ログに残します。
- 保護処理の有無と方式をデータ属性として記録する
- ベクトル化後も原文の機密分類を継承する
- 開発・検証・本番のアクセス経路を分離する
データ契約を委託先と共同で運用する
AIデータ契約は、社内の部門間だけでなく、クラウド事業者、開発委託先、データ提供者との間でも必要です。契約には、利用目的、再委託、保存地域、削除方法、インシデント連絡、モデル学習への利用可否を明記し、系譜で実際の処理経路と照合できるようにします。
契約上は利用可能でも、実装が想定外の経路を通ればリスクになります。たとえば検証用データを外部の生成AIへ送る、サポートログへ入力内容が残る、バックアップが別地域へ複製される、といった経路を設計段階で洗い出し、承認対象に含めます。
AIデータ越境の判断を法務だけへ委ねると、技術的な変更を見落としがちです。データオーナー、セキュリティ、法務、開発、運用が同じ系譜図を参照し、変更申請時に影響を確認する仕組みを作ります。これにより、契約と実装の乖離を早期に発見できます。
- 契約条件をデータと処理の属性へ落とし込む
- 検証環境、ログ、バックアップも確認対象に含める
- 変更申請に法務と技術の共同レビューを組み込む
AI監査対応を支えるレジストリとモデルカード
監査対応は証拠を後から集めない設計にする
AI監査対応で最も重要なのは、説明を求められてから資料を探すのではなく、運用中に証跡を蓄積することです。AIデータ系譜を中心に、入力データ、変換、承認、モデル、推論、出力、変更履歴を結べば、特定の判断について根拠を一貫して提示できます。
金融領域ではBCBS 239、バーゼルIII、ソルベンシーII、CCARなど、報告の正確性や追跡可能性が重視されます。業界固有の規制に限らず、監査人や顧客から「この結論はどの情報に基づくか」と問われたとき、同じ手順で説明できる状態を目標にします。
監査証跡には、成功した処理だけでなく失敗、却下、例外承認も含めます。AIが参照を拒否したケースや、品質ルール違反でデータを隔離したケースを残すことで、組織が統制を実装していることを示せます。ログの改ざん防止と保持期間の設計も同時に行いましょう。
- 証跡を日常運用で自動収集する
- 成功・失敗・例外承認を同じ基準で記録する
- 監査の質問を系譜から再現できるようにする
AIレジストリでモデルの状態と責任を管理する
AIレジストリは、モデルやAIアプリケーションの名称、用途、所有者、版数、承認状態、配置先、廃止状況を管理する台帳です。データカタログがデータ資産の入口なら、AIレジストリはモデル資産の入口です。両者を系譜で結ぶことで、どのモデルがどのデータへ依存するかを可視化できます。
モデルを本番へ昇格する前には、学習データの利用許諾、評価結果、セキュリティ確認、リスク分類、監視計画を登録します。モデルの更新時は、新旧の版数、変更理由、再評価結果、影響を受ける業務を記録し、承認済みの版数だけを本番環境から呼び出すようにします。
AIレジストリを単なる一覧表にしないため、デプロイ環境の実行ログと連携します。未登録のモデルや承認期限切れのモデルが使われた場合に検知できれば、シャドーAIの抑止になります。廃止したモデルの推論APIや参照データを確実に停止するためにも、依存関係の管理が必要です。
- モデルの用途、所有者、版数、承認状態を一元管理する
- 本番利用は承認済みの版数へ限定する
- 廃止時はAPIとデータ依存関係を同時に止める
AIモデルカードで利用条件と限界を伝える
AIモデルカードは、モデルの目的、想定利用者、入力条件、評価方法、既知の制約、禁止用途、監視方法を説明する文書です。モデルの精度だけを示す資料ではなく、どの条件なら信頼して使えるかを利用者へ伝えるための運用文書として扱います。
モデルカードには、AIデータ系譜への参照を入れます。学習データの概要、データ品質の評価、特徴量の定義、評価時点、参照文書の更新条件をリンクすれば、説明を簡潔に保ちながら詳細な根拠へ到達できます。データが変わればモデルカードも更新対象になります。
導入後は、系譜の完全性、メタデータの充足率、品質異常の検知時間、影響分析の所要時間を追跡します。ある事例では統合時間を50%短縮しましたとされますが、自社でも基準値を測定してから改善目標を置くことが大切です。数値と責任者を定例で確認し、改善を継続しましょう。
- モデルカードは精度表ではなく利用条件の説明書である
- モデルカードとデータ系譜を相互参照させる
- 完全性・検知時間・影響分析時間を継続測定する
まとめ
AIデータ系譜は、AIの出力を追跡可能にし、品質事故、越境リスク、監査時の説明不足を減らす土台です。データカタログで資産を見つけ、AIデータガバナンスで利用条件を統制し、AIレジストリとAIモデルカードでモデルの責任を明確にすることで、AI活用を安全に拡張できます。
要点
- AIデータ系譜は、データの出所からモデル出力、業務判断までを結ぶ証跡である
- AIデータ品質、AIデータ標準化、AIデータ契約を系譜と連携させると変更に強くなる
- AIデータカタログ、AIレジストリ、AIモデルカードを分断せずに運用する
- AIデータ越境とAI監査対応は、処理経路を継続的に記録して初めて実効性を持つ
- 重要なAIユースケースから始め、測定指標を用いて対象範囲を段階的に広げる
まずは顧客対応、需要予測、社内検索など、影響の大きいAIユースケースを1つ選びましょう。入力データ、変換処理、モデル、出力先、責任者を図にし、記録できていない経路を洗い出すことが、信頼できるAI基盤づくりの第一歩です。
よくある質問
Q1. AIデータ系譜とデータプロヴィナンスの違いは何ですか?
データプロヴィナンスは主にデータの由来や作成根拠を示し、AIデータ系譜は変換処理、依存関係、下流への影響まで追跡します。AIでは両方を組み合わせることで、出力の根拠を説明しやすくなります。
Q2. AIデータ系譜はどこから導入すべきですか?
顧客影響、規制リスク、売上影響が大きいAIユースケースから始めます。入力データ、変換、モデル、出力先、責任者を特定し、重要な経路から自動収集と手動承認を整備する方法が有効です。
Q3. AIデータカタログだけで系譜管理はできますか?
カタログに系譜機能があれば入口として活用できますが、実行ログ、ETLやストリーミングのイベント、モデルレジストリ、RAGの参照履歴との連携が必要です。資産一覧だけでは推論時の根拠まで十分に追えません。
Q4. AIモデルカードには何を書くべきですか?
目的、想定利用者、入力条件、評価方法、既知の制約、禁止用途、監視方法、責任者を記載します。学習データや評価データの詳細はAIデータ系譜と相互参照させると、更新しやすくなります。
Q5. AIデータ越境で確認すべき点は何ですか?
保存先だけでなく、推論先、ログ保管先、バックアップ先、委託先のアクセス先まで確認します。データ分類、利用目的、契約条件、アクセス権を系譜上で追跡し、変更時に再評価できる状態を作ることが重要です。
参考文献・出典
 …
japan.box.com
* [ホームに戻る](https://www.walkme.com/jp/) * JP 購読 …
www.ibm.com