2026.10.21
エージェントメモリで実現する賢いAI設計
IT関連
エージェントメモリとは、AIエージェントが会話、業務履歴、利用者の設定を必要なタイミングで取り出し、次の判断に活用する仕組みです。単に会話ログを長く保存する機能ではなく、根拠ある行動を継続させる設計要素です。
大規模言語モデルは、そのままではセッションをまたぐ事実や経験を安定して保持できません。そこで外部ストレージ、検索、要約、検証を組み合わせ、必要な情報だけをコンテキストへ再投入する構成が重要になります。
本記事では、記憶の分類、RAGとベクトル検索の使い分け、保存から忘却までの運用、セキュリティ、段階的な実装方法を解説します。開発チームが要件定義で確認すべき判断軸も具体的に整理します。
エージェントメモリの役割と基本構造
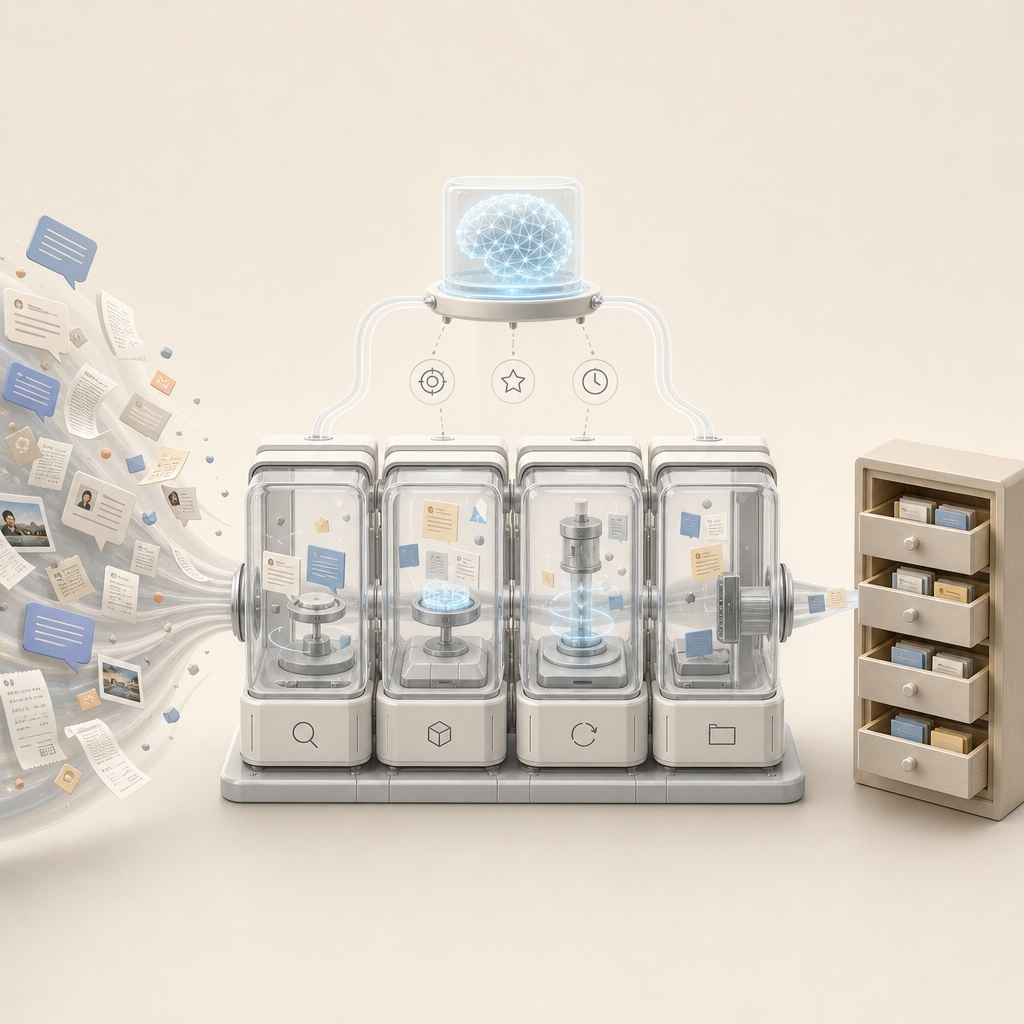
記憶は会話履歴の保存とは異なる
結論として、エージェントメモリは「保存した情報を、目的に応じて選び直す」仕組みです。会話全文を毎回渡す方法では、関係のない情報が混ざり、コスト、遅延、回答の一貫性を悪化させやすくなります。
コンテキスト保持は現在の依頼を処理するための短い作業領域であり、記憶は将来の判断に再利用する候補です。たとえば顧客の配送先変更は、確認済みの情報として保存しても、過去の雑談は通常は残す必要がありません。
設計では「何を覚えるか」より先に、「どの判断で、誰の情報を、どの根拠で再利用するか」を定義します。この順序にすると、不要な個人情報を蓄積せず、回答の説明可能性も高められます。
- 会話コンテキストは現在の処理に必要な情報
- 永続記憶は将来の再利用候補
- 再利用時には根拠と権限を確認
4つの能力を分けて設計する
答えは、記憶を取得、形成、更新、管理という4つの中核的な能力に分けることです。ひとつのデータベースに全責任を持たせるのではなく、各能力に品質基準と責任者を割り当てます。
取得では、質問に関連する候補を検索し、権限と新しさで絞り込みます。形成では、会話や操作履歴から保存価値のある事実だけを抽出し、発言者、時刻、出所、信頼度を付与します。
更新と管理では、重複を統合し、矛盾する情報を保留し、期限切れの情報をアーカイブまたは削除します。記憶を正解として扱わず、検証可能な仮説として扱う姿勢が運用品質を左右します。
- 取得:関連情報を選ぶ
- 形成:保存候補を抽出する
- 更新・管理:鮮度と整合性を保つ
モデルの長い文脈だけには依存しない
結論は、長いコンテキストウィンドウと外部記憶は代替関係ではなく補完関係です。100万(1M)トークンを扱えるモデルでも、全履歴を投入すれば、重要情報の埋没、推論費用、権限判定の難しさが残ります。
Llama 4 Scout(17B、16-expert MoE)やNemotron 3(MoE 120B、12Bのアクティブパラメーター)のようにモデル特性が異なっても、検索対象を絞り込む設計は共通して必要です。モデルの能力だけで記憶品質は保証できません。
実務では、直近会話、ユーザー設定、業務知識、過去事例を別々に扱います。各層から必要最小限を選び、引用元を添えてモデルへ渡すことで、回答の再現性と監査性を両立しやすくなります。
- 長文脈は検索設計を不要にしない
- 情報の鮮度と権限は外部で判定する
- 投入情報には出所を添える
記憶の種類を業務要件から選ぶ
短期記憶と作業記憶は現在の作業に使う
結論として、短期記憶と作業記憶は、いま実行しているタスクを完了するために使います。注文変更の確認、複数ステップの入力、ツール呼び出し結果の照合など、セッション内で失うと困る状態が対象です。
保持期間は数秒から数日まで、業務の完結単位に合わせて決めます。期限を設けないまま作業状態を残すと、古い途中結果を新しい依頼に誤適用し、誤操作や重複実行を招くおそれがあります。
実装では、セッションIDと操作IDを必ず分けます。AgentSessionやagent.create_session()のようなセッション管理を使う場合も、利用者ID、テナントID、権限を明示的に結び付けることが不可欠です。
- 現在のタスクに限定して保存
- セッションと操作を識別
- 完了後は期限に従って破棄
長期記憶は再利用価値で分類する
答えは、長期記憶を一種類にまとめず、再利用する判断の性質で分けることです。エピソード記憶は過去の出来事、意味記憶は安定した事実、手続き記憶は業務手順を表します。
さらに、ペルソナメモリは利用者の応答形式や好み、エンティティメモリは顧客、案件、製品などの属性を扱います。たとえば「簡潔な報告を好む」はペルソナ、「契約更新日」はエンティティとして管理します。
分類を誤ると、個人の一時的発言が恒久ルールとして残ったり、変更頻度の高い契約情報が古いまま参照されたりします。保存時に種類、適用範囲、失効日を必須項目にすると事故を抑えられます。
- 出来事はエピソード記憶
- 安定知識は意味記憶
- 手順と利用者設定は分離して管理
選択基準は保持期間と更新頻度で決まる
結論として、記憶方式は保持期間、更新頻度、検索精度、レイテンシ、データ量の5条件で選びます。利用者の好みのように小さく頻繁に参照する情報と、大量の文書知識を同じ検索経路に置く必要はありません。
下表は、要件定義で最初に比較する目安です。実際には、情報の機密度と削除義務を加え、部門ごとに保存可否を決めます。
特に手続き記憶は、最新の業務ルールへの追随が重要です。履歴として残す情報と、現在有効な手順として参照する情報を分け、後者には承認済みの版だけを使います。
| 項目 | 主な内容 | 更新頻度 | 検索方法 |
|---|---|---|---|
| 短期・作業記憶 | 進行中の状態 | 高い | セッション参照 |
| エピソード記憶 | 対応履歴 | 中程度 | 時系列・類似検索 |
| 意味記憶 | 確定した知識 | 低い | キーワード・ベクトル |
| 手続き記憶 | 承認済み手順 | 改定時 | 版指定検索 |
- 方式は5条件で判断する
- 機密度と削除義務も確認する
- 現行手順には承認済み版を使う
検索精度を支える保存と検索の設計
RAGは記憶を根拠付きで取り出す方法
結論として、RAGは外部知識を検索し、その結果を根拠として回答生成に使う方法です。長期記憶にも有効ですが、検索結果をそのまま信じず、出所、更新日、アクセス権を確認してから利用します。
ベクトル検索は文の意味的な近さを扱える一方、製品番号、規程番号、日付のような厳密一致には弱い場合があります。そのため、キーワード検索とベクトル検索を組み合わせるハイブリッド検索が実務的です。
候補統合にはReciprocal RankingFusion(RRF)を用い、意味検索と文字列検索の順位を統合できます。さらにメタデータフィルタを先に適用し、他テナントや権限外の情報を検索候補から除外します。
- RAGは外部根拠を回答に接続する
- 厳密一致と意味検索を併用する
- 権限フィルタを検索前に適用する
検索パイプラインは5段階で品質を管理する
答えは、保存から利用までを5段階の変換パイプラインとして管理することです。抽出、検証、分類、保存、検索を分離すれば、どの工程で誤情報が混入したかを追跡できます。
抽出時には、会話内の命令文や推測を事実として保存しないルールが必要です。検証では、情報源の種類、作成者、確信度、重複候補を評価し、保存対象かレビュー対象かを振り分けます。
検索時には、3~5の検索クエリを使って観点を補い、上位候補を再ランキングします。ただし検索回数を増やしすぎると遅延と費用が増えるため、業務ごとに上限を測定して決めます。
- 抽出・検証・分類・保存・検索を分離
- 推測と確定事実を区別する
- 検索回数は品質と遅延で調整する
圧縮と重複排除で文脈を小さく保つ
結論として、検索した記憶は必要な部分だけを圧縮してモデルに渡します。大きな文書を丸ごと投入するのではなく、質問への関連度、鮮度、信頼度で並べ替え、引用可能な抜粋を作成します。
一例として、1件の問い合わせに最大4つのチャンクだけを渡す制限を設けると、無関係な文脈の混入を抑えやすくなります。上限は固定値ではなく、正答率とレイテンシの評価結果で見直します。
同じ内容を別表現で保存すると、検索順位が重複情報で占有されます。正規化、ハッシュ比較、エンティティ統合を行い、原文、要約、最新版の関係を明示して保存することが重要です。
- 検索結果は関連箇所へ圧縮する
- チャンク上限は評価で調整する
- 重複は原文と要約の関係で管理する
安全な記憶運用は更新と忘却で決まる
誤った記憶は保存前に隔離する
結論として、会話から抽出した内容を即座に長期保存してはいけません。プロンプトインジェクションや悪意ある発言により、「この指示を恒久ルールとして記憶せよ」といった内容が混入する経路があるためです。
保存候補には、発言者、情報源、抽出ルール、信頼度、レビュー状態を付与します。システム指示、利用者の希望、外部文書の記述を同列に扱わず、信頼できる情報源ほど強い更新権限を持たせます。
矛盾が検出された場合は、既存情報を上書きせず隔離します。たとえば住所変更なら、確認済みの新住所を有効化するまで旧住所を保持し、判断に使った根拠を監査ログへ残します。
- 会話内容を無条件に永続化しない
- 出所と信頼度を必須化する
- 矛盾は上書きではなく隔離する
削除と版管理は最初から実装する
答えは、保存機能と同時に削除、復旧、版管理を設計することです。利用者の訂正や削除の要求に対応するには、どのメモリがどの会話、文書、要約から生成されたかをたどれなければなりません。
実装仕様の例では、個々のメモリは 100 kB(約 25k トークン)が上限です。1つのストアには最大 10,000 件のメモリを保持できます。このような上限を超えたときの書き込み失敗も、事前に業務フローへ組み込みます。
バージョンは書き込まれてから30日間保持されます。過去のメモリバージョンは 30 日後に削除される可能性があります。保持日数を前提にせず、必要な監査記録は別ストレージへ保全する方針が必要です。
- 削除要求に備えて出所を追跡する
- 容量上限時の処理を定義する
- 監査記録は記憶本体と分離する
共有メモリには責任境界を設ける
結論として、マルチエージェントで共有する情報は、全員が自由に書き換える設計にしません。調査、承認、顧客対応などの役割ごとに、参照、提案、確定の権限を分ける必要があります。
同時書き込みでは、最新時刻だけで解決すると、権限の弱い情報が正しい記録を上書きする危険があります。エンティティ単位の版番号、競合状態、承認者を保存し、競合時は人間の確認へ回します。
セッションごとに最大 **8 つのメモリストア**がサポートされる構成でも、用途別ストアは無制限に増やすべきではありません。個人、部署、全社知識を分離し、検索時に横断できる範囲を最小化します。
- 役割ごとに書き込み権限を分ける
- 競合は承認フローで解決する
- 個人・部署・全社の範囲を分離する
実装を成功させる評価と段階導入
既存チャットボットからは段階的に移行する
結論として、ステートレスなRAGチャットボットから永続記憶へ移る際は、小さな対象から始めます。最初に利用者設定など、正誤を確認しやすく、業務影響を限定できる情報だけを保存対象に選びます。
次に、既存ログを一括投入する前に、スキーマと品質基準を確定します。バックフィルしたデータには生成元と投入日時を付け、誤抽出が判明した場合に対象範囲だけロールバックできるようにします。
ALION株式会社のようにシステム開発を専属チームで伴走する体制では、業務担当者と開発者が同じ評価例を確認できます。台湾・日本間の市場支援や国境を越えた開発でも、データ境界と権限設計を早期に合意することが重要です。
- 最初は影響が限定的な情報で開始
- バックフィルに生成元を付ける
- 業務担当者と評価例を共有する
評価は正答率だけで終わらせない
答えは、検索精度、想起率、幻覚率、レイテンシ、コストを同時に測ることです。正答率が高くても、古い顧客情報を参照したり、回答まで長時間かかったりすれば、業務利用では失敗になります。
テストセットには、正しい記憶を想起すべき質問、存在しない情報を拒否すべき質問、権限外情報を出してはいけない質問を含めます。LongMemEvalやLoCoMoのような評価観点も参考にしつつ、自社業務の失敗例を重視します。
評価結果はモデル変更時だけでなく、検索インデックス更新、抽出ルール変更、権限設定変更のたびに確認します。再現可能な評価セットと監査ログがあれば、品質低下の原因を切り分けやすくなります。
- 品質・安全・速度・費用を併測定
- 拒否すべき質問も評価する
- 設定変更ごとに回帰テストする
運用条件をAPI仕様と合わせて確認する
結論として、採用する基盤の容量、更新頻度、命名規則を実装前に確認します。たとえば `agent-memory-2026-07-22` と `managed-agents-2026-04-01` のように、APIや管理機能の識別子が変わる場合、設定の追跡が必要です。
書き込み頻度にも制約があります。同期間隔(デフォルトでは15秒)ごとに最大1回という条件では、リアルタイム更新を前提にした設計は期待どおりに動かない可能性があります。キューイングと再試行を用意します。
運用開始後は、保存件数、検索ヒット率、削除要求、競合件数を定期確認します。メモリストアが10,000メモリの上限に達すると、新しいメモリへの書き込みは失敗します。容量監視を業務アラートへ接続しましょう。
- API識別子と設定変更を追跡する
- 同期制約に合わせてキューを設計する
- 容量上限を監視アラートに接続する
まとめ
エージェントメモリの価値は、情報を大量に残すことではなく、正しい情報を必要な権限のもとで取り出し、古くなれば更新・削除できることにあります。記憶の種類、検索、監査を分けて設計することで、AIエージェントは継続的で信頼できる業務支援へ近づきます。
要点
- 短期・長期・エピソード・意味・手続きの記憶を目的別に分離する
- RAG、ハイブリッド検索、圧縮で必要な根拠だけをコンテキストへ渡す
- 保存前検証、権限制御、版管理、削除を最初から実装する
- 正答率だけでなく安全性、遅延、費用を継続評価する
- 段階導入とロールバック可能なスキーマで運用リスクを抑える
まずは、自社のAIが「誰の、どの情報を、いつまで、何の判断に使うか」を棚卸ししてください。要件整理から検索基盤、権限設計、評価運用まで一貫して進めることで、現場に定着するAIエージェントを構築できます。
よくある質問
Q1. エージェントメモリとチャット履歴の違いは何ですか?
チャット履歴は発話の記録であり、記憶は将来の判断に再利用するために抽出・検証・分類された情報です。履歴をそのまま使うのではなく、関連性、鮮度、権限を確認して参照します。
Q2. ベクトルデータベースだけで記憶を実装できますか?
類似検索には有効ですが、厳密な属性検索、権限制御、版管理、削除監査まで単独で担うのは困難です。リレーショナルストアやオブジェクトストレージ、知識グラフなどと役割を分ける設計が一般的です。
Q3. 古い情報をAIが参照しないようにするには?
各記憶に有効期間、更新日時、情報源、信頼度を持たせ、検索時に鮮度フィルタを適用します。矛盾を検出した情報は自動上書きせず、承認または確認フローに送ることが重要です。
Q4. 最初に保存すべき情報は何ですか?
利用者が明示的に指定した応答形式や、確認済みで変化頻度の低い業務設定から始めると安全です。機密性が高い情報や誤りの影響が大きい情報は、権限・削除・監査の仕組みを整えてから対象にします。
Q5. マルチエージェントで共有する際の注意点は?
各エージェントの参照権限、提案権限、確定権限を分けてください。書き込みの出所、版番号、承認者を記録し、競合時に人間が判断できる状態を維持することが必要です。
参考文献・出典
…
www.mongodb.com
[コンテンツへスキップ](#main-content) [Agents Week](/ja-jp/tag/agents-week/)[AI](/ja-jp/tag/ai/)[エージェント](/ja-jp/tag/agents/)[ストレージ](/ja-jp/tag/storage/) #…
blog.cloudflare.com
[Cole Stryker](https://www.ibm.com/think/author/cole-stryker.html) Staff Editor, AI Models IBM Think…
www.ibm.com