2026.11.21
学習データ汚染を防ぐ信頼できるAI運用の実践法
IT関連
学習データ汚染とは、AIが学ぶデータに誤り、悪意ある情報、偏り、不要な重複などが混入し、出力の信頼性を損なう状態です。モデルが高性能でも、入力となるデータが壊れていれば、業務判断や顧客対応の品質は安定しません。
汚染は、外部サイトの収集、アノテーション、前処理、RAG用文書の登録、追加学習など、複数の工程で起こります。意図的な攻撃だけでなく、更新漏れや権限設定ミスによる混入も多く、技術と運用の両面から管理する必要があります。
本記事では、汚染の種類と影響、AIデータ品質の測り方、追跡可能性を支える管理方法、評価と監視の実践手順を整理します。開発・業務・セキュリティ担当者が同じ基準で対策を進めるための実務的な視点を提供します。
学習データ汚染とは何かを正しく切り分ける
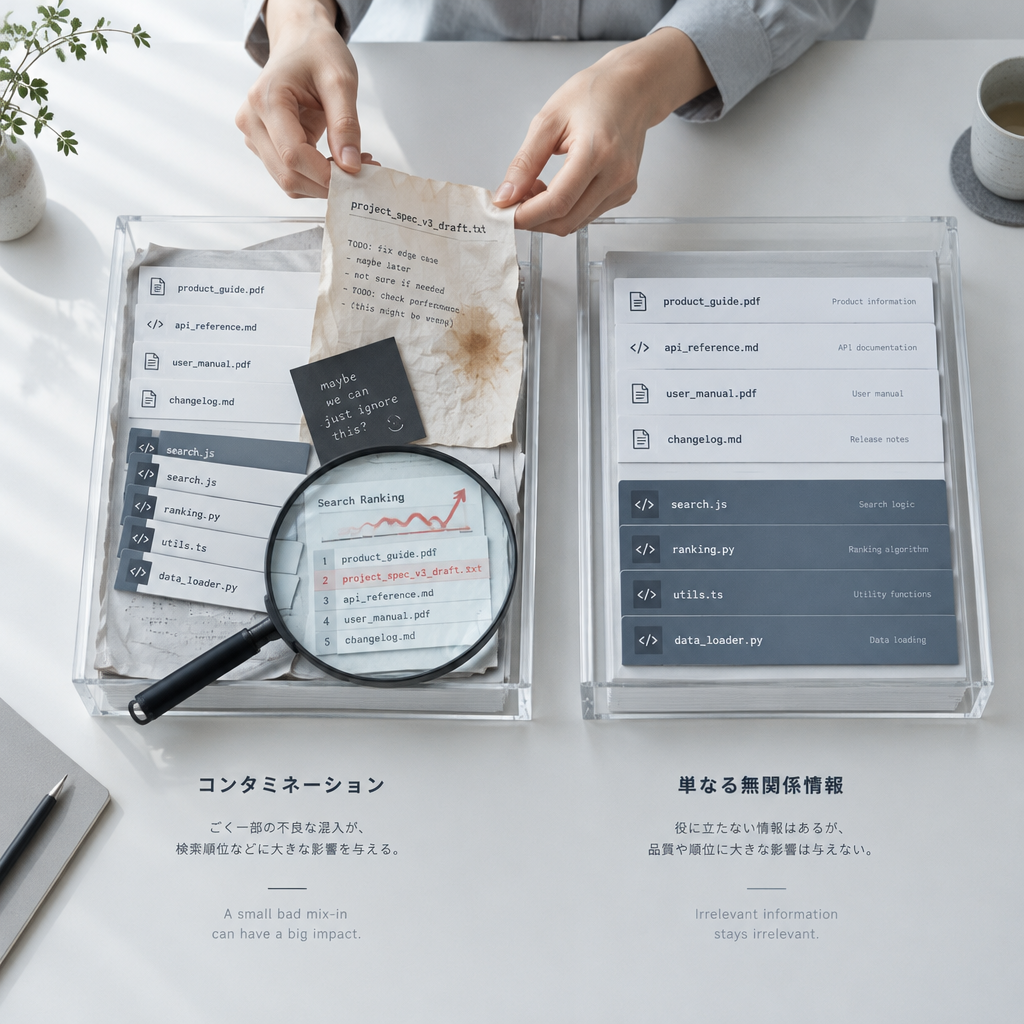
汚染はデータの信頼性を損なう混入である
学習データ汚染は、学習・検索・評価に使うデータへ不正確な内容や攻撃用の情報が混ざり、AIの振る舞いを望ましくない方向へ変える問題です。単純な誤字だけでなく、文脈を壊す情報や古い規程も対象になります。
重要なのは、データ量が多いほど安全になるとは限らない点です。少量でも高い影響力を持つ文書が混入すれば、RAGの検索順位を押し上げ、利用者に誤った回答を繰り返す仕組みになり得ます。
検索結果には同名の教育機関情報も現れますが、これはAIのリスクを示す根拠ではありません。例えば「some 70% of classes having 30 or fewer participants」という授業規模の記述は、学習データ汚染の品質指標とは切り分けて扱うべきです。
- 対象は学習データ、RAG文書、埋め込み、評価用データまで広がる
- 偶発的な混入と、意図的な改ざんの両方を想定する
- 件数だけでなく、参照頻度と業務影響で優先順位を決める
データポイズニングやラベル汚染との違い
結論として、学習データ汚染は広い概念であり、データポイズニング、ラベル汚染、バックドア攻撃はその代表的な類型です。原因別に分けることで、収集停止、再ラベル、再学習など、適切な対処を選びやすくなります。
データポイズニングは、攻撃者がモデル性能を落としたり、特定の判断を誘導したりする目的でデータを投入する行為です。ラベル汚染は、画像や文章に付く正解ラベルが誤っている状態であり、偶発的な作業ミスでも発生します。
バックドア攻撃では、通常時は正常に見えるモデルが、特定の語句や画像パターンを入力したときだけ異常な結果を返します。外部委託データや公開データセットを導入する際は、AIデータ系譜の確認が不可欠です。
- 意図、混入箇所、再現条件の3点でインシデントを分類する
- ラベル誤りはサンプル監査と再判定で是正する
- トリガー疑いは隔離環境で再現テストを行う
検索の混同を判断材料にしない
直接の答えは、関連しない数値や名称をAIリスクの証拠にしてはならない、ということです。検索や社内検索で見つかる情報は、対象、時点、文脈を確認してから根拠として採用する必要があります。
たとえば「In the 2025 academic year, the adoption rate of new research projects for the Grants-in-Aid for Scientific Research at Gakushuin University was 40.0%.」は研究採択率に関する事実であり、データセットの正確性や攻撃率を意味しません。
このような混同を防ぐには、データごとに出典、取得日、利用目的、責任者を記録します。AIデータ品質の確認では、もっともらしい数値であっても、モデルの利用目的との関連性を検証する姿勢が重要です。
- 数値には対象・母数・測定方法・利用目的を添える
- 検索順位や引用回数だけで信頼性を決めない
- 根拠採用の承認記録を残し、後から検証可能にする
混入が起こる工程を把握して入口を絞る
収集とスクレイピングでは出典を固定する
最初に守るべきことは、収集元を無制限に広げず、信頼できる出典と取得条件を固定することです。自動収集では、転載、古いページ、攻撃的な埋め込み指示が意図せず取り込まれる危険があります。
URL、取得日時、ライセンス、ハッシュ値、収集ジョブの設定を保存すると、問題が起きた文書を追跡できます。特に規程や商品情報のように更新頻度が高いデータは、鮮度の期限も属性として扱います。
外部データの受入時には、許可リスト、ファイル形式制限、マルウェア検査、重複検出を組み合わせます。これにより、AIデータガバナンスを抽象的な方針で終わらせず、取り込み時の具体的な統制にできます。
- 信頼済みのドメインと提供者を許可リスト化する
- 原本・変換後ファイル・ハッシュ値を関連付ける
- 取得不能時や仕様変更時の停止基準を決める
アノテーションと前処理では意味の崩れを防ぐ
アノテーション工程では、作業者ごとの判断差がラベル汚染につながります。正解基準、判断できない場合の扱い、エスカレーション先を明文化し、二重判定が必要な高リスク項目を先に定めることが有効です。
前処理では、個人情報の削除、文字コードの正規化、文書分割、重複排除が実施されます。しかし、削除ルールが強すぎれば意味が失われ、分割が粗ければRAGの回答根拠が文脈から外れます。
品質確認は全件目視だけに頼れません。欠損率、重複率、ラベル不一致率、範囲外値を自動検査し、閾値を超えたバッチのみ人が確認する設計なら、AIバイアス対策にも継続性が生まれます。
- ラベル基準に具体例と除外例を付ける
- 前処理前後の件数と属性分布を比較する
- 人の再判定結果を次回ルールへ反映する
RAG投入と追加学習では更新権限を分ける
RAGの文書登録は、モデル自体を再学習しなくても出力を変えられるため、重要な攻撃面です。回答の根拠として参照される文書に不正な指示が含まれると、利用者の質問を通じて望ましくない行動を誘導される可能性があります。
対策は、文書の作成者と公開承認者を分離し、登録前に機密情報、命令文、外部リンク、重複、更新日を検査することです。埋め込み生成後も、原本への参照を保持しておく必要があります。
追加学習用のデータは、RAG文書より復旧コストが高くなります。合成データAIで作ったデータを含め、学習対象、利用範囲、削除要請への対応を台帳化し、安易な再利用を防ぎます。
- 登録・公開・削除の権限を同一人物に集中させない
- 検索結果に原本、版、更新日を表示できるようにする
- 追加学習前に隔離環境で影響を評価する
AIデータ品質を測り、異常を早く見つける
品質は六つの観点で業務要件に結び付ける
AIデータ品質は、正確性、完全性、一貫性、適時性、有効性、一意性の6つの側面で確認するのが基本です。ただし、すべてを同じ重みで採点するのではなく、誤回答の影響が大きい項目を優先します。
例えば、問い合わせ回答用のRAGでは、最新規程であることと根拠文書を特定できることが重要です。一方、需要予測では欠損、外れ値、集計単位の不一致が予測精度を大きく左右するため、検査ルールも変わります。
Data Quality Management Guidebook (Version 1.02), published on 14 May 2026 と、データ品質マネジメントチェックリスト (Version 1.00) 2026年5月14日公表は、品質を継続管理する必要性を示す実務上の参照点になります。
- 重要データ要素を先に定義し、全項目を同じ深さで監視しない
- 品質スコアには利用目的ごとの合格基準を設ける
- 異常の検知だけでなく、修正担当と期限も定義する
自動検査と人のレビューを役割分担する
結論として、機械的に判定できる異常は自動化し、文脈の妥当性は人が確認する分担が現実的です。欠損、重複、形式不正、参照整合性、個人情報らしき文字列は、取り込み時に検査できます。
一方で、差別的な含意、誤解を招く表現、法務上の利用可否、業務上の例外は、ルールだけでは判定しにくい領域です。サンプルレビューと利用部門の承認を組み合わせ、判断理由を記録します。
版管理の基準として、Data Quality Management Guidebook (Version 1.01), published on 2 December 2025 および Data Quality Management Guidebook (Version 1.00), published on 31 March 2025 も確認し、参照する規程の版を混在させないことが大切です。
- 検査失敗時は隔離、通知、再処理までを自動化する
- 人の判断が必要なケースはレビューキューへ振り分ける
- ルール変更時は過去データへの影響範囲も確認する
品質の劣化をモデルの問題と誤認しない
モデル精度の低下が見えたとき、原因は必ずしもモデル本体ではありません。入力データの形式変更、参照文書の更新漏れ、ラベル定義の変更など、データ側の変化が出力悪化を生む場合があります。
この切り分けには、データバージョンごとの品質指標、検索ヒット率、回答根拠の採用率、利用者からの訂正報告を同じ画面で確認できるようにします。異常発生時の比較対象を残すことが要点です。
品質監視の通知が多すぎると、担当者は重要な警告を見落とします。AIデータ品質のSLAは、影響度別に通知先と対応期限を分け、業務停止が必要な条件をあらかじめ合意しておくべきです。
- データ変更、モデル変更、プロンプト変更を別々に記録する
- 品質指標と業務KPIの悪化を時系列で照合する
- 警告は重大度に応じて段階的に通知する
AIデータ系譜で出所と変更履歴を追えるようにする
系譜は問題データを特定する最短経路である
AIデータ系譜とは、データがどこから来て、誰が、いつ、どの処理で変換し、どのモデルや検索基盤で使われたかをたどる記録です。汚染の疑いが出たとき、調査対象を絞るための基盤になります。
原本だけを保存しても、分割、要約、匿名化、埋め込み化を経た後の影響は追えません。原本ID、変換ジョブID、データセット版、ベクトル化モデル、公開先を連結し、影響範囲を逆引きできるようにします。
特にRAGでは、回答ログと参照チャンクを結び付けることが重要です。誤回答が報告されたとき、根拠文書を即座に無効化し、同じ文書が使われた回答を再評価できる状態を目指します。
- 原本、加工物、埋め込み、利用先を一意のIDでつなぐ
- データ更新時には上流・下流への影響を記録する
- 削除や訂正の要求を追跡可能な作業として管理する
ハッシュと承認記録で改ざんを発見する
改ざん検知には、ファイルやデータセットごとのハッシュ値が有効です。受領時の値と利用直前の値が異なれば、意図しない変更や破損を疑い、隔離して原因を確認する運用につなげられます。
ただし、ハッシュだけでは内容の正しさを保証しません。誰が提供したか、どの契約や同意にもとづくか、どの検査を通過したかというプロベナンス情報を添え、信頼の根拠を複数持つ必要があります。
AI開発で扱うデータには、表形式、文書、音声、画像、プロンプト、ツール実行結果が混在します。AIデータ系譜は形式ごとに分断せず、利用目的と責任者を横断して確認できる台帳として設計します。
- ハッシュ不一致を検知したデータは自動で利用停止する
- 承認者、検査結果、利用条件をメタデータに残す
- 外部提供者の変更通知を受け取る連絡経路を確保する
削除と復旧を事前に設計する
汚染が見つかった後に重要なのは、削除対象を特定し、サービス影響を最小限に抑えて復旧することです。データだけでなく、派生したチャンク、埋め込み、キャッシュ、追加学習済みモデルへの影響も確認します。
RAGなら、問題文書を検索対象から除外し、再インデックス後に代表質問で動作を確認します。追加学習では、影響データを除いた再学習または安全な旧版へのロールバックが必要になることがあります。
こうした手順は、AIコンプライアンスの基本:企業が整備すべき規程・審査・監査対応の実務ガイドで扱う記録・承認の考え方とも接続します。復旧判断を担当者の記憶に依存させないことが肝心です。
- 隔離、影響調査、削除、再検証、報告の順に進める
- ロールバック対象の版と復旧時間の目標を決める
- 再発防止策を収集・承認・検査ルールへ反映する
AI評価データセットとAIモデル検証で影響を確かめる
評価データは学習データから独立させる
AI評価データセットは、モデルが本当に未知のデータでも期待どおりに動くかを確かめるため、学習データやチューニング用データから分離する必要があります。同じ内容が重複すると、性能が実態より高く見えてしまいます。
評価セットには、通常の利用例だけでなく、誤字、曖昧な質問、古い情報への問い合わせ、悪意ある指示、少数属性に関する質問を含めます。実サービスの失敗事例を匿名化して追加する方法も有効です。
評価データも汚染されます。答えが誤っていたり、テスト問題が事前にモデルへ流入していたりすれば、検証結果は信用できません。問題文、正解根拠、作成者、更新履歴を管理し、定期的に見直します。
- 学習・調整・評価のデータを論理的にも物理的にも分離する
- 評価問題には想定外入力と境界事例を含める
- 正解ラベルの根拠とレビュー履歴を保存する
検証は精度だけでなく安全性を測る
AIモデル検証では、正答率だけで合格を決めてはいけません。誤答時に根拠のない断定をしないか、機密情報を出さないか、危険な指示を拒否できるかまで、利用目的に沿って確認する必要があります。
汚染を疑う場合は、特定の語句、文書、画像パターンを含む入力群で出力差を調べます。通常の入力では問題がなくても、条件付きで異常な応答が出るなら、バックドアや検索汚染の可能性があります。
検証結果は、モデル版、データ版、プロンプト版、実行環境とセットで保存します。これにより、更新後に性能が変化した際、どの変更が影響したのかを比較でき、説明責任も果たしやすくなります。
- 正確性、安全性、公平性、根拠性を分けて評価する
- 高リスクの失敗は件数ではなく重大度で判定する
- リリース前後で同じ評価セットを用いて差分を確認する
本番監視で評価の盲点を補う
事前評価だけで全ての汚染を見つけることは困難です。本番では、回答の根拠文書、拒否率、訂正率、ユーザー評価、異常な検索語を監視し、新しい失敗パターンを評価セットへ戻す循環を作ります。
とくに出力の安全性は、データ品質だけでは完結しません。AI出力フィルタとは?生成AIの不適切出力・機密情報漏えいを防ぐ設計と運用も併用し、汚染を完全に防げなかった場合の防御層を整えます。
評価セットの更新は、単に問題数を増やす作業ではありません。失敗の原因を、データ、検索、モデル、プロンプト、権限のどこに置くか分析し、AIモデル検証の再現性を高める作業です。
- 本番の失敗報告を評価データへ継続的に反映する
- 根拠文書の偏りや急増を監視する
- 評価結果と障害対応記録を同じ台帳で参照できるようにする
AIデータガバナンスで継続的な防御を運用する
責任分担を明確にして判断を止めない
AIデータガバナンスの要点は、データ所有者、データスチュワード、モデル責任者、セキュリティ担当、利用部門の責務を明確にすることです。問題発生時に承認待ちで対応が止まる状態を避けられます。
データ所有者は利用目的と正確性の責任を持ち、スチュワードは品質ルールとメタデータを運用します。モデル責任者は性能影響を評価し、セキュリティ担当は不正アクセスや改ざん兆候への対応を主導します。
統制の対象はデータセットに限りません。プロンプト、埋め込み、ベクトルDB、APIログ、外部ツール実行も含め、誰が何を変更できるかを定義します。これが学習データ汚染の再発防止につながります。
- 変更承認者と緊急停止権限者を分けて指定する
- 利用目的ごとに許容できる品質リスクを合意する
- 外部委託先やSaaS提供者との責任境界も文書化する
数値を導入効果の根拠にする前に確認する
数値は意思決定に役立ちますが、対象と算出方法を確認しなければ誤った統制につながります。25%、22%、95%、34%、62%、0.01%といった値は、それぞれの調査条件や母数が不明なままでは、汚染率や対策効果として扱えません。
同様に「新規のお客様には、Google Cloud で使用できる無料クレジット $300 分を差し上げます。」という案内は、検証環境を始めるための提供条件です。セキュリティ対策の有効性やデータ品質の水準を示す数値ではありません。
「$300 分の無料クレジットと 20 以上の無料枠プロダクトを活用して、Google Cloud で構築を開始しましょう。」という情報も、実装選択肢の案内として読みます。AIデータガバナンスでは、費用情報とリスク指標を混同しないことが重要です。
- 数値には出典、母数、期間、定義を必ず添える
- 販売条件と品質・安全性の指標を別の台帳で扱う
- 比較指標は同じ測定条件で継続取得する
合成データを使うなら生成過程も監査する
合成データAIは、希少事例の補完や個人情報を含む原データへの依存低減に役立ちます。しかし、生成元の偏りや誤りを増幅する可能性があり、実データの代替として無条件に信頼することはできません。
利用前には、生成元データの利用権限、生成モデル、プロンプト、フィルタ、出力件数、品質評価結果を記録します。実データと合成データの比率だけでなく、属性分布や失敗事例の再現性も比べます。
また、AIバイアス対策として合成データを投入する場合も、属性を単純に均等化するだけでは十分ではありません。公平性の定義を業務文脈で決め、評価データで意図しない性能低下がないかを確認します。
- 合成データには生成元と生成条件を必ず付与する
- 実データと同じ検査ルールを合成データにも適用する
- 高リスク判断では合成データだけで最終検証を行わない
まとめ
学習データ汚染への対策は、一度のクレンジングで終わる作業ではありません。収集、加工、RAG登録、評価、本番監視の各段階で出所と品質を確認し、異常時に止めて戻せる仕組みを持つことが、信頼できるAI運用の土台になります。
要点
- 汚染は偶発的な品質不良と意図的な攻撃の両方から発生する
- AIデータ品質は利用目的に応じた基準と継続監視で維持する
- AIデータ系譜を整備すると、影響範囲の調査と復旧が速くなる
- AI評価データセットを独立管理し、AIモデル検証を本番監視につなげる
- AIデータガバナンスで責任者、承認、停止、復旧の手順を運用する
まずは、現在利用している学習データとRAG文書について、出典、最終更新日、責任者、利用先を棚卸ししてください。重要業務に使うAIから優先して、品質検査、系譜記録、評価手順を整えることが、現実的で効果的な第一歩です。
よくある質問
Q1. 学習データ汚染と単なるデータ品質不良は何が違いますか?
データ品質不良は欠損や重複、更新漏れなどを広く含みます。学習データ汚染は、そのような不良に加え、悪意ある改ざんや特定の出力を誘導する情報の混入まで含む、AI運用上のリスク概念です。
Q2. RAGでも学習データ汚染は起こりますか?
起こります。RAGでは参照文書の登録ミス、古い規程、悪意ある命令文、重複コンテンツが回答へ影響します。文書の出所、承認、更新日、検索ログを管理し、問題文書を速やかに無効化できる設計が必要です。
Q3. AI評価データセットはどのように管理すべきですか?
学習用・調整用データから分離し、問題文、正解根拠、作成者、版、レビュー履歴を記録します。実運用で見つかった失敗事例を追加しつつ、テスト問題が学習側へ流入しないアクセス制御を行います。
Q4. 合成データAIを使えば個人情報や偏りの問題は解決しますか?
完全には解決しません。合成データは原データの偏りや誤りを引き継ぐ可能性があります。生成元、生成条件、利用権限を記録し、実データと同じ品質・公平性・安全性の検査を適用することが必要です。
Q5. 最初に着手すべき学習データ汚染対策は何ですか?
重要なAI利用から、データの出所、最終更新日、責任者、利用先を棚卸しすることです。その後、取り込み前検査、変更承認、評価データの分離、問題発生時の隔離と復旧手順を順番に整備します。
参考文献・出典
[](/) * [ブログ](/blog) * [プレスリリース / ニュース](/news) *…
japan.box.com
[](https://www.insight-tec.com/)…
www.insight-tec.com