2026.11.18
AI資料主權實戰指南:企業安全導入與治理決策
AI資訊
當員工把客戶報價單、維修紀錄或研發文件貼進外部聊天機器人時,企業面對的已不只是效率問題,而是AI資料主權是否仍掌握在自己手上的問題。若資料離開可控範圍、模型供應商改變條款,或 API 突然中斷,再好的 AI 應用也可能成為營運與法遵風險。
AI資料主權指的是組織能決定資料在哪裡保存、誰可使用、能否跨境傳輸、是否可用於訓練,以及在供應商更換時能否完整帶走資料與運作能力。它比傳統資安更廣,還涵蓋模型權重、算力、提示詞、向量資料庫與代理工具的控制權,因此需要以業務風險而非單一技術選型來規畫。
本文將先釐清資料主權與主權 AI 的差異,再說明AI資料治理、AI資料去識別化、企業AI權限管理與部署架構如何相互配合;最後提供從 AI PoC、AI合規審計到正式營運的實作路線。內容特別以製造、零售與專業服務業常見的知識庫聊天機器人、需求預測與文件自動化情境為例。
AI資料主權的定義:先分清資料、模型與算力控制權
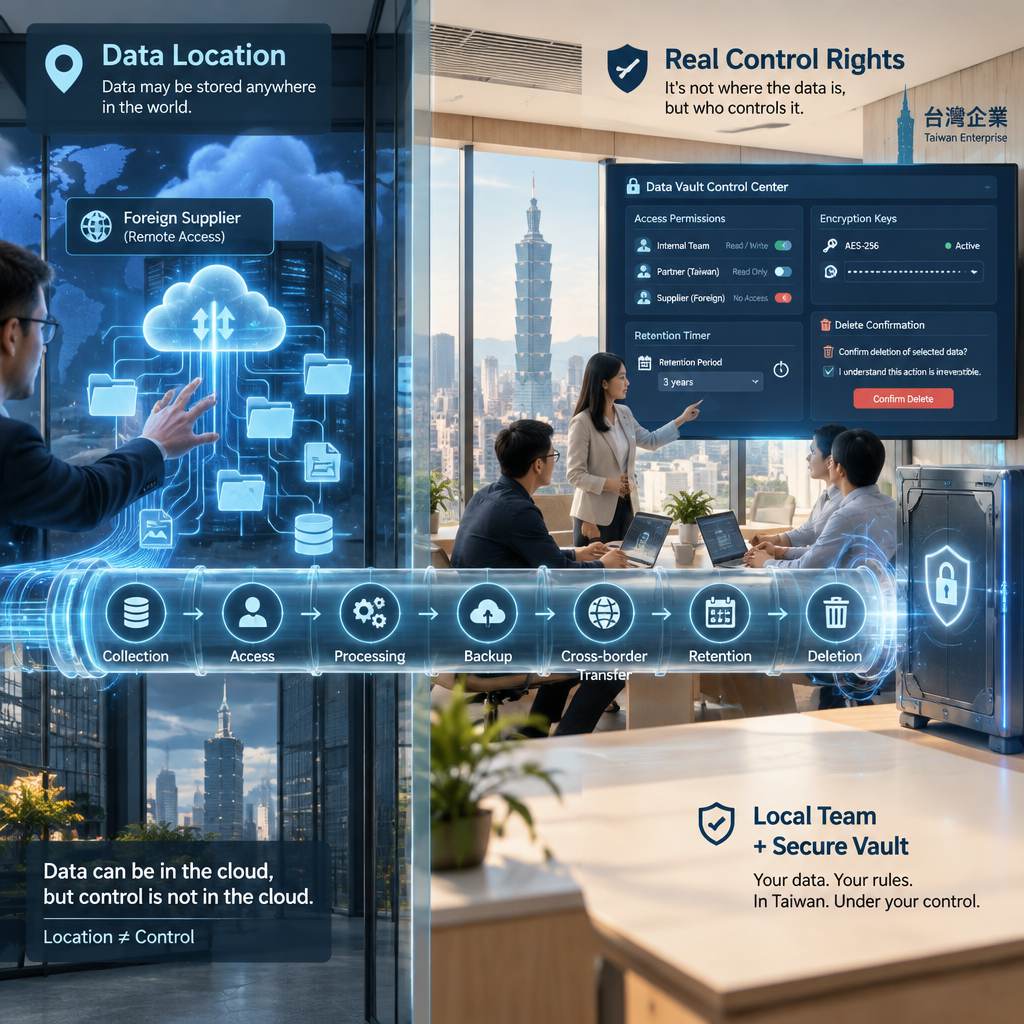
資料主權不是把資料放在國內而已
AI資料主權的核心,是企業對資料生命週期保有可證明的決定權。資料所在地只是第一層,還要確認蒐集目的、存取角色、處理者、備份位置、跨境路徑、保存期限與刪除機制。若企業雖使用國內機房,卻讓境外供應商可遠端調閱、將輸入內容留作訓練,或無法匯出原始紀錄,實質控制權依然不足。
以製造業維修知識庫為例,設備序號、客戶廠區、故障照片與工程師判斷,單獨看似未必敏感,串接後卻可能揭露產能、供應鏈與客戶關係。企業應把資料主權寫成可驗證條件:資料在哪個區域處理、誰能解密、供應商能否二次利用、合約終止後多久刪除,以及如何取得刪除證明。
資料在地化是降低風險的手段,並非唯一答案。跨國集團可能因協作、備援或模型服務而必須跨境處理;此時更重要的是建立資料分類、傳輸審核、加密、最小權限與可攜性條款。主權的判斷重點不是「有沒有上雲」,而是發生例外時,企業能否知道、能否停止、能否取回。
- 確認資料處理、備份與日誌的實際地點
- 將供應商二次利用與模型訓練設定寫入契約
- 為高敏感資料保留匯出、刪除與移轉能力
資料主權、模型主權與主權 AI 的差異
資料主權管的是資料控制,模型主權管的是模型的可控與可替換,主權 AI 則是國家或組織整體能力的組合。企業即使能控制資料,若核心流程完全依賴單一封閉模型 API,仍可能因價格、服務條款、輸出行為或出口限制改變而受制於人;反過來,擁有模型也不代表訓練資料已具備合法使用權。
模型主權至少應盤點四項:是否掌握模型版本與設定、是否能保存或移轉權重、是否能替換推論端點,以及提示詞、檢索規則與評測資料是否可攜。對多數企業而言,目標不是從零訓練大型模型,而是在可接受成本下,建立可替換模型的應用層與完整的資料血緣。
國家層級的主權 AI 還涵蓋晶片、資料中心、能源、人才與本土語料。公開資料中曾列出1.28%與2%(4個)等指標,提醒決策者不要只看單一模型排行,而要追問指標定義、母體、測試條件與可重現性。企業採購時同樣應以情境評測取代行銷數字。
- 資料可控不等於模型可替換
- 模型版本、提示詞與向量索引都屬重要資產
- 評測百分比必須附帶母體與測試條件
以風險分級決定主權強度
企業不必讓所有 AI 工作負載採取完全隔離,應依資料與業務衝擊採取分級主權。公開行銷文案、已公開產品說明等低風險任務,可在核准的外部服務中使用;包含客戶合約、未公開價格、個資或製程參數的任務,則應提高資料遮蔽、權限與部署控制。這比全面禁止更容易取得現場配合。
建議將服務區分為公開、內部、機敏與高度機敏四級。高度機敏情境如病歷、配方、併購文件與關鍵基礎設施紀錄,應優先採取隔離網段、私有推論、禁止供應商留存、人工覆核與嚴格匯出管制;同時定義何種資料絕對不可進入聊天介面。
外部政策與供應鏈情勢也會影響風險判斷。例如公開資訊曾標示2026-05-27為特定主權 AI 相關資訊的日期;企業應把這類日期視為查核觸發點,而非永久有效的保證。每次模型、地區、資料處理條款或子處理者異動,都應重新評估風險分級。
- 以資料敏感度、業務衝擊與可替代性分級
- 高風險工作負載採取隔離、留存禁止與人工覆核
- 把供應商條款異動納入定期風險複查
AI資料治理如何讓資料主權成為日常管理能力
建立資料目錄、血緣與品質責任
AI資料治理應從回答「這份資料從哪來、可否使用、被誰使用」開始。建立資料目錄時,不只登錄資料表名稱,還要記錄資料擁有者、敏感等級、蒐集依據、保存期限、可用模型與禁止用途。對 RAG 知識庫,還應納入文件來源、切分規則、嵌入模型、索引版本與檢索權限,否則答錯時無法追溯原因。
資料品質通常可從六個維度判斷:準確性、完整性、一致性、及時性、有效性和唯一性。這套檢查不能只在資料倉儲進行,也要延伸到掃描檔、PDF、工單文字與影像標註。若同一客戶在 ERP、CRM 與售後系統有不同名稱,聊天機器人即使語言能力優秀,也可能給出錯誤的業務建議。
治理責任應由高層贊助、資料擁有者、資料管理員、資安、法務與模型團隊共同承擔。讓業務部門擁有資料定義與用途決定權,技術團隊負責落實控制與監測,才能避免資料目錄成為一次性文件。資料品質 KPI、資料血緣覆蓋率與異常修復時間,應列入例行營運報告。
- 為每項資料指定擁有者、用途與保存期限
- 將文件切分、嵌入與索引版本納入血緣
- 以品質與可追溯指標檢視治理成效
從部門規則走向企業AI治理
企業AI治理是在資料治理之上,管理模型、提示詞、代理行為與人員決策責任的制度。資料治理確保輸入可信且可合法使用;模型治理處理版本、偏誤、漂移與效能;資訊安全治理處理身分、端點與事件。三者必須在同一個變更流程匯合,否則新增一個外部工具就可能繞過既有內控。
在 2024 年對 350 個資料長和資料長同級角色進行的調查中,45% 的資料長將資料治理視為首要考量。此結果反映企業已意識到,AI 成敗不只取決於模型準確率。對傳統產業而言,真正影響使用意願的往往是資料是否最新、答案能否附來源、錯誤時由誰修正,以及主管是否可理解模型限制。
企業可先建立 AI 使用政策與審核看板:申請人說明目的、資料等級、模型、預期輸出與風險;資料擁有者核准用途;資安確認連線與留存;法務確認契約;模型負責人設定評測與監控。這種企業AI治理流程不必冗長,但必須讓每次例外都有紀錄、到期日與重新審查機制。
- 讓資料、模型、資安與法務共用變更流程
- 要求每個 AI 用例說明資料等級與核准目的
- 以答案來源、錯誤率與漂移做持續監控
跨部門共享要兼顧效益與邊界
共享資料的正確做法不是把所有資料集中開放,而是依目的提供最小必要資料集。政府部門掌握80% 以上的数据资源,這說明資料集中不必然等於資料可用;企業內部同樣常見採購、製造與客服各自持有資料,卻無法在適當權限下供應分析或客服 AI 使用。
在政务系统中60%的数据需跨部门调用,但实际共享率不足30%。另有觀察指出,80%的部门仅开放基础目录数据,关键领域 (如医疗、交通) 数据开放率不足15%。這些數字雖屬公共治理脈絡,卻也提醒企業:若只開放欄位名稱或靜態檔案,卻沒有申請流程、標準定義與可用介面,AI 專案仍會卡在資料取得。
實務上可建立資料產品概念,例如「核准供應商清單」、「已去識別化維修案例」或「可查詢的產品規格知識庫」。每個資料產品應有服務等級、更新頻率、允許用途與品質門檻。若需使用雲端工具,可先利用運用價值 $300 美元的免費抵免額和 20 多項一律免費的產品進行非敏感資料測試,再決定正式架構。
- 以用途導向的資料產品取代全面開放
- 為共享資料定義更新頻率、品質門檻與申請流程
- 先以非敏感資料驗證工具與整合可行性
防止LLM資料外洩:去識別化與權限管理要一起做
先理解 LLM 資料外洩的常見路徑
LLM資料外洩通常不是單一駭客事件,而是輸入、檢索、輸出與外掛工具串接後的控制缺口。員工直接貼上機密內容、聊天紀錄被保留、RAG 權限未同步、提示詞注入誘導模型讀取不該看的文件,以及代理工具可直接執行下載或寄信,都是常見途徑。企業應從資料進入模型前就開始設防。
企業知識庫聊天機器人最容易被忽略的問題,是「使用者可問什麼」與「使用者可檢索什麼」被當成同一件事。正確設計應先以員工身分、部門、專案與資料標籤過濾可檢索文件,再交由模型生成答案;不能只依賴提示詞要求模型不要洩漏資訊,因為提示詞不是存取控制。
預防措施包括核准模型清單、瀏覽器或端點 DLP、輸入內容分類、祕密資訊掃描、引用來源顯示、下載限制與異常查詢告警。尤其是工程、採購與客服部門,應演練「員工誤貼合約」及「模型被提示詞注入」兩種情境,確認通報、停用與證據保全能否在當日完成。
- 以檢索權限而非提示詞保護文件
- 在輸入、輸出與工具呼叫三處設置控制
- 定期演練誤傳資料與提示詞注入事件
AI資料去識別化不是單純遮住姓名
AI資料去識別化的目標,是在保留分析效用的前提下,降低識別特定個人的可能性。它不同於不可逆匿名化,也不同於僅將姓名換成代碼的假名化。姓名、電話、地址、帳號、設備編號、稀有職稱與時間地點組合,都可能經由外部資料重新識別,因此必須依資料用途與攻擊情境選擇方法。
文件型資料可透過規則、命名實體辨識與人工覆核遮蔽;結構化資料則可採泛化、抑制、K-匿名、差分隱私或合成資料。繁體中文姓名、地址、表格欄位與中英混雜內容,容易讓通用偵測器漏判,尤其 PDF 視覺遮擋後仍可複製文字、Excel 隱藏工作表仍存在內容,都是驗收時必查的陷阱。
市場資訊曾提到 AI 相關市場由前一年度的146.9億美元成長至2020年全球AI相關市場規模估計為225.9億美元,成長了53.8%。成長不代表可以降低隱私門檻;企業應量測敏感欄位覆蓋率、漏偵測率、誤遮蔽率與重識別測試結果,並由資料擁有者確認資料仍足以支援原本分析目的。
- 區分匿名化、假名化與可逆遮蔽
- 檢查 PDF、試算表與跨檔案關聯的漏點
- 同時驗證隱私保護效果與資料分析效用
企業AI權限管理必須落到資料列與工具層級
企業AI權限管理應採最小權限、動態授權與完整稽核,而不是只替聊天機器人設一組共用帳號。身分應串接既有 SSO 與多因素驗證,角色則依職務、部門、專案與資料敏感度決定。離職、調職、專案結束或供應商合約到期時,系統也必須能自動撤銷相應權限。
針對 RAG 與代理系統,權限至少要覆蓋原始文件、向量索引、提示詞範本、工具呼叫、對話紀錄與管理介面。若客服人員只能讀取自己服務品牌的案件,模型檢索層就必須套用同一條件;若代理可呼叫 ERP 查庫存,也應限制可查欄位、筆數、頻率與是否能執行寫入操作。
權限異常可透過短時間大量查詢、跨部門檢索、深夜下載、反覆測試敏感提示詞等訊號偵測。市場內容中出現47.1K subscribers與Posted: 2026-10-14等頁面指標時,企業不應把觀看數或發布日期當成安全可信度;應優先檢查程式碼、資料處理方式、維護者與授權條款。
- 讓 SSO 身分與文件、索引、工具權限一致
- 限制代理工具的欄位、筆數與寫入權限
- 以異常查詢與權限變更日誌支援調查
私有化AI雲與本地端AI部署:用架構換取可控性
何時選私有化AI雲,何時選本地端AI部署
私有化AI雲適合需要彈性算力與隔離租戶的企業,本地端AI部署則適合極高敏感度、低延遲或網路受限場景。兩者都不是自動安全:私有雲仍須確認控制平面、金鑰、備份與支援人員權限;本地端仍要面對 GPU 維運、修補、容量與備援。選型應先由資料分類與服務水準決定。
對大多數企業而言,混合架構通常較務實:機敏文件的索引、金鑰與身分驗證留在受控環境,模型推論則依工作負載選擇本地、私有雲或核准外部 API;公開資料的文案與翻譯工作可使用成本較低的託管服務。這種設計能同時兼顧主權要求、效能與導入速度。
部署評估不能只比每 token 價格。總持有成本還包括電力、GPU 折舊、網路、儲存、模型更新、資安修補、監控、備援、資料標註與人才。若服務量不足,本地硬體可能長期閒置;若尖峰負載高,完全自建又可能無法滿足回應時間,因此要用實際流量與 SLA 估算。
| 項目 | 核准外部 API | 私有化AI雲 | 本地端AI部署 |
|---|---|---|---|
| 資料控制 | 依契約與設定 | 隔離租戶與自管金鑰 | 最高,可自管環境 |
| 擴充彈性 | 高 | 高 | 受硬體容量限制 |
| 維運負擔 | 低 | 中 | 高 |
| 適用資料 | 公開與低敏感 | 內部與機敏 | 高度機敏與離線場景 |
- 以資料敏感度、延遲、流量與維運能力選型
- 混合架構可將敏感資料與彈性算力分層處理
- 用完整總持有成本而非單一 API 價格比較
把退出策略納入架構設計
真正的主權架構必須能在供應商、模型或地區服務改變時安全退出。企業應避免把商業邏輯、提示詞、評測資料與向量索引鎖死在單一平台專屬格式;並且預先測試模型切換、資料匯出、索引重建與 API 轉接。沒有演練過的可攜性,只是採購文件上的承諾。
退出條款應包括資料匯出格式、完成期限、刪除證明、備份保留規則、子處理者清單、金鑰控制與支援終止後的存取方式。若供應商提供模型微調或託管向量資料庫,更要釐清訓練成果、嵌入向量與中繼資料能否取得,因為這些往往是企業累積數月的關鍵資產。
技術上可將應用層拆成模型閘道、檢索層、權限層與觀測層。模型閘道統一處理供應商路由、內容過濾、成本與速率限制;應用程式只呼叫內部介面。如此即使更換模型,也能保留使用者體驗、稽核紀錄與資料政策,降低遷移時的營運衝擊。
- 要求資料、索引與評測集可匯出
- 以模型閘道隔離供應商專屬 API
- 定期演練模型切換與資料刪除證明取得
算力自主也需要容量與能源規畫
算力主權的重點不是擁有最多 GPU,而是在關鍵業務需要時取得可預期、可審計的推論能力。企業應先區分即時客服、夜間批次摘要、文件嵌入與模型微調等負載,量測併發量、延遲、token 使用量與尖離峰差異,再決定保留容量、租用容量與備援容量的比例。
本地端AI部署若沒有觀測機制,容易發生 GPU 使用率低、記憶體瓶頸或排隊時間過長,導致使用者回到未受控的公開工具。建議在 LLMOps 中追蹤推論延遲、錯誤率、成本、模型版本、檢索命中率與輸出品質;這些資料也能支持後續採購與擴充決策。
能源、冷卻與網路備援同樣是算力規畫的一部分。對中小型團隊而言,較合理的做法通常不是急著購置硬體,而是在受控環境以真實資料完成 PoC,取得需求量與品質證據後再擴充。這也能避免因模型規格快速演進,使一次性設備投資過早失去彈性。
- 先量測負載,再決定自建與租用比例
- 在 LLMOps 中監控延遲、成本與檢索品質
- 將能源、冷卻與備援納入算力風險評估
從AI PoC到AI合規審計:建立可正式營運的路線圖
AI PoC是什麼:先驗證風險、效益與使用情境
AI PoC 是以最小可行範圍驗證技術、資料與業務效益的概念驗證,不是縮小版的正式系統。對企業知識庫聊天機器人而言,PoC 應先選擇一個可衡量的部門情境,例如維修手冊問答或採購規格比對,並明確排除高敏感資料與不必要的系統串接。這能讓團隊快速確認回答品質與主權控制是否可行。
成功指標不宜只有「模型看起來很聰明」。至少要設定檢索正確率、答案有來源比例、人工改寫率、平均處理時間、使用者採納率、敏感資料攔截率與單次任務成本。若目標是需求預測,則應比較既有人工流程與多個模型在實際銷售、庫存資料上的誤差,並試算缺貨與庫存過剩的改善空間。
PoC 的價值也包括做出 No-Go 判斷。若資料品質不足、使用者流程不適合、去識別化後效用大幅下降,或主權控制成本超過預期,就應暫緩正式化並提出補強條件。從現場調查、目標設定、原型實證到投資判斷的流程,可避免需求模糊時就投入龐大開發預算。
- 以單一明確業務情境開始驗證
- 同時衡量品質、效率、風險與成本
- 將 No-Go 視為降低投資損失的重要成果
AI合規審計要保存哪些證據
AI合規審計的目的,是讓企業能證明自己知道資料怎麼來、模型怎麼用、風險如何被控制。稽核證據應涵蓋資料清冊與分類、使用目的、授權或同意依據、去識別化紀錄、模型與提示詞版本、權限清單、供應商條款、評測結果、人工覆核紀錄、異常事件與改善追蹤。只有政策文件而沒有系統日誌,通常不足以支持調查。
模型生命週期可分為以下幾個階段: (1)規劃與數據獲取;(2)模型開發;(3)部署與集成;以及(4)使用與維護。每個階段都要設定關卡:規劃期確認目的與資料合法性,開發期確認評測與安全測試,部署期確認權限與監控,營運期則追蹤模型漂移、資料漂移、投訴與事件處理。
稽核不應在專案結束才補做。可將關鍵控制嵌入 CI/CD 與 LLMOps,例如禁止未標示資料等級的文件進入索引、模型版本變更必須重新測試、權限變更自動留下日誌、每月抽樣檢查敏感輸出。這樣能把合規從人工填表,轉為可重複執行的營運能力。
- 保存資料、模型、權限與事件的可追溯證據
- 在模型生命週期各階段設定審核關卡
- 將控制自動化嵌入部署與營運流程
正式上線前的能力補強與參考來源
從 PoC 走向正式營運前,企業至少要補齊專案管理、資料治理、資安、法務與維運五種能力。專案經理負責範圍與 KPI,資料擁有者確認內容與用途,資安團隊管理身分與事件,法務審視契約與著作權,技術團隊負責 LLMOps、模型漂移與版本回復。可先在企業AI沙盒中隔離驗證模型、流程與資料控制。
參考來源應以可查核的官方框架與原始規範為主,例如 NIST AI Risk Management Framework:https://www.nist.gov/itl/ai-risk-management-framework;歐盟 GDPR 官方入口:https://commission.europa.eu/law/law-topic/data-protection/data-protection-eu_en;以及台灣個人資料保護法全國法規資料庫:https://law.moj.gov.tw/LawClass/LawAll.aspx?pcode=I0050021。
另外可參考 NIST Privacy Framework:https://www.nist.gov/privacy-framework,以及 OWASP Top 10 for LLM Applications:https://genai.owasp.org/llm-top-10/。正式上線後,應每季檢視資料用途、供應商異動、權限例外、模型表現與事件紀錄;當新的資料來源或代理工具加入時,重新啟動小範圍驗證,而不是直接接入正式環境。
- 以跨職能責任矩陣支撐正式營運
- 優先引用官方規範與可查核框架
- 新資料來源與工具上線前先在隔離環境驗證
總結
AI資料主權不是「不上雲」或「買一台伺服器」就能完成,而是企業對資料、模型、算力、權限與退出策略持續保有控制與證據。從資料分類、AI資料去識別化、企業AI權限管理,到私有化AI雲、本地端AI部署與AI合規審計,每一項控制都應服務於具體業務風險與可衡量的效益。
重點整理
- 先區分資料主權、模型主權與算力自主,避免只看部署地點。
- 以資料目錄、血緣、品質與最小權限建立AI資料治理基礎。
- 將 LLM資料外洩防護設計在輸入、檢索、輸出與工具呼叫全流程。
- 用小範圍 AI PoC 驗證品質、風險、成本與使用者採納,再決定是否正式化。
- 保留模型、索引、提示詞與稽核紀錄的可攜性,才能降低供應商鎖定風險。
若企業正準備導入知識庫聊天機器人、文件自動化或需求預測,建議先選定一個資料邊界清楚的場景,完成資料盤點、風險分級與成功指標設定。接著在隔離環境中驗證模型品質、權限控制與去識別化效果,再以可查核的結果向管理層提出正式投資與治理方案。
常見問題 FAQ
Q1. AI資料主權和資料在地化有什麼差別?
資料在地化聚焦資料儲存或處理的位置;AI資料主權還包括誰能存取、是否可用於訓練、能否跨境、是否可匯出與刪除,以及模型與供應商異動時的控制能力。
Q2. 企業一定要採用本地端AI部署嗎?
不一定。應依資料敏感度、延遲需求、流量、維運能力與法遵要求評估。許多企業適合採混合架構,把高敏感資料與權限控制留在受控環境,並對低風險任務使用核准的外部服務。
Q3. AI資料去識別化後就可以直接丟進外部 LLM 嗎?
不一定。去識別化仍可能有重新識別、商業機密暴露、著作權與供應商留存風險。應再確認資料用途、模型條款、跨境處理、權限、輸出控制與重新識別測試結果。
Q4. 企業AI治理最先該做哪一件事?
先完成 AI 用例與資料盤點,為每個用例標註資料敏感等級、資料擁有者、使用模型、供應商、預期效益與禁止用途。這份清冊是後續權限、去識別化、部署與稽核的共同基礎。
Q5. AI PoC 成功後可以直接正式上線嗎?
不建議直接上線。PoC 成功只證明特定範圍內可能可行;正式營運前仍須補上身分與權限整合、監控告警、事件應變、模型版本管理、供應商退出條款、備援與AI合規審計證據。