2026.11.18
AI脅威モデリングで設計段階から守る実践手順
IT関連
AI脅威モデリングは、生成AIやエージェントを含むシステムで起こり得る攻撃を、設計段階から洗い出して対策する手法です。実装後の脆弱性対応だけでは、AI特有の予測しにくい挙動を十分に防げません。
LLMは入力された指示、参照データ、外部ツール、会話履歴の影響を受けて出力します。そのため、従来のWebアプリケーションと同じ認証・認可を備えていても、間接プロンプトインジェクションや機密情報の流出が起こり得ます。
本記事では、対象システムの分類からデータフロー図の作成、脅威の優先順位付け、緩和策、運用監視までを順に解説します。開発者、プロダクト責任者、セキュリティ担当者が同じ判断基準を持つための実践ガイドです。
AI脅威モデリングで明らかにする対象と目的
従来の脅威モデリングとの違い
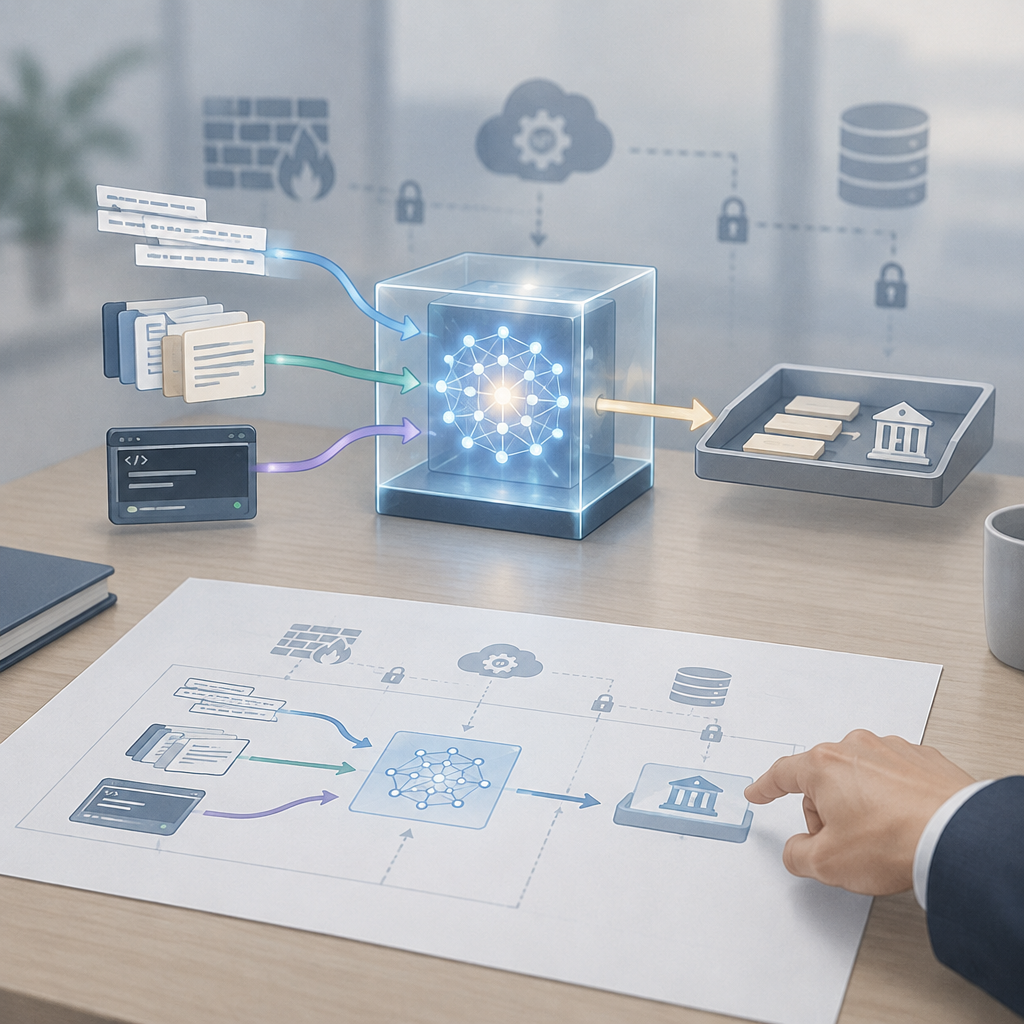
結論として、AIを含む設計ではモデルへの入力と出力そのものを攻撃面として扱います。従来の脅威モデリングが認証、API、データベース、ネットワーク境界を中心に扱うのに対し、AIでは自然言語の命令が処理の流れを変える点が大きな違いです。
LLMは同じ意図の入力でも表現、会話履歴、検索結果、モデル更新によって異なる出力を返すことがあります。この非決定性により、仕様どおりに見えるプロンプトだけを確認しても、安全性を十分に保証できません。
設計レビューでは「誰が何を操作できるか」に加え、「モデルが何を信頼するか」「出力がどの業務処理へ渡るか」を確認します。人間の入力、取得文書、ツール応答を同じく検証対象に置くことが出発点です。
- 自然言語の指示を信頼境界として扱う
- モデル出力が後続処理へ与える影響を確認する
- 更新後も同じ安全性が保たれるか検証する
優先して対象にすべきAIシステム
まず、システムを用途と権限で分類すると、レビューの深さを決めやすくなります。代表例は、内部にAI機能を有するアプリケーション、外部のLLMを用いたアプリケーション、エージェント型AIを用いたアプリケーションの3種類です。
社内文書を検索するRAG型チャットでは、検索対象の権限継承と回答への引用が重要です。一方、外部モデルへ送信する構成では、送信データ、保存条件、プロバイダーとの責任分界を明確にする必要があります。
特に優先度が高いのは、個人情報や営業秘密を扱うもの、顧客に直接回答するもの、メール送信や決済などのツールを実行できるものです。影響の大きい意思決定には、人間による最終承認を設計上組み込みます。
- 機密データの入力・検索・出力経路
- 外部LLMとクラウドサービスへの送信範囲
- エージェントに与えた実行権限
ゴールを先に合意する理由
脅威モデリングの目的は、脅威を無制限に列挙することではありません。守るべき資産、許容できない業務影響、残余リスクの受容者を先に決め、対策の優先順位を合意することが成果につながります。
開始時には、対象リリース、対象環境、利用者、連携先、想定する攻撃者を一枚にまとめます。外部の不特定利用者、権限を持つ社内利用者、侵害された連携サービスでは、攻撃経路も必要な統制も異なります。
成果物には脅威一覧だけでなく、担当者、期限、受容理由、再確認条件を残します。対策しない判断も根拠と承認者を記録すれば、変更時に見直すべき前提を追跡できます。
- 保護対象と業務上の許容損失
- 対象範囲と対象外の明示
- 残余リスクの承認者と見直し日
構成図から攻撃経路を可視化する方法
データフロー図に描くべき要素
最初に作るべきものは、AI機能を含むデータフロー図(DFD)です。利用者、フロントエンド、オーケストレーター、モデル、ベクトルデータベース、外部API、監査ログを矢印で結び、データがどこを通るか示します。
矢印には、プロンプト、添付ファイル、検索クエリ、検索結果、ツール呼び出し、モデル出力などの種類を書きます。データの分類も付記すると、個人情報や機密情報が意図せず外部サービスへ流れる経路を確認できます。
構成図は一度作って終わりではありません。モデルの差し替え、プラグイン追加、検索対象の拡張、権限変更があれば更新します。図と実装の差分は、見落とされた攻撃面を示す重要なシグナルです。
- 処理主体と保管場所を分けて記載する
- 入力・出力・検索結果の矢印に名称を付ける
- 変更管理と図の更新を同じ作業にする
信頼境界を越える瞬間を洗い出す
脅威は、信頼度の異なる主体の間でデータや命令が移動する場所に集中します。利用者からAIへの入力、AIから外部ツールへの実行要求、検索基盤からモデルへの文書注入は、代表的な信頼境界です。
STRIDEでは、信頼境界を越えるすべてのデータ・フローについて、なりすまし、改ざん、否認、情報開示、サービス拒否、権限昇格の6種類の脅威を検討することを勧めています。AI構成でもこの観点は有効です。
ただし、取得文書の中に悪意ある命令が埋め込まれる場合、正規のデータフローでも攻撃が成立します。送信元の認証だけで安心せず、文書内容を命令として扱わない分離設計と、後続操作の検証が必要です。
- 利用者と社内システムの境界
- モデルと外部ツールの境界
- 検索文書とプロンプトの境界
エージェントと外部ツールの経路を深掘りする
ツールアクセスを持つエージェントでは、モデルの出力がAPI引数や実行命令になるため、被害範囲が広がります。読み取り専用の検索と、送信・更新・削除を行う操作は、同じツール群として扱わずに分離します。
各ツールについて、呼び出し条件、実行できる操作、対象リソース、認可の再確認、失敗時の停止条件を確認します。モデルが提案した操作をそのまま実行する構成は、過剰な委任を生みやすい設計です。
マルチエージェント構成では、他エージェントからのメッセージも信頼できない入力として扱います。役割ごとの権限を狭くし、実行役と承認役を分けることで、誤った推論が連鎖するリスクを抑えます。
- ツールごとの操作権限と対象範囲
- 高リスク操作前の利用者確認
- エージェント間メッセージの検証
脅威を漏れなく特定し優先順位を付ける
フレームワークを組み合わせて使う
結論として、単一のフレームワークに依存せず、設計の基本にはSTRIDE、AI固有の攻撃観点にはSTRIDE+AIやMAESTROを重ねる方法が実務的です。STRIDE、STRIDE+AI、MAESTROの3つの脅威モデリング手法は、見る角度が異なります。
STRIDEは構成要素とデータフローの脅威を体系的に確認する基盤になります。MITRE ATLASはAIへの攻撃技法を参照するカタログとして、OWASPはLLMアプリケーションで頻出するリスクを確認する補助線として活用できます。
フレームワークは答えを自動で出すチェックリストではありません。対象の業務、扱う情報、実行権限に合わせ、脅威ステートメントと攻撃ステップを具体化して初めて、チームが実装できる対策になります。
| 手法 | 主な対象 | 強み | 使いどころ |
|---|---|---|---|
| STRIDE | データフロー | 基本脅威の網羅 | 設計レビュー |
| STRIDE+AI | AIの入出力 | AI固有リスク | 生成AI機能 |
| MAESTRO | AIエコシステム | 多層の防御観点 | 複雑なAI構成 |
- STRIDEでデータフローの基本脅威を確認する
- AI向けカタログで命令注入やモデル悪用を補う
- 自社の業務影響に翻訳してチケット化する
攻撃シナリオを脅威ステートメントにする
有効な脅威記述は、「誰が、どの経路で、何を行い、どの資産にどんな影響を与えるか」を一文で表します。例えば、攻撃者が共有文書内の命令を経由して、エージェントに非公開データの検索を促す、と具体化します。
次に、攻撃が成立する前提、必要な権限、検知できるログ、攻撃成功後の影響を並べます。ここまで分解すると、入力フィルタ、権限確認、出力検証、監査ログのどこに統制を置くべきか判断できます。
脅威一覧には、誤用だけでなく誤作動も入れます。モデルの幻覚による誤案内、検索漏れによる不完全な判断、画像や音声の入力誤認識は、攻撃者がいなくても利用者や業務へ影響を与え得ます。
- 攻撃者の能力と初期アクセス
- 攻撃の各ステップと通過点
- 成功時の情報・金銭・業務への影響
残余リスクまで定量的に判断する
優先順位は、発生可能性と影響度だけで決めるべきではありません。攻撃コスト、検出可能性、復旧難易度、対策導入後の残余リスクを評価し、限られた開発工数を被害の大きい経路へ配分します。
たとえば、外部文書からの命令注入は発生しやすくても、ツール権限が読み取り専用であれば影響を抑えられます。反対に、低頻度でも送金やデータ削除に至る経路は、強い承認と停止機構を優先すべきです。
ある 1 つのコントロールが脅威への緩和策の 90% に現れる場合、その統制は共通基盤として実装する価値があります。ただし万能策と誤解せず、例外ケース、運用負荷、利用体験への影響も記録します。
- 発生可能性と業務影響を分けて採点する
- 対策後の残余リスクを再評価する
- 受容判断には期限と責任者を設定する
生成AIの攻撃を防ぐ緩和策を設計する
入力と検索結果を命令から分離する
最も重要なのは、利用者入力や検索文書を信頼できる指示として扱わないことです。システム指示、利用者の質問、外部コンテンツを論理的に分け、外部コンテンツが権限変更や秘密の開示を命令できないようにします。
既知のパラメータを受け取る処理では、M-002: 既知のパラメータのサニタイズ(入力のフィルタリング)が有効です。SQLや検索条件をモデルが自由生成する構成では、許可済みの構造へ変換する層を置きます。
データベース照会では、M-001: SQL クエリ構造の事前定義を用い、任意のクエリ実行を避けます。さらに、M-003: テンプレート化されたプロンプトパラメータとの照合により、想定外の入力形式を早期に拒否します。
- 信頼済み指示と外部コンテンツを分離する
- 自由形式の入力を許可済み形式へ制限する
- 検索対象にアクセス権を反映する
出力を実行前に検証する
モデルの出力は、正しそうに見えても未検証のデータです。画面表示、API呼び出し、メール作成、コード生成など用途ごとに検証器を置き、許可されない形式、宛先、操作を後段で止める必要があります。
M-004: 出力がユーザーに関連していることの確認(出力のフィルタリング)は、他者の情報を含む回答を返さないための基本策です。検索結果の引用元、利用者の所属、閲覧権限を照合してから表示します。
モデルが連続した会話で不要な情報を保持しないよう、M-005: LLM のコンテキストウィンドウの制限も検討します。必要な文脈を短く保つことは、漏えい範囲と命令注入の影響範囲の双方を小さくします。
- 出力形式をスキーマで検証する
- 利用者権限と回答内容を照合する
- 高リスク出力は人間が承認する
最小権限と動的認可を徹底する
エージェントの安全性は、プロンプト防御だけで成立しません。M-007: アプリケーションのすべてのコンポーネントへの最小権限の適用により、侵害されたコンポーネントが到達できる資産を最小化します。
送信、削除、公開、支払いのような高リスク操作には、M-006: モデルによって実行される高リスクアクションに対する動的な権限チェック(認証パラメータをプロンプトから分離する)を適用します。認可情報を会話文に置かないことが重要です。
認証にはOAuth、SAML、OIDC、Kerberos、パスワード・ベースの認証などがありますが、認証済みであることと操作を許可することは別です。各実行時に利用者、対象、操作、状況を評価する設計にします。
- モデルに恒久的な特権を渡さない
- 高リスク操作には再認可を求める
- 認証情報をプロンプトと分離する
継続的な検証と運用で安全性を保つ
テストをリリース前の工程に組み込む
安全性の確認は、本番障害後の調査ではなく、要件定義からテストまでの工程に組み込みます。SEC01-BP07 脅威モデルを使用して脅威を特定し、緩和策の優先順位を付けるという考え方は、設計上の欠陥を早期に見つける基準になります。
テストでは、直接的な脱獄指示だけでなく、文書に埋め込んだ間接指示、権限の異なる利用者、異常に長い入力、禁止操作への誘導を用意します。期待する拒否、確認、ログ出力が一貫して起こるか確認します。
モデルの評価には、正答率だけでなく、誤検知、見逃し、根拠のない回答、危険なツール選択を含めます。テストケースと判定基準を版管理すると、モデル更新後の差分を再現可能な形で比較できます。
- 脅威ごとに失敗させるテストを作る
- 拒否・承認・監査ログを同時に確認する
- モデル変更時は回帰テストを必須にする
監査証跡と対応手順を整える
本番では、入力全文を無制限に保存するのではなく、個人情報に配慮しながら、誰がどのツールをいつ実行したか追跡できる監査証跡を残します。会話ID、権限判定、ツール引数、結果、承認者は調査で重要になります。
アラートは、短時間の大量試行、通常と異なるツール呼び出し、拒否された操作の反復、権限外データへのアクセス要求などに設定します。検知後に担当者が迷わないよう、停止、証拠保全、利用者通知の手順を定義します。
脅威モデルの変更履歴をチケットと結び付けると、なぜ統制を追加したかを説明できます。[2026-04-07 12:23] のようにレビュー時点を記録し、構成変更・モデル変更・事故後に再承認する運用が有効です。
- 操作主体と実行結果を関連付けて記録する
- 異常な権限利用を検知する
- 停止と復旧の責任分担を明文化する
自動化の結果を人間がレビューする
脅威モデル生成ツールは、構成図やソースコードから候補を素早く出す補助になります。しかし、存在しないデータフローや、業務上あり得ない攻撃を含むこともあるため、承認権限を自動化へ委ねるべきではありません。
2026年3月現在、デフォルトではClaude Sonnet 4`global.anthropic.claude-sonnet-4-20250514-v1:0`が使われるようです。生成結果はモデル名、入力範囲、実行時刻とともに保存し、人間が構成図との一致を確認します。
公開資料を再利用する際は、Creative Commons Attribution-ShareAlike 4.0 International License または Creative Commons Attribution-Share Alike v4.0 の条件を確認します。自動化の出力も、根拠、修正履歴、承認者を残して初めて監査可能な成果物になります。
- 自動生成した経路を実装と照合する
- 誤検知と見逃しをレビュー記録に残す
- 利用条件と出典表示の要否を確認する
まとめ
AI脅威モデリングは、AIの能力を制限するためではなく、利用者と事業を守りながら価値ある自動化を実現するための設計活動です。構成、信頼境界、攻撃経路、権限、運用証跡を一連の流れとして扱うことが重要です。
要点
- DFDと信頼境界から、AI固有の攻撃経路を可視化する。
- 入力・出力・ツール実行をそれぞれ未検証として扱う。
- 最小権限、動的認可、人間の承認で高リスク操作を守る。
- モデルや構成の更新ごとに、脅威と対策を再検証する。
- 自動化の提案は人間がレビューし、判断根拠を残す。
まずは現在のAI機能を1つ選び、利用者からモデル、検索データ、外部ツールまでのデータフローを書き出してください。設計・開発・運用の担当者が同じ図を見ながらレビューすることで、実装前に修正できるリスクを見つけやすくなります。
よくある質問
Q1. AI脅威モデリングはいつ実施すべきですか?
要件定義とアーキテクチャ設計の段階で開始し、モデル、データソース、ツール、権限の変更時に更新します。リリース直前だけでなく、開発工程に継続的に組み込むことが重要です。
Q2. RAG型チャットボットでも脅威モデリングは必要ですか?
必要です。検索対象文書に含まれる悪意ある命令、権限を超えた文書の検索、回答への機密情報混入、外部LLMへのデータ送信などを確認する必要があります。
Q3. エージェント型AIで最優先の対策は何ですか?
最小権限と高リスク操作時の動的認可です。モデル出力をそのまま実行せず、対象・操作・利用者権限を後段で検証し、必要に応じて人間の承認を求めます。
Q4. 自動生成ツールだけで脅威モデリングを完了できますか?
できません。自動化は候補の抽出や文書化を速くしますが、実際のデータフロー、業務影響、残余リスクの受容判断は、設計と業務を理解する担当者がレビューして承認する必要があります。
Q5. 脅威の優先順位はどのように決めますか?
発生可能性、影響度、攻撃コスト、検出可能性、復旧難易度を評価します。そのうえで対策後の残余リスクと導入コストを比較し、受容するリスクには責任者と再評価条件を設定します。
参考文献・出典
このブラウザーはサポートされなくなりました。 Microsoft Edge にアップグレードすると、最新の機能、セキュリティ更新プログラム、およびテクニカル サポートを利用できます。 Note このページにアクセスするには、承認が必要です。 [サインイン](#)またはディレクトリの変更を試すことができます。…
learn.microsoft.com
[Skip to Main Content](#aws-page-content-main) AWS ブログ * [ホーム](/jp/blogs/news/) ## [Amazon Web Services ブログ](/jp/blogs/news/) # 生成 AI…
aws.amazon.com
# [サーバーワークス エンジニアブログ](/) …
blog.serverworks.co.jp