2026.11.17
AIモデル軽量化で推論コストを抑える実践設計
IT関連
AIモデル軽量化は、生成AIを実サービスで継続利用するための重要な設計です。高性能なモデルを導入しても、応答が遅い、GPU費用が膨らむ、端末で動かないという課題が残れば、事業価値は十分に発揮されません。
とくにLLMは、モデル本体だけでなくKVキャッシュや同時接続数によって必要メモリが増えます。AIモデル圧縮を単なる容量削減と捉えず、精度、レイテンシ、AI電力消費、保守性を一体で設計することが重要です。
本記事では、量子化・枝刈り・モデル蒸留の使い分けから、AI推論最適化、AI推論基盤の選び方までを解説します。GPUコスト削減とLLMコスト最適化につながる評価手順、オンプレLLM運用の注意点も具体的に確認します。
AIモデル軽量化で最初に決めるべきこと
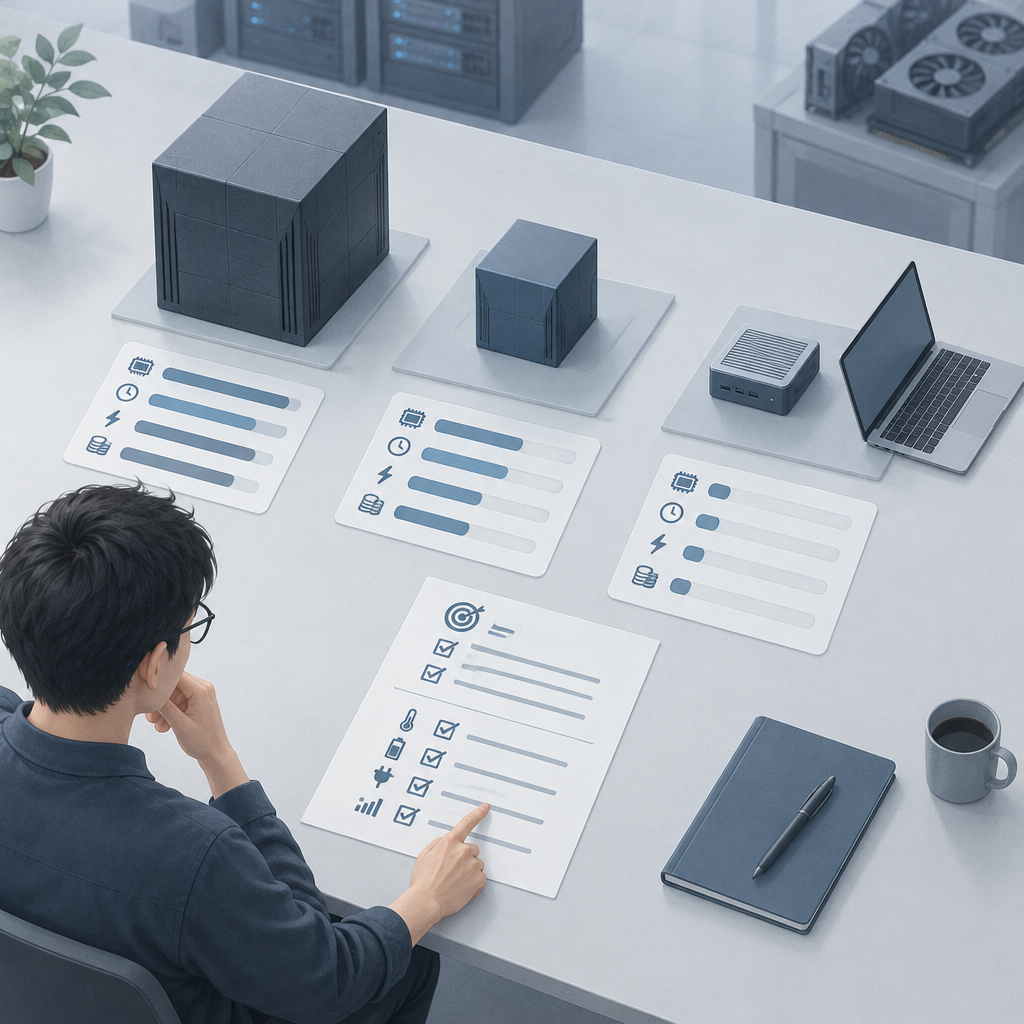
軽量化は容量削減だけを目的にしない
AIモデル軽量化の目的は、モデルファイルを小さくすることだけではありません。必要な精度を保ちながら、メモリ使用量、応答時間、電力、運用単価を下げることが本質です。まず利用場面と品質基準を明文化しましょう。
たとえば70億〜80億パラメータ級のモデルは、16ビット(FP16)のままではおおよそ14〜16GBを必要とします。一方、4ビット(INT4級)に量子化すれば、おおよそ4〜5GBまで下げられるため、配置できる実行環境の選択肢が広がります。
ただし、容量が減っても実効レイテンシが短くなるとは限りません。ストレージ読み込み、トークン生成、ネットワーク待機を分けて測り、ユーザーが体感する待ち時間で導入効果を判断する必要があります。
- 対象タスクごとに許容できる品質低下を決める
- ピークRAMとモデル読込時間を別々に測定する
- 端末、CPU、GPU、NPUごとに再検証する
精度と運用条件を要件に変換する
軽量化の成否は、先に削減したい制約を特定できるかで決まります。メモリ不足なら量子化、推論単価が課題なら小型モデルへの移行、通信できない現場ならオンデバイス実行を優先する、といった整理が有効です。
LLMコスト最適化では、入力長と出力長、同時実行数、キャッシュ利用率を分けて把握します。同じモデルでも長文要約と短い分類では負荷構造が異なるため、平均値だけでGPUコスト削減の施策を決めると失敗します。
AI電力消費も見落とせない指標です。消費電力はモデルサイズだけでなく、演算器の稼働時間やデータ転送にも左右されます。処理ごとの電力とスループットを記録し、処理件数当たりで比較すると実態をつかめます。
- 品質指標は正答率だけでなく安全性も含める
- 負荷試験は実際の入出力長で行う
- 削減目標は月額費用と処理件数で定義する
オンデバイスとオンプレミスを使い分ける
オンプレLLMは、機密情報を外部へ送信しにくく、ネットワーク遅延を抑えられる選択肢です。ただし、モデル更新、脆弱性対策、容量計画を自社で担うため、軽量化と運用設計を切り離すことはできません。
端末側で実行する場合は、モデル容量に加えてアプリ本体、OS、同時に動く機能のメモリも考慮します。数キロバイトのRAMで1MB未満のモデルを動かすTinyMLと、業務文書を扱うLLMでは、求められる圧縮戦略が大きく異なります。
AIモデル軽量化の初期段階では、クラウド、エッジ、オンプレLLMのどこで推論するかを決めます。データ境界、可用性、更新頻度を整理してからモデルを選ぶことで、後からの再設計を減らせます。
- 機密性が高い処理は配置場所を先に検討する
- 端末では起動時間と発熱も測定する
- 更新方式とロールバック手順を準備する
AIモデル圧縮の代表手法を使い分ける
量子化は最短でメモリを減らす手法
量子化は、重みや活性値を少ないビット幅で表すAIモデル圧縮の基本手法です。32ビット(FP32)から16ビット(FP16 や BF16)、8ビット(INT8)、4ビット(INT4)へ下げるほど、メモリ使用量は原理的に小さくなります。
FP32を基準にすると、FP16は約50%、INT8は約25%、INT4は約13%の記憶量が目安です。ただし、実ファイルにはメタデータや量子化パラメータも含まれるため、削減率は実測で確認しなければなりません。
まず試すなら、既存学習済みモデルに適用するPTQ(学習後量子化)が現実的です。品質劣化が許容範囲を超えた場合に、学習時から量子化誤差を考慮するQAT(量子化考慮学習)を検討します。
- PTQは短期間で比較検証しやすい
- QATは精度維持を狙えるが再学習が必要
- 低ビット化ほど外れ値への対策が重要になる
枝刈りは演算構造まで見直す手法
枝刈り、すなわちプルーニングは、影響の小さい重みやチャネルを減らす手法です。AIモデル圧縮で計算量も抑えたい場合に有効ですが、削った部分を実行環境が効率よく処理できるかまで確認する必要があります。
非構造化枝刈りは細かな重みをゼロにできる一方、汎用GPUではゼロを飛ばす専用カーネルがなければ高速化しません。対して構造化枝刈りは、チャネルやヘッドを単位に減らすため、実装後の速度改善につながりやすい特徴があります。
枝刈り後は再学習を行い、元のモデルと同じ評価セットで比較します。元のネットワークの10%〜20%のサイズを目指す場合でも、境界事例や少数クラスの性能が崩れていないかを個別に確認することが重要です。
- 削減対象は重み、チャネル、ヘッドで異なる
- 実行カーネルの対応状況を確認する
- 枝刈り前後で誤答の種類を比較する
低ランク分解を含めて比較する
低ランク分解は、大きな行列をより小さな行列の組み合わせに置き換える手法です。Transformerの線形層などで有効になり得ますが、圧縮率だけで採用せず、変換後の演算が対象ハードウェアで速いかを測定します。
手法選びでは、単一のベンチマーク結果を鵜呑みにしないことが大切です。同じデータセット、同じ入力長、同じハードウェアで、品質、ピークRAM、消費電力、スループット、起動時間を比較してください。
複数手法を組み合わせるなら、量子化前後の差分を追える順番で進めます。通常は小型アーキテクチャの選定、蒸留または枝刈り、再学習、最後に量子化という順にすると、品質低下の原因を切り分けやすくなります。
| 観点 | 量子化 | 構造化枝刈り | 低ランク分解 |
|---|---|---|---|
| 主な効果 | メモリ削減 | 演算削減 | 層の圧縮 |
| 再学習 | PTQは不要 | 原則必要 | 原則必要 |
| 導入速度 | 速い | 中程度 | 中程度 |
| 注意点 | 精度低下 | カーネル対応 | 実効速度 |
- 圧縮率ではなく実効速度を判定軸にする
- 各工程で評価モデルを固定する
- 品質劣化のロールバック基準を決める
モデル蒸留で小型モデルに知識を移す
蒸留は教師の出力分布を学ばせる方法
モデル蒸留は、高性能な教師モデルの振る舞いを小さな生徒モデルに学習させる方法です。正解ラベルだけでは伝わりにくいクラス間の近さを、教師の確率分布やロジットから取り込める点に価値があります。
一般的には、正解ラベルへのクロスエントロピーと、教師・生徒の出力分布を近づける蒸留損失を組み合わせます。温度パラメータを上げると分布は滑らかになり、教師が持つ相対的な判断情報を学びやすくなります。
モデル蒸留は、単に教師を模倣させる作業ではありません。教師が誤った回答や偏りを持つ場合、生徒へも引き継がれます。教師の出力を検査し、根拠のない回答や機密情報を含むデータを除外する工程が必要です。
- 教師のロジットと正解ラベルを併用する
- 温度と損失重みを検証対象にする
- 教師の誤答を学習データから除く
蒸留データの品質が性能を左右する
モデル蒸留の性能は、教師モデルの大きさよりも蒸留データの設計に強く左右されます。実利用で頻出する質問、難しい質問、失敗しやすい表現を集め、重複を除去したうえで学習・検証・監視用に分離します。
ファインチューニング用データには、正解だけでなく不明な場合の回答方針も含めます。たとえば社内規程検索では、根拠が見つからないときに推測で断定しない応答を教師・生徒の双方に学ばせることが重要です。
公開事例では、BERTを約40%のサイズに圧縮したDistilBERTが、元の97%以上の言語理解能力を保持しつつ推論速度を60%高速化することに成功しました。この種の数値も、対象タスクと評価条件を確認して自社要件へ置き換えましょう。
- 実問い合わせを匿名化して学習候補にする
- 難例と拒否応答を評価セットへ含める
- 未知データで過学習を確認する
蒸留後も安全性と再現性を検証する
蒸留後の合格判定は、平均スコアだけで決めてはいけません。通常質問、長文入力、曖昧表現、禁止回答、業務上の重要ケースに分け、教師モデルと生徒モデルの差を記録することで、実運用のリスクを評価できます。
特に生成モデルでは、語彙や言い回しが似ていても事実性が落ちることがあります。人手レビューを含む代表ケースを固定し、モデル更新のたびに同じ条件で比較する回帰評価を運用に組み込みましょう。
モデル蒸留とファインチューニングを組み合わせる場合は、先に用途に合わせた教師を準備し、その出力を使って生徒を学習させます。対象業務から遠い汎用データを大量に増やすより、少量でも品質管理されたデータが有効です。
- 安全性評価は品質評価から分離する
- モデル変更時は同一セットで再評価する
- 蒸留データの利用権限を記録する
AI推論最適化でGPU利用を効率化する
推論速度はモデル以外にも左右される
AI推論最適化では、モデルを軽くするだけでは不十分です。トークナイズ、バッチ化、KVキャッシュ、モデル読込、ネットワーク通信を分解し、どこが待ち時間を作っているかを計測してから対策を選びます。
LLMでは、入力トークンの処理と出力トークンの生成で負荷特性が異なります。長い文書を毎回送る構成なら、量子化だけでなく検索結果の圧縮、プロンプトの整理、キャッシュ再利用がLLMコスト最適化に直結します。
推論サーバーは、待ち行列が伸びた場面のp95やp99レイテンシも確認してください。平均応答時間だけが速くても、混雑時に業務が止まるなら品質要件を満たしているとはいえません。
- 前処理と生成処理を別々に計測する
- 平均値と高パーセンタイルを併用する
- 入力長別に負荷試験を行う
GPUコスト削減は利用率の可視化から始める
GPUコスト削減の第一歩は、GPUを増やす前に稼働状況を可視化することです。アイドル時間、メモリ予約、バッチサイズ、同時実行数を確認すれば、過剰な専有や不適切なモデル配置を見つけられます。
量子化済みモデルがメモリに収まれば、同一GPUでより多くの要求を処理できる可能性があります。ただし、低ビット演算が速いかはGPU世代と推論エンジンに依存するため、理論値でなく実スループットで判断します。
AIコスト管理では、GPU時間だけでなく、モデル保管、ログ保管、ネットワーク転送、人手レビューも集計します。部署別や機能別に利用量を配賦できるようにすると、費用対効果の議論が具体的になります。
- GPU利用率とメモリ利用率を分けて見る
- コストを機能単位で追跡する
- スケール条件を需要予測と連動させる
電力まで含めて運用効率を判定する
AI電力消費を抑えるには、処理量当たりの電力量を見ることが有効です。短時間に高い電力を使っても、処理完了が早ければ総エネルギーを下げられる場合があるため、ワット数だけでモデルを比較してはいけません。
推論バッチを大きくするとGPU効率は上がりやすい一方で、個々の要求は待たされます。対話アプリでは遅延上限を決め、非同期の文書処理ではスループット優先にするなど、用途別のキュー設計が必要です。
AI推論最適化は一度きりのチューニングではありません。利用者数、文書量、モデル更新で負荷は変わるため、性能と費用を継続観測し、しきい値を超えたら再評価する運用へ落とし込みます。
- 電力は処理件数当たりで比較する
- 対話処理と一括処理のキューを分ける
- 負荷変動を前提に監視項目を決める
AI推論基盤を継続運用できる形に整える
実行形式は基盤との相性で選ぶ
AI推論基盤では、モデル形式と実行エンジンの互換性が性能を左右します。LLMのローカル実行ではGGUFとllama.cpp、開発時の対話検証ではOllamaやLM Studio、GPU推論ではTensorRTなど、目的に応じた選択が必要です。
画像やセンサー向けではTensorFlow LiteやOpenVINOが選択肢になります。重要なのはツール名ではなく、対象CPU・GPU・NPUで必要な演算子が使え、量子化後のモデルを安定して配布・更新できることです。
オンプレLLMを含む構成では、推論エンジンの更新が回答品質や速度を変える場合があります。本番モデル、量子化設定、ランタイム、ドライバーの組み合わせを記録し、再現可能なデプロイ手順を整備しましょう。
- 実行形式はハードウェア互換性で選ぶ
- モデルとランタイムの版を固定する
- 検証環境と本番環境の差を記録する
品質監視と費用監視を同時に行う
AIコスト管理を機能させるには、費用だけでなく品質低下の兆候も監視します。軽量化後に再問い合わせ率や有人対応率が上がれば、GPU利用料が下がっても全体最適とはいえません。
運用指標は、要求数、入出力トークン、レイテンシ、エラー率、評価スコア、GPU時間を同じ画面で確認できる状態が理想です。モデル別・業務別に分解すれば、費用増加の原因を素早く特定できます。
ALION株式会社のように専属チームで伴走する開発体制を活用する場合も、要件定義、試験、運用監視の責任範囲を明確にします。軽量化は技術検証だけで終わらせず、事業側が判断できる指標へ翻訳することが大切です。
- 費用低下と業務品質を併せて評価する
- 異常時の切り戻し条件を定義する
- 利用部門と運用部門で指標を共有する
段階導入で失敗コストを抑える
AIモデル軽量化は、全社展開前に小さな実証から始めるのが安全です。代表的な業務を選び、元モデルと軽量モデルを並行稼働させて、精度、レイテンシ、AI電力消費、運用工数を同じ条件で比較します。
次に、品質が下がりやすい入力を抽出して改善します。量子化設定を戻す、モデル蒸留のデータを追加する、ファインチューニングを見直すなど、原因に応じた対処を行い、変更履歴を残してください。
最終的には、AIモデル圧縮、AI推論最適化、AI推論基盤を一つの運用サイクルとして管理します。GPUコスト削減だけを追うのではなく、利用者に届く応答品質と継続可能な費用の両立を目指しましょう。
- 本番前に並行評価を実施する
- 変更ごとに品質と費用を再測定する
- 事業要件の変化に合わせて設計を更新する
まとめ
AIモデル軽量化は、量子化、枝刈り、モデル蒸留を単独で選ぶ作業ではありません。用途別の品質要件、実行環境、AI電力消費、運用費用を測定し、AI推論最適化とAI推論基盤の設計まで一貫して進めることで成果につながります。
要点
- 最初に精度、レイテンシ、メモリ、費用の優先順位を決める
- 量子化は導入しやすいが、実ハードウェアで性能を測る
- モデル蒸留は教師出力とデータ品質の管理が重要
- GPUコスト削減は利用率、入力長、同時実行数の把握から始める
- オンプレLLMは軽量化と更新・監視の運用設計をセットで考える
まずは代表的な1業務を選び、元モデルと軽量モデルの品質・ピークRAM・レイテンシ・処理件数当たりの費用を比較してください。測定結果を基に、無理のない段階導入計画を作ることが、継続的なAIコスト管理への近道です。
よくある質問
Q1. AIモデル軽量化で最初に試すべき手法は何ですか?
再学習が難しい場合は、まずPTQによる量子化を評価するのが現実的です。品質劣化が大きいときはQAT、モデル構造の見直し、蒸留を順に検討します。
Q2. 量子化すれば必ず推論速度は上がりますか?
必ずしも上がりません。低ビット演算を効率よく処理できるGPU、CPU、NPUや推論エンジンが必要です。メモリ削減と実効レイテンシを別々に測定してください。
Q3. モデル蒸留とファインチューニングの違いは何ですか?
ファインチューニングは特定用途のデータでモデルを調整する学習です。モデル蒸留は、教師モデルの出力や中間表現を利用して小型の生徒モデルへ知識を移す手法です。
Q4. オンプレLLMに軽量化は必要ですか?
必要になる場面が多いといえます。限られたGPUメモリに収め、同時利用数を増やし、消費電力と運用コストを抑えるために、量子化や小型モデルの活用が有効です。
Q5. AIモデル軽量化の評価で必ず見る指標は何ですか?
タスク品質、ピークRAM、モデル読込時間、平均および高パーセンタイルのレイテンシ、スループット、処理件数当たりの費用、電力を同一条件で確認することが重要です。
参考文献・出典
同意してLinkedInに登録 登録またはサインインするために [続行]…
jp.linkedin.com
# モデル圧縮【model compression】 ## 概要 …
e-words.jp
 #…
note.com