2026.11.15
RAG権限設計で安全な社内検索を実現する方法
IT関連
RAG権限設計は、生成AIに社内文書を参照させる際の情報漏えいを防ぐ中核です。検索精度だけを優先すると、本人が本来見られない人事情報、契約書、顧客データまで回答に混入する危険があります。
RAGは「準備 → 検索 → 生成 → 提示 → 改善」の流れで知識を回答へ変換します。しかし、既存の文書管理にある権限を検索結果へ正しく引き継がなければ、便利な社内検索が新たな漏えい経路になります。
本記事では、認可モデルの選び方、ベクトルDBへの権限付与、精度と安全性を両立する検索設計、引用表示、監査と失効処理までを解説します。PoCで終わらせず、本番運用へ進むための実践的な判断軸を押さえましょう。
RAG権限設計は検索前の認可から始める
なぜ検索段階で権限を確認すべきか
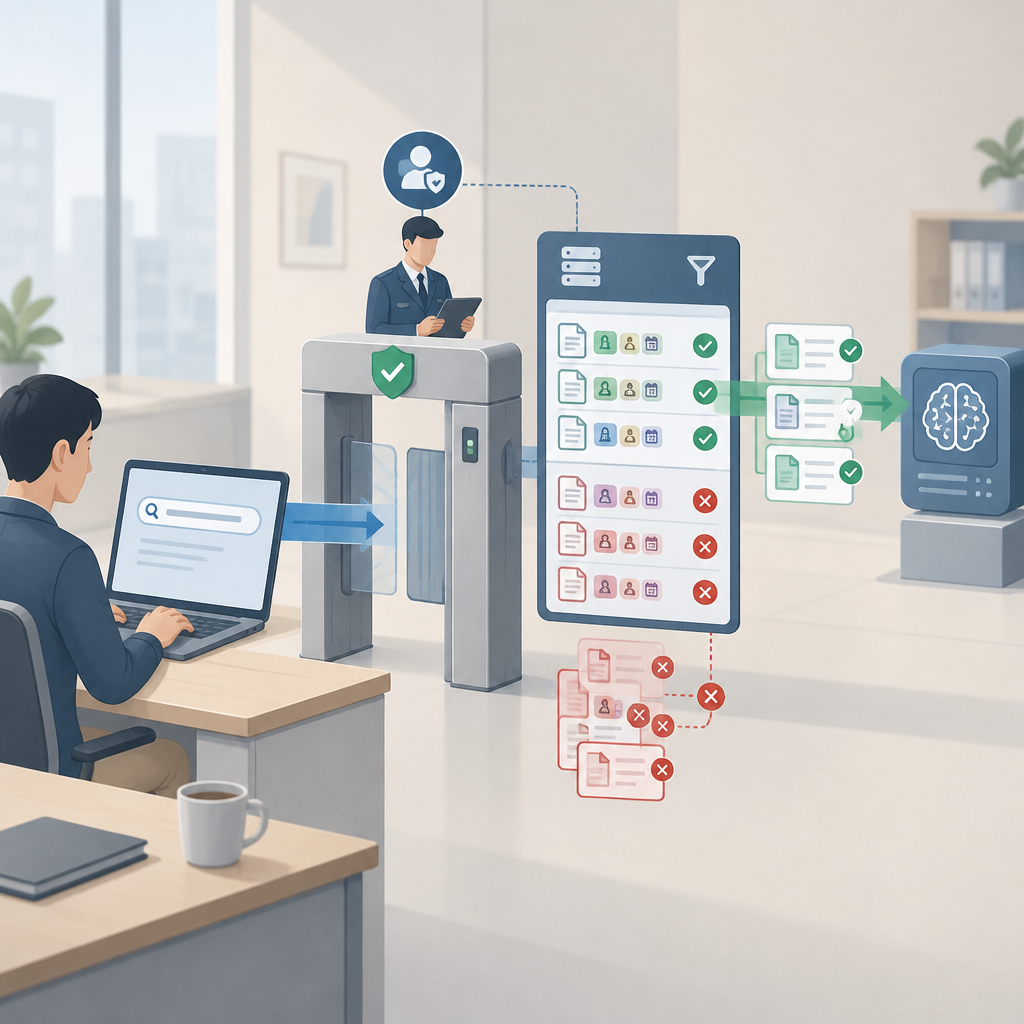
結論として、認可はLLMへの入力を作る検索前に完了させるべきです。生成後に文面を隠す方式では、未承認の断片がコンテキストへ入り、要約や推論を通じて機密情報が残るためです。
たとえば人事部だけが閲覧できる評価資料を、全社員向けの検索対象に登録したままでは危険です。質問者の所属・役割・テナントを検索条件へ渡し、許可済みチャンクだけを候補にする必要があります。
OWASP Top 10 for LLMsでは、機微情報の開示がLLM-02: Sensitive Information Disclosureとして扱われます。RAGの回答画面だけでなく、検索API、キャッシュ、運用者用ログまでを保護対象として設計します。
- 認証済みIDからテナントとロールを確定する
- 検索クエリに認可条件を必ず結合する
- 許可が不明な場合はデフォルト拒否にする
RAGパイプラインに権限情報を流す
RAG構築では、文書本文と同時に権限メタデータを取り込むことが要点です。各チャンクに文書ID、所有部署、テナントID、公開範囲、更新日時、失効日時を持たせると、検索時の判定を一貫させられます。
認証基盤で発行したJWTから、ユーザーID、ロール、所属、地域などのクレームを取得します。その情報をサーバー側で検証し、クライアントから任意のtenant_idを指定させないルーティングにします。
実装は、問い合わせごとに「誰が、どの目的で、どのデータへアクセスしたか」を記録します。回答本文だけでなく、検索候補、採用コンテキスト、拒否理由を関連付けると、監査時の再現性が高まります。
- 文書とチャンクの両方に権限属性を持たせる
- JWTの署名検証は検索サービス側で実施する
- 質問・検索・回答を同一の監査IDで追跡する
最小権限とゼロトラストを設計原則にする
安全な設計の答えは、利用者・サービス・AIエージェントを最初から信用しないゼロトラストです。ネットワーク内にいること、社内アカウントであることだけを、知識ベースへの閲覧許可にしてはいけません。
最小権限では、営業担当者に全顧客の契約書を与えるのではなく、担当顧客と必要な業務期間に絞ります。管理者アカウントも、通常の検索と権限変更を分離し、承認経路を設けることが重要です。
PoCで使う共有インデックスを本番へ流用すると、検証用データや過去の特権設定が残りがちです。本番移行前に、拒否テスト、退職者テスト、クロステナント検索テストを必須の受入条件にします。
- 不明な権限は許可ではなく拒否する
- 管理操作と一般検索の権限を分ける
- 本番移行前に越境検索の否定テストを行う
認可モデルを業務関係に合わせて選ぶ
RBACは部署・職務が安定した組織に向く
部署や職種で閲覧範囲が決まるなら、RAGアクセス制御の出発点はRBACです。ユーザーへロールを付与し、文書またはコレクションに閲覧ロールを設定するため、監査担当者にも説明しやすい利点があります。
ただし、RBACだけでは「特定顧客案件の参加者」「代理対応者」「期限付きの閲覧者」を表現しにくくなります。ロール数を増やし続けると管理負荷が上がり、誤付与の発見も難しくなります。
RBACを使う場合でも、文書の機密区分やテナントIDを補助条件にします。全社閲覧ロールがある利用者でも、他社テナントの文書は返さないという境界を、検索フィルタで強制します。
- 部署単位のポリシーを標準化しやすい
- 例外権限をロールの乱増で処理しない
- テナント境界はロールとは別に強制する
ABACとReBACで例外を明示的に扱う
属性や関係が複雑な場合は、ABACとReBACを組み合わせるのが有効です。ABACは地域、雇用形態、文書分類、閲覧期限などの属性で判定し、ReBACは参加・所有・承認といった関係で判定します。
たとえば「案件Aのメンバーで、国内担当であり、契約が有効な期間だけ閲覧可」は属性と関係の両方が必要です。上司・部下、代理アクセス、共同編集者といった組織関係も、権限グラフで明示できます。
Google Zanzibar系の考え方を採るOpenFGA、SpiceDB、Okta FGAなどは、関係を一元的に評価する選択肢です。ベクトルDBへ複雑な判定を埋め込むのではなく、認可サービスで許可集合を決める構成が保守しやすくなります。
| 観点 | RBAC | ABAC | ReBAC |
|---|---|---|---|
| 主な判定軸 | 職務・部署 | 属性・条件 | 利用者と対象の関係 |
| 得意な場面 | 定型組織 | 地域・期限制御 | 案件・代理アクセス |
| 注意点 | ロール肥大化 | 属性品質 | 関係データの整備 |
- ABACは属性ベースの条件判定に適する
- ReBACは案件参加や代理関係を表現しやすい
- 認可ロジックをアプリごとに複製しない
認可を出力とツール実行まで継続する
RAGアクセス制御は、検索前の一度きりの判定では不十分です。検索結果、コンテキスト構築、LLM出力、RAG引用表示、要約、外部ツール実行まで、同じ利用者コンテキストを継続して適用します。
たとえば検索候補に閲覧可の文書だけが含まれても、引用リンクが元システムの権限を回避しては意味がありません。回答の引用先を開く際にも、原本側で改めて認証・認可を行う設計が必要です。
エージェントがチケット更新やファイル送信を行う場合、読む権限と書く権限を混同しないでください。ツール呼び出しは利用者の委任範囲に限定し、高リスク操作には確認画面または追加承認を挟みます。
- 検索・生成・引用に同じ利用者文脈を引き継ぐ
- リンク先の原本システムでも再認可する
- AIエージェントの書込み権限を最小化する
ベクトル検索RAGに適した隔離方式を決める
隔離方式はデータ境界の強さで選ぶ
ベクトル検索RAGの隔離方式には、代表的に2 つの代表的な実装パターンがあります。テナントまたは部署ごとにインデックスを分離する方法と、単一インデックスでメタデータフィルタを厳格に適用する方法です。
分離インデックスは、物理的・論理的な境界を説明しやすく、誤ったフィルタ指定の影響を閉じ込めやすい方式です。一方でテナント数が多い場合、インデックス作成、監視、バックアップ、コスト管理が複雑になります。
単一インデックス方式は運用を集約できますが、フィルタ漏れが即座に越境検索につながります。検索APIで必須フィルタをサーバー側から付与し、任意のクエリパラメータでは解除できないようにします。
- 強い隔離が必要なら分離インデックスを優先する
- 大量テナントでは運用集約の利点も検討する
- フィルタ条件を利用者入力に委ねない
ベクトルDBの機能を過信しない
Pinecone、Weaviate、Qdrant、OpenSearchでは、名前空間、コレクション、テナント、フィルタなどの仕組みが異なります。製品機能だけで認可を完結させず、アプリケーションと認可サービスで多層防御することが基本です。
Weaviateはv1.20 からネイティブ multi-tenancy を正式実装し、1 ノードあたり 50000+ tenants に対応するとしています。ただし、利用するクラスタ構成、データ量、検索負荷で実効性能は変わるため、必ず自社条件で検証します。
OpenSearchのフィルタ検索やQdrantのpayload条件は便利ですが、権限属性の品質が前提です。文書IDとチャンクのtenant_idが不一致なら、どれほど高性能な検索エンジンでも正しい隔離は実現できません。
- DB固有の隔離機能とアプリ側認可を併用する
- 権限属性の不整合を取り込み時に検出する
- 負荷試験は実データ量と同等の条件で行う
検索前フィルタを性能指標と一緒に評価する
権限付き検索では、Pre-Filter認可を原則とします。許可済みの対象へ検索範囲を絞ってから近傍探索するため、Post-Filterで候補を捨てすぎて回答不能になる問題を避けやすくなります。
評価では回答品質だけでなく、nDCG(normalized Discounted Cumulative Gain)、MRR(Mean Reciprocal Rank)、レイテンシ、QPSを確認します。許可文書だけを母集団にした指標と、権限なし文書が0件である検証を分けて測定します。
実装検証では、たとえばdimension=1024、cloud=”aws”、region=”us-east-1″のように環境条件を固定します。検索設定の差分が結果へ与える影響を追跡し、再現できる負荷試験記録を残すことが重要です。
- Post-Filter単独に依存しない
- 品質指標と漏えいゼロ検証を別々に測る
- 環境・モデル・検索条件を固定して比較する
精度と根拠を両立する検索・生成設計
チャンク設計は権限境界を壊さない単位にする
RAGチャンク設計では、意味のまとまりと権限のまとまりを一致させることが答えです。異なる部署の付録や別顧客の記録を1つのチャンクへ混ぜると、フィルタを正しく設定しても機密部分が同居します。
一般的な初期値として500〜1000 tokens程度で分割し、見出し・表・段落の境界を尊重します。ただし、この値は正解ではありません。規程、手順書、FAQなど文書種別ごとに検索テストを行って調整します。
チャンクには原本URI、文書バージョン、ページまたは見出し、権限継承元を保存します。文書単位で閲覧可でも、一部が限定公開なら、より厳しい権限をチャンクへ適用する方針を明確にします。
- 権限の異なる情報を同じチャンクに混在させない
- 見出し構造を保って分割する
- 原本位置と権限継承元をメタデータ化する
再ランキングで許可済み候補の根拠性を高める
RAG再ランキングは、認可済みの候補内で質問に最も関係する根拠を上位へ並べ替える処理です。まずフィルタで閲覧不可の候補を除外し、その後にクロスエンコーダーやLLMで関連性を評価する順序を守ります。
候補を増やしすぎると、関係の薄い文書や矛盾した記述がコンテキストを占有します。初期検証では広めに取得し、再ランキング後に必要な根拠だけを採用することで、回答の焦点と説明可能性を高めます。
設定例を残す際は、検索段階の”k”: 100と、生成に渡す”k”: 4を区別して記録します。model=”multilingual-e5-large”や再ランキングモデルの変更も、精度変動の原因として監査可能にします。
- 認可フィルタを再ランキングより先に適用する
- 取得件数と採用件数を別の設定として管理する
- モデル変更時は検索品質を再評価する
引用表示と幻覚対策を回答仕様に組み込む
RAG引用表示は、回答の各主張を読者が原文へ戻って確かめられるようにする機能です。引用には文書名、該当見出し、更新日、権限確認済みのリンクを付け、根拠がない内容は断定しない回答方針を定めます。
RAG幻覚対策では、検索結果に根拠がない場合に「情報が見つからない」と返すことが重要です。LLMへは、提供コンテキスト以外の社内事実を補完しないこと、引用のない数値を出さないことを明示します。
RAG精度改善を進める際は、正答率だけで成功と判断しません。引用の正確性、権限外情報の非出力、回答不能時の適切な拒否を評価セットへ加え、利用部門によるレビューを継続します。
- 主張と引用箇所を対応付ける
- 根拠不足時は回答を保留する
- 正答率と安全な拒否を同時に評価する
RAGセキュリティを運用と失効処理で完成させる
知識ベース汚染を取り込み前に防ぐ
RAGセキュリティでは、信頼できない文書をそのまま検索対象へ入れないことが最優先です。文書ポイズニングや間接プロンプトインジェクションは、検索上位の文書に悪意ある命令を埋め込み、モデルの挙動を変えようとします。
USENIX Security 2025で採択された研究では、対象質問あたりjust five poisoned texts per target questionで、90% attack success ratesが報告されています。数百万件規模の知識ベースでも影響し得るため、件数の少なさを安全の根拠にできません。
取り込み時は、作成者、取得元、承認者、SHA-256ハッシュ、登録日時をマニフェスト化します。承認されていないソースは隔離し、異常な更新や危険な指示文を検知した場合は、直前の安全な版へロールバックできるようにします。
- データソースの作成者と完全性を検証する
- 承認前の文書を本番インデックスへ入れない
- ハッシュと版管理でロールバック可能にする
権限変更を検索・キャッシュ・履歴へ即時反映する
RAG運用で見落とされやすいのが、異動、退職、契約終了、文書削除後の失効設計です。原本のACLだけを更新しても、埋め込み、ベクトルDB、キャッシュ、会話履歴に古い内容が残れば漏えいします。
失効イベントを受けたら、権限判定キャッシュを無効化し、該当チャンクを検索対象外にします。削除要求では原本、オブジェクトストレージ、ベクトル、検索インデックス、派生要約の削除状況を追跡し、完了を記録します。
GDPR right to erasureのような削除要求を想定すると、データの系譜を追える設計が不可欠です。会話履歴に提示済みの内容を再表示する場合にも、表示時点の権限で再認可し、失効後はアクセスを止めます。
- 権限変更イベントを検索基盤へ連携する
- ベクトル・キャッシュ・派生データを削除対象に含める
- 会話履歴の再表示時にも再認可する
監査・レッドチーム・改善を継続する
本番のRAG運用では、回答品質と安全性を毎日観測します。少なくとも質問、利用者属性、適用ポリシー、検索文書ID、引用ID、拒否理由、モデル設定を結び付け、機密本文を必要以上にログへ残さない運用にします。
モデル設定も変更管理の対象です。たとえばmodel=”gpt-5-nano-2025-08-07″、model schema 1.1、gpt-4o-miniなどの変更時は、権限外文書の誘導、引用偽装、プロンプトインジェクションを含む回帰試験を実施します。
運用開始後は、悪意ある文書を混ぜる試験、他テナントIDを指定する試験、削除直後の再検索試験を定期化します。問い合わせ対応時間を30%短縮、FAQ回答精度80%以上といった業務成果も、安全性の評価を通過した範囲で追跡します。
| 段階 | 実施内容 | 確認記録 |
|---|---|---|
| 受付 | 変更イベント受信 | 対象ID・時刻 |
| 遮断 | 検索・キャッシュ無効化 | 拒否結果 |
| 削除 | ベクトル・派生物削除 | 削除ジョブID |
| 検証 | 再検索・再表示試験 | 試験ログ |
| 監査 | 完了承認 | 監査証跡 |
- 監査ログはポリシー・検索・回答を結び付ける
- モデル更新時に安全性回帰試験を行う
- 業務KPIと漏えい防止KPIを並行管理する
まとめ
RAG権限設計の本質は、文書管理の権限を検索・生成・引用・履歴まで途切れさせずに適用することです。認可済みデータだけを検索し、根拠を引用し、権限変更を即時に反映することで、利便性と安全性を両立できます。
要点
- 認可はLLMへ渡す前の検索段階で強制する
- RBACを基盤に、例外はABAC・ReBACで表現する
- 権限メタデータを文書・チャンク・引用へ一貫して付与する
- RAG再ランキングは認可済み候補だけに対して実行する
- 失効対象は原本だけでなく、ベクトル・キャッシュ・会話履歴まで含める
まずは、現在の社内文書から機密区分、所有者、テナント、閲覧期限を棚卸ししてください。そのうえで、代表的な利用者ごとの許可・拒否テストを作り、検索前認可と失効処理を含む小規模な検証から始めることをおすすめします。
よくある質問
Q1. RAG権限設計で最初に決めるべきことは何ですか?
最初に決めるべきは、誰がどの文書・チャンクを読めるかという認可モデルです。次に、その判定結果を検索前フィルタ、引用リンク、会話履歴の再表示まで引き継ぐ方法を設計します。
Q2. メタデータフィルタだけでRAGアクセス制御はできますか?
メタデータフィルタは有効ですが、それだけに依存するのは危険です。サーバー側で必須条件として強制し、認可サービス、原本側の再認可、監査ログと組み合わせる多層防御が必要です。
Q3. RAG引用表示はセキュリティに役立ちますか?
役立ちます。回答の根拠を検証しやすくなり、根拠のない生成を抑制できます。ただし、引用リンク自体が権限を迂回しないよう、リンク先の原本システムでも認証・認可を行う必要があります。
Q4. 退職者の権限を削除するとき、ベクトルDBも更新すべきですか?
はい。ユーザー権限の失効時は検索時の認可キャッシュを無効化します。文書削除や閲覧範囲の変更時は、該当するベクトル、検索インデックス、キャッシュ、派生要約、会話履歴の再表示権限も確認します。
Q5. RAG精度改善とRAG幻覚対策は両立できますか?
両立できます。認可済みの候補に限定して再ランキングし、根拠チャンクを引用し、根拠が不足する場合は回答を保留する設計にします。正答率だけでなく、引用精度と安全な拒否率も評価してください。
参考文献・出典
* [Solutions](#) + [WitnessAI for Applications](https://witness.ai/for-applications/) + [WitnessAI for Employees](https://witness.ai/for-employees/) +…
witness.ai
[](/) [NEW ウェビナー](/webinar/)…
kaopiz.com
[Skip to content](#CONTENT) [Skip to navigation](#HEADER) [Skip to footer](#FOOTER) # RAGへの攻撃リスクに備えたセキュリティ 対策を徹底解説…
www.fortinet.com