2026.11.11
AI客服機器人如何串接知識庫與流程,真正降低服務成本
AI資訊
AI客服機器人能否真正降低客服負擔,關鍵不在於「會不會聊天」,而在於能否從正確資料找到答案、辨識高風險問題,並在必要時把完整對話脈絡交給真人。當消費者期待即時回覆、企業又面臨人力與服務量波動時,單靠固定話術或人工輪班,往往難以兼顧速度、一致性與成本。
對製造、零售、貿易與專業服務業而言,客服問題常牽涉訂單、報價、保固、庫存、交期、付款與技術文件;這些資訊分散在網站、ERP、CRM、工單系統與內部文件中。若沒有資料治理與權限設計,導入 AI 不僅可能答錯,也可能暴露不該公開的內容,因此必須把客服視為一項可管理的服務流程。
本文會從 AI Chatbot 的運作方式開始,說明企業知識庫聊天機器人如何透過檢索增強生成建立可信答案,再延伸到 AI語音客服、AI工作流程、AI流程自動化與 AI數位員工的整合。最後也會提供 PoC、KPI、資安測試與正式營運的實務檢核方向,協助決策者從小規模驗證走向穩定上線。
AI客服機器人是什麼?先釐清服務邊界與運作原理
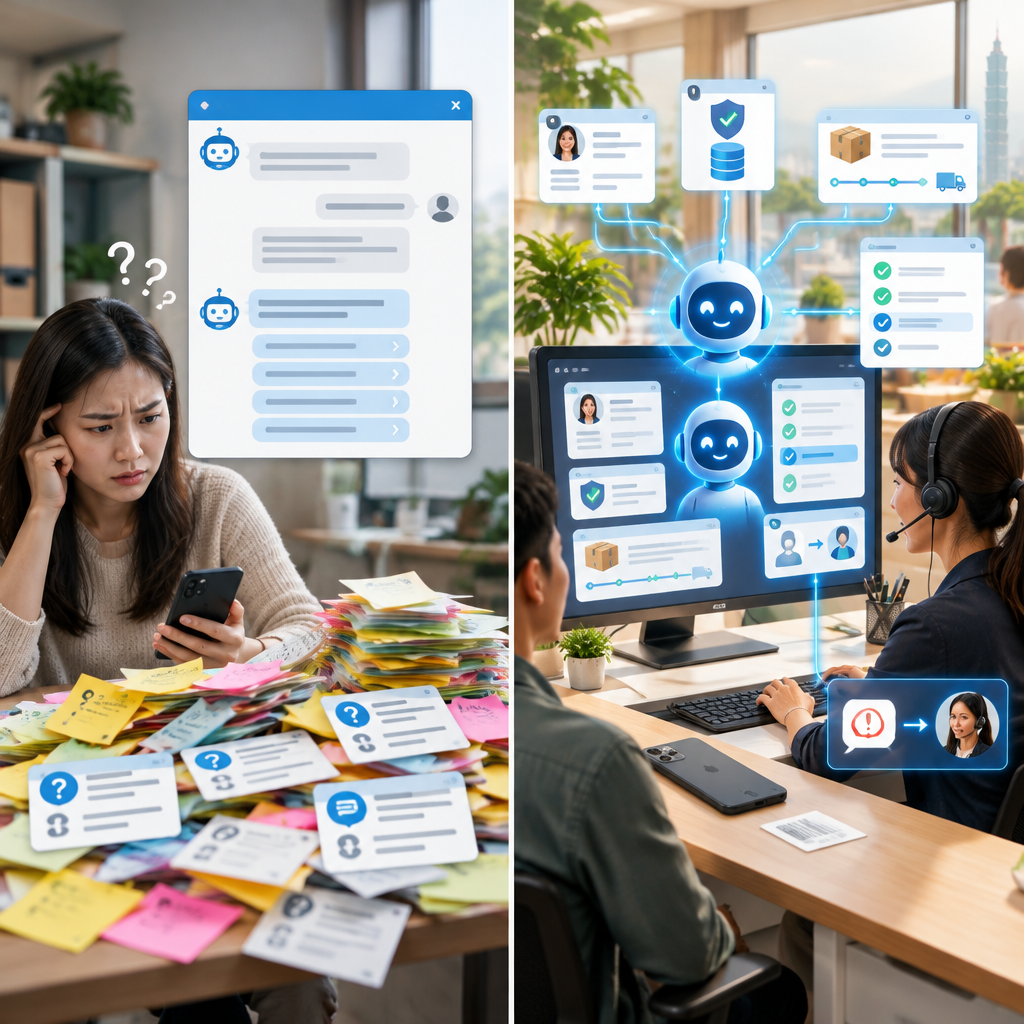
AI客服機器人不是單純的自動回覆
AI客服機器人的核心任務,是理解使用者意圖、查找可信來源、產生可執行的回覆,並在超出授權範圍時轉交真人。它不同於只能依關鍵字觸發的規則型選單,也不同於只會生成文字的通用聊天工具;企業情境需要將對話連到產品資料、客服政策、訂單狀態與工單流程,才能真正處理服務請求。
技術上,現代 AI Chatbot 通常結合自然語言處理、大型語言模型、對話管理與檢索機制。使用者問「我的設備保固到何時」,系統應先確認身分與設備序號,再查詢保固資料,而不是根據公開 FAQ 猜測。這種「理解、檢索、判斷、執行、記錄」的鏈路,才是企業級客服與一般聊天視窗最重要的差異。
客服場景仍要保留明確邊界。涉及退款核准、醫療建議、合約解釋、金融交易、客訴升級或個資查詢時,系統應先完成身分驗證、蒐集必要資訊,再依規則轉人工。所謂自動化不代表取消人員,而是讓客服人員把時間用在高情緒、高價值與需要判斷的案件上。
- 適合自動處理:商品規格、營業時間、訂單進度、預約與常見操作。
- 應優先轉人工:爭議款項、例外折扣、法規解釋、重大客訴與敏感個資。
- 每一則回答應保留來源、信心分數、使用版本與轉接紀錄。
消費者期待速度,但企業必須守住正確性
即時回覆是導入 AI客服機器人的直接價值。調查資料顯示,59% 的消費者期待在 5 秒內收到聊天機器人回覆,74% 客戶更偏好用機器人解決簡單問題。這代表企業不能只用「客服信箱已收到」當作數位服務,而應讓簡單問題能立即取得具體答案或下一步操作。
不過,速度不能凌駕事實。客服機器人若把過期促銷、舊版保固條款或他人訂單資料回答給客戶,後續補救成本往往高於人工處理。因此,答案應要求附帶來源連結、文件版本或系統查詢時間;找不到可靠依據時,應清楚說明無法確認,而不是產生看似合理的內容。
企業可先將問題依風險分成三層:低風險 FAQ 可直接回覆;中風險問題須引用資料並要求使用者確認;高風險交易則只能協助蒐集資訊與建立工單。這套分級能讓服務團隊把「回答率」與「錯誤成本」一起管理,避免追求自動化率而犧牲品牌信任。
- 低風險:物流規則、產品手冊、門市資訊與公開活動。
- 中風險:個人訂單、維修資格、會員權益與庫存查詢。
- 高風險:付款、退款、合約、個資、法規與安全事件。
全通路服務要共用脈絡,而非各自回答
全通路的目標,是讓客戶不必重複描述問題。網站、LINE、Facebook、Instagram、WhatsApp、電子郵件與客服中心若各自運作,客戶從社群轉到電話時又得重新提供訂單編號,真人也看不到先前機器人的回答,將直接破壞服務體驗。企業應以同一案件編號串起通路、身分與對話摘要。
通路能力也有所不同。WhatsApp 自動回覆只能提供一次回覆,無法自動回答之後的查詢;WhatsApp 快速回覆仍需真人操作。相較之下,串接知識庫、意圖辨識與工作流程的 AI Chatbot,才能根據追問持續對話、補問資訊,或引導使用者完成預約、查件與報修。
語言策略也應在 PoC 階段驗證。Chatalog 的 AI 客服機器人就能支援英文、繁體中文、簡體中文、廣東話等多種語言,但企業仍需以自家產品術語、台灣地址格式、口語問法與客服慣用語測試品質。多語言不等於翻譯功能存在,而是每一種語言都能得到一致且合規的服務。
- 以客戶識別碼與案件編號串接跨通路對話。
- 轉人工時提供問題摘要、已查資料與客戶情緒標記。
- 分別驗證繁體中文、英文與產品專有名詞的理解品質。
企業知識庫聊天機器人:讓答案可追溯、可維護、可授權
知識庫品質決定客服回答上限
企業知識庫聊天機器人必須先管理內容,才談得上生成答案。它可整合 FAQ、產品手冊、維修 SOP、合約條款、教育訓練教材與工單紀錄,再透過語意搜尋找出相關段落,交由模型整理回覆。若原始文件互相矛盾、沒有生效日期或責任人,即使模型能力再好,也只會更快地放大錯誤。
建立知識庫時,建議為每份內容加上文件類型、產品線、適用地區、語言、版本、生效日、到期日、保密等級與內容負責人。資料頁若曾標示 2024-08-27 03:36、更新:2025-12-23,營運者仍應確認那是系統時間、內容更新時間或政策生效時間,不能直接把頁面日期當作客服承諾依據。
許多平台宣稱可在短時間建立知識庫,但上線速度不等於可用性。真正值得追蹤的是來源覆蓋率、檢索召回率、引用正確率、無法回答率、答案正確率與更新延遲。企業若設定 80% 作為初期答案正確率門檻,仍應依風險類別拆解,而非讓高風險問題用平均數掩蓋品質缺口。
- 每份文件指定內容負責人與覆核期限。
- 過期 SOP 必須下架或標示不可用,避免與新版衝突。
- 客服答案應顯示來源名稱、段落與最新版本。
RAG 檢索流程要能回答「根據什麼」
RAG 的價值,是讓模型優先依企業資料回答,而不是憑通用知識推測。流程通常包括文件清理、切分段落、建立向量索引、語意檢索、重排序與生成回覆。客戶詢問特定型號的故障代碼時,系統應檢索該型號與該版本手冊,再以引用內容組成答案,並在沒有證據時採取拒答或轉人工策略。
分段策略需依文件結構調整。技術手冊可依章節、機型與步驟切分;保固條款則不應把例外條款拆離主條文。某些設定會以「分段最大长度」设置为1000 作為起點,但這只是測試參數,不能取代以真實客服題庫評估命中率、上下文完整性與引用正確性的工作。
模型的上下文長度也不是唯一選型條件。部分企業方案標示最高可達 128K token,可一次處理較長的文件與對話,但若檢索結果混入過多重複內容,反而提高成本與錯答風險。較穩健的設計是先縮小資料範圍、重排序關鍵段落,再把有限上下文交給模型生成答案。
- 先做文件去重、版本合併與敏感欄位遮罩。
- 以真實問法建立離線測試集,包含錯字、縮寫與追問。
- 答案沒有足夠來源時,採用澄清、拒答或轉人工。
權限、版本與內容維運不能交給模型自行判斷
企業知識庫聊天機器人的權限,必須在檢索前就生效。部門、職級、專案、客戶帳號與文件密級都要映射到身分系統,讓不同使用者只檢索到被授權的內容。若先把所有資料找出來,再要求模型「不要透露機密」,就等於把資料保護寄望於文字指令,無法滿足企業內控要求。
內容維運應建立固定節奏:客服與業務回報無法回答或錯誤回答;知識負責人於服務等級期限內修訂;系統重新索引並以題庫回歸測試;管理者再查看採用率與錯誤趨勢。市面內容曾以「支持90多种语言,自动化处理90%以上的客户咨询」描述能力,企業仍應以自己的資料、語言與風險情境驗收。
採購時也應看清方案容量與資料政策。文件格式、Token、向量儲存、查詢次數、資料是否用於訓練、刪除機制與跨境傳輸,都會影響總持有成本。網路文章可能標示「文章最後修改於 2025-09-12」,這提醒團隊不能只依教學文選型,而要索取當前合約、資安白皮書與服務等級條款。
- 同步離職、調職與專案結束的撤權機制。
- 每月檢查過期內容、矛盾答案與高頻無解問題。
- 保留檢索紀錄、回答版本、引用來源與人工覆核結果。
企業聊天機器人與AI語音客服如何選擇服務入口
先按任務選擇企業聊天機器人類型
企業聊天機器人應依任務選型,而不是先被平台功能表吸引。客服型機器人處理公開資訊、訂單與服務案件;內部知識型協助員工搜尋制度與 SOP;流程型代理則可建立工單、查詢庫存或送出申請;銷售型則負責蒐集需求、資格判定與預約。不同類型需要的權限、整合深度與錯誤容忍度完全不同。
第一個聊天機器人便是一個規則型機器人,名為 ELIZA,於 1966 年在麻省理工學院創造而出。今日的生成式模型能處理自然語言與多輪追問,但企業仍不應把所有情境都交給自由生成。對於固定、可預期且高頻的流程,明確規則與表單往往更容易稽核,也更容易降低誤觸風險。
評估企業聊天機器人時,可先訪談客服、業務、IT、法務與現場主管,整理前二十個高頻問題及其處理時間。若其中多數只是查詢型問題,可優先做知識庫 PoC;若需要跨系統建立紀錄或更新狀態,則必須評估 API、身份驗證、審批機制與交易失敗後的補償流程。
- 客服型:公開問答、訂單查詢、報修與轉人工。
- 內部型:IT 支援、人資制度、教育訓練與文件搜尋。
- 流程型:查庫存、建工單、申請簽核與任務提醒。
AI語音客服適合高量來電,但要先設計轉接規則
AI語音客服最適合處理重複、可驗證且講求即時性的來電。例如查詢門市營業時間、預約狀態、物流進度、報修進度或帳務繳款方式。它通常結合語音辨識、意圖判斷、文字生成、語音合成與客服系統,因此評估時不能只聽語音自然度,更要測試台灣口音、環境雜訊、號碼辨識與轉接後的脈絡保留。
語音通路的最大風險是錯聽與誤解。系統應在取得訂單號、身分證字號、地址或付款資訊前,逐段覆誦確認;辨識信心不足時,應提供按鍵輸入或直接轉真人。對於情緒明顯升高、重複抱怨、威脅性語句或敏感交易,也應設定立即升級規則,而不是持續要求客戶重複描述。
導入 AI語音客服後,應同時觀察自助完成率、放棄率、平均處理時間、轉人工率、轉接後重複敘述率與客訴率。若語音機器人只讓客戶繞一圈再回到真人,表面上接聽量雖下降,實際上卻增加顧客挫折;因此轉接摘要與錄音標記是衡量體驗的必要資料。
- 先從查件、預約、營業資訊等低風險來電開始。
- 敏感資料採逐段確認、遮罩與最小化蒐集。
- 真人接手時顯示來電目的、已驗證資料與建議處置。
比較平台成本時,要把管理與整合費用算進去
平台月費只是企業聊天機器人成本的一部分。除了座席或使用者授權,還要納入模型用量、知識庫儲存、向量資料庫、通路訊息費、CRM 或 ERP 串接、監控、資安測試與內容維護人力。若只比較初始訂閱價格,往往會低估正式營運後持續調整流程、處理例外案件與維護權限的成本。
市場上的協作與企業工具定價差異很大,例如提供免費方案;分級定價,起價為 每位使用者每月 US$7.25,也有企業用途每位使用者每月 US$23.50 起的方案。另有分級定價,每位使用者每月 US$21 起,或 Business 方案每位使用者每月 US$20 起;Enterprise 方案依需求報價的模式。這些價格只能作為預算起點,不能直接等同完整客服導入費用。
建議以相同題庫、相同資料集與相同整合需求做公平測試,觀察答案品質、延遲、管理介面、稽核能力與退出機制。採購文件應要求供應商說明資料留存位置、模型供應商變更通知、可匯出資料格式、服務中斷應變與 API 限制,避免日後因平台綁定而無法調整架構。
| 方案類型 | 公開起價 | 適合用途 | 採購注意事項 |
|---|---|---|---|
| 免費與入門方案 | 每位使用者每月 US$7.25 | 小型團隊試用 | 功能與用量限制 |
| 企業使用方案 | 每位使用者每月 US$23.50 起 | 跨部門協作 | 權限與稽核能力 |
| 分級方案 | 每位使用者每月 US$21 起 | 部門導入 | 整合附加費 |
| 商務與企業方案 | 每位使用者每月 US$20 起 | 正式營運 | Enterprise 方案依需求報價 |
- 比較每月固定費、每次查詢費、整合費與維運人力。
- 以相同題庫評估正確率、引用率、延遲與轉人工品質。
- 確認資料可攜性、稽核日誌、服務等級與供應商退出條款。
從客服對話延伸到AI工作流程與AI流程自動化
客服自動化的下一步是完成工作,而非只回答問題
AI工作流程的目標,是讓對話觸發可控的後續作業。例如客戶詢問退貨,機器人先確認訂單與退貨資格,再建立申請單、通知倉儲、發送標籤與回寫 CRM;客戶詢問維修,則可蒐集型號、故障碼與照片,依保固規則建立工單。這比單純提供「請聯絡客服」更能縮短處理時間。
AI流程自動化不等於讓模型直接寫入所有系統。較安全的架構是把模型用於理解需求、摘要資料與建議路徑,而關鍵交易交由規則引擎、API 權限與人工核准控制。舉例來說,模型可判定客戶正在申請換貨,但是否核准、可退金額與庫存保留,仍應由正式系統依既定條件決定。
在製造業情境中,客服問題也常是現場訊號。當多位客戶反覆回報同一批產品異常,系統可自動彙整型號、批號、區域與故障描述,通知品保與售後團隊調查。這種從對話到內部任務的串接,讓客服不只是成本中心,也成為品質改善與產品決策的資料入口。
- 模型負責理解、分類、摘要與提出建議。
- 規則引擎負責資格判定、金額計算與權限驗證。
- 人工負責例外核准、爭議處理與高風險最終決策。
AI數位員工要有職務說明書與可稽核紀錄
AI數位員工應被視為有明確職責、權限與績效指標的數位角色。例如「售後服務助理」只能讀取已授權的產品與工單資料、建立草稿與提醒待辦,不能自行核發退款;「採購詢問助理」可以彙整供應商交期與報價,卻不能自行送出訂單。先寫清楚職務說明書,才能避免能力擴張失控。
每個數位角色都應保留輸入資料、檢索來源、工具呼叫、結果、失敗原因與人工覆核紀錄。這些日誌可協助調查錯誤,也能在模型版本更新、提示詞調整或資料來源改動後,找出品質下降的原因。若缺乏可觀測性,團隊只會知道「最近常答錯」,卻不知道是資料、模型、整合還是權限設定造成。
導入初期建議採取「建議模式」而不是直接執行。讓 AI數位員工先產出工單分類、回覆草稿或庫存異常摘要,再由人員接受、修改或拒絕。累積足夠的正確紀錄後,才逐步開放低風險動作;這種分階段授權方式比一次全面自動化更容易建立信任與內部共識。
- 替每個數位角色定義可讀資料、可用工具與禁止動作。
- 所有外部動作都應有可追溯的案件編號與稽核日誌。
- 先讓人員覆核草稿,再逐步開放低風險自動執行。
用客服數據找出最值得自動化的流程
最適合 AI流程自動化的項目,通常是高頻、規則清楚、資料可取得且錯誤可回復的工作。企業可以從客服標籤、來電原因、工單類別與處理時間中,找出重複量最高的前十個問題,再估算每類案件的月量、平均處理時間、轉人工比例與錯誤成本,建立導入優先順序。
效益計算不應只看減少多少客服人力,而要同時評估縮短首次回覆時間、降低重複聯絡、增加自助完成率、減少漏單與提高資料完整度。若機器人能在下班時間建立完整報修工單,隔天工程師可直接派工,產生的價值可能來自縮短停機或等待,而非單純減少對話分鐘數。
營運儀表板建議同時呈現自動解決率、轉人工率、首次回覆時間、平均處理時間、重複提問率、CSAT、引用正確率與錯誤率。當自動解決率上升但 CSAT 下跌,可能表示機器人過度阻擋真人服務;當轉人工率升高,則可能是知識缺口、意圖分類不足或流程設計不完整。
- 先盤點月量高、處理時間長、規則固定的客服案件。
- 用客服、營運、品質與營收的綜合效益評估投資。
- 將成效指標與錯誤事件一起檢視,避免只追求自動化比例。
AI客服機器人導入藍圖:從PoC驗證走向可治理的正式營運
先以 PoC 證明可行性與效益,再擴大投資
AI客服機器人的 PoC 應回答「值不值得做」,而不是只展示聊天畫面。企業先選擇一個問題明確、資料相對完整、風險可控的情境,例如產品 FAQ、售後報修分流或內部 IT 問答;接著以真實文件與真實問題建立原型,測試回答正確性、引用品質、使用者接受度與系統整合限制。
有效的 PoC 會在一開始定義成功門檻,例如特定題庫的答案正確率、可引用比例、無法回答時的轉人工成功率,以及每件案件節省的處理時間。若驗證結果顯示資料缺漏嚴重、權限無法落實或使用者不採用,做出暫緩開發的決定同樣有價值,因為它避免企業在不成熟的前提下投入大型專案。
小規模驗證可採用現場調查、需求訪談、原型測試與效益報告的節奏。ALION 的 AI 上游工程訂閱服務提供月費 20 萬日圓起的做法,包含需求梳理、設計文件與示範製作;相較於可行性未明就進入大規模開發,這類方式較適合需要先建立內部決策證據的傳統產業團隊。
| 階段 | 主要工作 | 驗收重點 | 交付成果 |
|---|---|---|---|
| 目標定義 | 盤點客服量與痛點 | KPI 與風險範圍 | 需求清單 |
| 資料準備 | 清理 FAQ 與 SOP | 版本與權限完整性 | 知識庫樣本 |
| 原型驗證 | 測試真實問題集 | 正確率與轉接品質 | 可操作原型 |
| 效益判斷 | 比較前後流程 | ROI 與治理缺口 | Go/No-Go 報告 |
- 選擇高頻、資料可用、低至中風險的第一個驗證情境。
- 以真實題庫與實際流程測試,不用展示用範例取代驗收。
- 設定 Go、改善後再驗證、No-Go 三種明確決策結果。
把資安、幻覺與提示注入納入上線前測試
正式上線前,必須把錯誤回答視為可測試的風險事件。除了正常問答題庫,團隊還要設計紅隊測試:要求機器人忽略規則、誘導它揭露內部文件、以不同身分查詢他人資料、輸入惡意網址、要求執行未授權動作,以及利用附件內容注入指令。每個測試都應有預期安全行為與責任人。
對於個資與敏感資料,應落實最小權限、傳輸與靜態加密、遮罩、留存期限與刪除流程;對於跨境處理,則要檢視資料位置、委外關係、模型供應商是否用資料訓練,以及是否能依合約刪除紀錄。台灣企業也應依自身產業與個資保護義務,讓法務、資訊安全與內控單位參與設計。
模型漂移與知識漂移同樣需要監控。模型或提示版本更新後,既有題庫的答案可能改變;產品停產、政策改版或組織調整後,原本正確的知識也可能失效。因此每次版本變更都應跑回歸測試,並設定錯誤率、資安事件或轉人工率異常時的回滾條件。
- 測試越權查詢、提示注入、敏感資料外洩與錯誤工具呼叫。
- 建立模型、提示詞、知識庫與 API 的版本變更紀錄。
- 設定異常門檻與回滾流程,避免錯誤持續擴散。
以 LLMOps 維持可量測、可改善的服務品質
LLMOps 是讓 AI客服機器人長期可靠運作的管理方法。它整合資料更新、提示詞管理、模型版本、離線評測、線上監控、事件處理與回饋迴圈。客服、產品、IT 與資安團隊不必各自猜測問題,而能以同一套儀表板查看哪些問題答錯、哪些來源過期、哪些通路轉人工最多,以及哪些改善已產生效果。
營運初期可每週檢視高頻無解問題、負評對話、人工改寫比例與來源缺口;每月則檢視成本、使用量、資安事件、模型延遲與採用率。若某項問題反覆出現卻沒有可靠來源,最好的處置不一定是調整提示詞,而是回到流程與文件,要求真正負責該政策的部門補齊內容。
參考資料可優先查閱 NIST AI Risk Management Framework(https://www.nist.gov/itl/ai-risk-management-framework)、OWASP Top 10 for LLM Applications(https://genai.owasp.org/llm-top-10/)、Microsoft Responsible AI(https://www.microsoft.com/ai/responsible-ai)與 OpenAI Enterprise Privacy(https://openai.com/enterprise-privacy/)。這些來源可協助團隊建立風險語言、測試項目與治理責任。
- 每週處理高頻無解與負評對話,讓知識庫持續成長。
- 每次模型、提示詞或文件變更都執行回歸測試。
- 將品質、成本、資安與使用者回饋放在同一營運儀表板。
總結
AI客服機器人成功的本質,不是把真人客服替換成聊天視窗。真正可持續的做法,是以可信知識庫提供可追溯答案,以人機協作處理例外與情緒,以 AI工作流程完成後續任務,並透過 PoC、資安測試與 LLMOps 持續驗證品質。當企業先從高頻、低風險且資料可用的情境開始,就能更務實地衡量投資效益與擴充路徑。
重點整理
- AI客服機器人應具備來源引用、風險分級、轉人工與跨通路脈絡交接能力。
- 企業知識庫聊天機器人的關鍵在內容治理、權限隔離、版本控管與持續測試。
- AI語音客服與企業聊天機器人應依任務、資料、風險與整合需求分別設計。
- AI流程自動化應讓模型負責理解與建議,關鍵交易交由規則、權限與人工覆核控制。
- 先以可量測的 PoC 驗證真實題庫、KPI 與治理缺口,再決定是否進入正式開發。
若您正在評估客服、知識搜尋或流程自動化,建議先盤點近三個月的客服案件、前二十個高頻問題、可用文件、既有系統與風險事件。接著選擇一個可在小範圍驗證的情境,讓客服、業務、IT、資安與現場主管共同定義成功標準;如此才能讓 AI 專案從展示效果,真正走向可營運的服務能力。
常見問題 FAQ
Q1. AI客服機器人可以完全取代真人客服嗎?
不建議。AI客服機器人適合處理高頻、規則清楚與低風險問題;涉及爭議、情緒安撫、例外核准、付款、個資或法規判斷時,應由真人接手。最佳模式是由 AI 先完成理解、查詢與摘要,讓真人快速處理高價值案件。
Q2. 企業知識庫聊天機器人需要準備哪些資料?
可從 FAQ、產品手冊、SOP、保固條款、服務政策、工單分類與教育文件開始,但必須同時整理版本、生效日期、適用範圍、權限與內容負責人。未整理的舊文件、矛盾規則與敏感資料,不應直接匯入供機器人檢索。
Q3. AI客服機器人導入多久可以看到效果?
若先聚焦單一情境,企業可透過 PoC 快速驗證題庫品質、轉人工流程與效益假設;但正式營運時間仍取決於知識庫整理、身份驗證、CRM 或 ERP 串接、資安審查與跨部門驗收。應以驗收門檻而非單純時程判斷是否擴大。
Q4. 如何衡量 AI客服機器人的成效?
至少應追蹤自動解決率、轉人工率、首次回覆時間、平均處理時間、重複提問率、CSAT、答案正確率、引用正確率、無法回答率與錯誤率。所有指標都應區分低風險與高風險案件,避免平均數掩蓋重大錯誤。
Q5. 導入 AI語音客服時最容易忽略什麼?
最常被忽略的是錯聽後的確認流程,以及轉真人時是否保留對話脈絡。語音系統應測試口音、雜訊、數字與專有名詞辨識;當信心不足或問題涉及敏感資料時,要能迅速改用按鍵輸入、文字通路或真人服務。