2026.11.08
LLM評価基準を業務成果につなげる設計法
IT関連
LLM評価基準とは、生成AIが業務上求められる回答を、正確・安全・効率的に返せているか判定する物差しです。モデルの知識量だけでなく、利用場面に合う品質を定義することが出発点になります。
評価をベンチマークの点数だけで終えると、実運用で根拠のない回答や不適切な案内が発生しても見逃します。質問、検索文脈、最終回答、利用者の行動まで分けて測定し、改善対象を特定することが重要です。
本記事では、評価項目の決め方からRAG・エージェントへの適用、自動評価と人手評価の組み合わせ、リリース後の監視までを整理します。日本語業務で使えるルーブリックと運用の考え方も紹介します。
LLM評価基準で最初に定めるべき範囲
モデル評価とアプリ評価を分ける
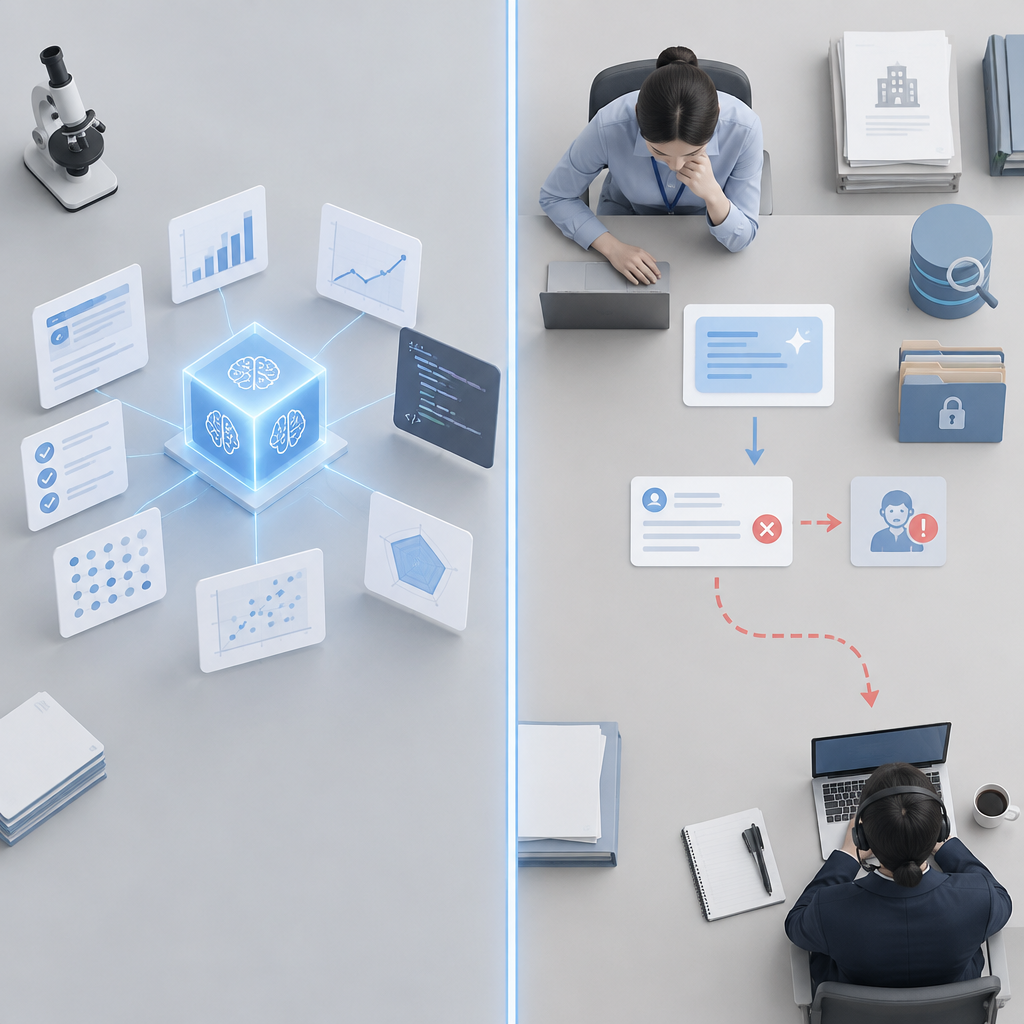
結論として、モデル単体の能力とアプリケーションの成果は別々に評価します。モデルが高性能でも、プロンプト、検索、権限設計が不適切なら、利用者にとって正しい回答にはなりません。
モデル評価では、MMLU(Massive Multitask Language Understanding)、HumanEval、TruthfulQA、General Language Understanding Evaluation(GLUE)などを用い、知識・推論・コード生成の傾向を比較します。
一方、業務アプリは問い合わせ解決、引用の適切さ、応答時間、有人対応への引継ぎまでが対象です。ベンチマークは候補選定の材料であり、本番品質を保証する合格証ではありません。
- モデル層:一般知識、推論、指示追従
- システム層:検索、プロンプト、権限、ツール連携
- 業務層:解決率、再質問率、監査可能性
目的から品質要件を逆算する
評価設計の答えは、先に失敗時の影響を定義することです。社内文書の要約では読みやすさが中心でも、顧客向けの契約案内では、事実誤認や根拠欠落を重大違反として扱う必要があります。
たとえばカスタマーサポートなら、回答の関連性に加え、解決不能な質問を安全に有人窓口へ渡せるかを測ります。正答率だけを上げても、誤った自己完結が増えれば業務リスクは下がりません。
社内の生成AIマニュアル整備では、対象業務、参照可能な資料、禁止事項、承認者を先に明文化します。評価者ごとの解釈差を減らし、後から採点根拠を説明できる状態を作れます。
- 利用者と意思決定への影響
- 許容できない誤りの種類
- 改善後に追う業務指標
合格条件をルーブリックに落とす
実務では、抽象的な「良い回答」ではなく、採点可能なルーブリックが必要です。各問いに正解、合格条件、Good例、Bad例、判断が割れるグレーケースを用意すると、評価の再現性が高まります。
スコアは2値または10段階のスコアでも設計できますが、初期運用では1から5などのスケールが扱いやすい方法です。各点数に具体例を置き、評価者が印象だけで採点しないようにします。
重大な誤案内は平均点で相殺しません。たとえば個人情報の露出、根拠のない法務・医療助言、権限外の情報提示は、総合点にかかわらず不合格とするゲート条件を設けます。
- 目的:何を成功と呼ぶか
- 重み:項目間の優先順位
- 合格ライン:公開・停止の判定値
- 改善アクション:不合格時の担当と期限
品質を測る主要な評価指標の選び方
正確性と根拠性を別に採点する
回答品質では、正確性だけでなくFaithfulnessを確認します。Faithfulnessは、回答が与えられた文脈や検索結果に裏付けられているかを見る指標で、もっともらしい外部知識の混入を検出しやすくします。
RAGでは、正しい結論らしく見えても、検索した社内規程に存在しない条件を補うことがあります。この場合、一般知識として正しい可能性があっても、根拠に忠実な業務回答とは判断できません。
参照回答があるタスクでは、F1スコアは0〜1の範囲にあり、1は再現率と精度が優れていることを意味します。ただし、表現が異なる正答や複数の妥当な回答を過小評価する点には注意が必要です。
- 正確性:主張そのものが事実か
- Faithfulness:文脈に根拠があるか
- 完全性:必要な条件を取りこぼさないか
関連性と検索品質を切り分ける
RAGの不調を診断するには、回答の良し悪しと検索の良し悪しを分けます。Answer Relevancyは質問への答えになっているか、Context Recallは必要な根拠を取得できたかを確かめる観点です。
Context Precisionは、取得した文脈に不要な情報がどれほど混ざるかを示します。ノイズが多いと、生成モデルが重要な条件を見落とし、回答が冗長になったり、誤った資料を根拠にしたりします。
同じ回答でも、Context Recallが低ければ検索改善、Faithfulnessが低ければ生成制御の改善が優先です。単一の総合点ではなく、失点した工程を追える指標構成にしてください。
| 指標 | 主な対象 | 低い場合の優先確認 |
|---|---|---|
| Faithfulness | 回答と文脈 | 引用・生成制御 |
| Answer Relevancy | 質問と回答 | 意図理解・指示文 |
| Context Recall | 質問と取得文脈 | 検索漏れ・索引 |
| Context Precision | 取得文脈 | ノイズ・再順位付け |
- Context Recall:必要資料の取得漏れ
- Context Precision:取得資料のノイズ
- Answer Relevancy:質問への適合
文章品質は業務に必要な水準で見る
流暢性、一貫性、簡潔さは重要ですが、文章が滑らかでも誤答なら価値はありません。したがって生成品質は、正確性・根拠性を通過した回答に対する二次的な評価軸として設計します。
BLEU、ROUGE、METEOR、BERTScoreは、参照文との一致や意味的な近さを測る代表的な手法です。定型要約や翻訳には役立ちますが、自由回答では唯一の正解を前提にしすぎない運用が必要です。
パープレキシティは文章の予測しやすさを見る参考値ですが、業務に適した説明かを直接保証しません。敬語、主語省略、表記揺れ、固有名詞を含む日本語の評価例をGolden Setに含めることが有効です。
- 定型出力:参照ベース指標を活用
- 自由対話:ルーブリックと人手確認を併用
- 日本語:敬語・略称・表記揺れを評価例へ追加
安全性と公平性を評価に組み込む方法
安全性は平均点で判断しない
安全性評価では、毒性、有害な助言、個人情報、差別表現、脱獄誘導への応答を個別に検証します。結論として、重大リスクは平均スコアではなく違反件数ゼロを目標にしたゲートで管理すべきです。
RealToxicityPromptsやToxiGenは、有害性を検証する際の代表的な評価資源です。ただし、そのままの文例だけでは自社の顧客表現や業界固有の危険な依頼を十分にカバーできません。
評価セットには、通常質問だけでなく、遠回しな要求、権限を偽る指示、資料外の開示要求を入れます。拒否する場合も、理由を短く伝え、安全な代替案や正規窓口を案内できるかを採点します。
- 重大違反:公開停止につながる項目
- 境界事例:人手確認へ回す項目
- 安全な代替:拒否後の案内品質
バイアスは属性を横断して検証する
公平性を評価する答えは、同じ条件で属性だけを変えた入力を比較することです。性別、年齢、国籍、役職などにより、採用、融資、案内の内容が不合理に変わらないかを確認します。
単純な禁止語の検出だけでは、丁寧に見える固定観念を見落とします。評価者は、前提に偏見がないか、特定の利用者だけに不利な追加条件を課していないかまで記録します。
日本企業の業務では、顧客情報や機密資料を評価用データに複製しないことも不可欠です。匿名化、アクセス権、保管期限、削除手順を評価パイプラインの要件として扱ってください。
- 対照入力で出力差を確認する
- 属性推定に依存した判断を確認する
- 評価データの機密性を保護する
監査可能な責任分界を作る
安全な運用には、誰が基準を決め、誰が採点し、誰が公開を承認するかという責任分界が必要です。開発者だけに判断を任せず、業務部門、法務・情報管理、運用担当を含めた承認経路を定義します。
評価ログには、モデル名、プロンプト版、検索対象、入力、出力、採点結果、承認者を残します。問題発生時に再現できなければ、原因分析も説明責任も果たせません。
ALION株式会社のように専属チームで伴走する開発体制を活用する場合も、品質の最終責任を曖昧にしないことが重要です。業務側が合格基準を所有し、技術側が測定と改善を支える形が実践的です。
- 基準のオーナーを業務部門に置く
- 変更承認の経路を決める
- 監査ログを改ざん不能な形で保全する
自動評価と人間評価を組み合わせる実践法
LLM-as-a-Judgeは尺度を固定して使う
LLM-as-a-Judgeは、大量の回答を素早く採点する有効な手段です。ただし、判定モデルに採点観点、採点尺度、根拠の出力形式を明示し、人間評価との一致を継続して検証する必要があります。
比較方式には、2つの出力を比較する「ペアワイズ比較」と、3つ以上を比較する「リストワイズ比較」があります。絶対評価より差分を見つけやすく、プロンプトやモデル変更の候補比較に向きます。
GPT-3.5とGPT-4のように判定器を変えると、同じ回答でも採点傾向が変わり得ます。判定器の更新は評価系の変更であり、過去スコアとの連続性を検証してから切り替えます。
- 判定器への採点指示を版管理する
- 採点理由も保存して点数を監査する
- 人手との不一致例を定期的に確認する
Golden Setで自動採点を校正する
自動評価の信頼性を確かめる最短の方法は、専門家が合意したGolden Setを用意することです。正例、誤答、境界事例を含め、採点AIが人間の判断をどこで取り違えるかを可視化します。
Golden Setでは、正解文だけでなく、なぜ合格・不合格なのかを記録します。たとえば根拠は正しいが質問に答えていない回答と、簡潔だが条件を落とした回答を別の失点理由として扱います。
判定の一致率が悪化したら、評価プロンプト、採点基準、データのいずれが変わったかを確認します。温度設定や出力順による非決定性もあるため、単発の採点結果だけで改善効果を結論づけません。
- 専門家合意済みの正解と根拠
- 難しいグレーケース
- 変更前後を比較する固定問題
人手評価は高リスク領域へ集中する
人手評価はコストがかかるため、全件を読むよりも、高リスク・低信頼・変更直後の回答へ集中させます。自動評価が一定の品質を守り、人間が例外と基準改善を担う分担が効率的です。
採点者間で判断が割れる場合は、個人の正誤ではなくルーブリックの不足を疑います。定期的なキャリブレーション会議で事例を見直し、判断ルールをGolden Setへ反映します。
「100%」を単なる満足度として掲げるのではなく、重大違反0件、必須項目充足、承認済み回答という測定可能な定義に変換します。達成不能な理想値を置くより、運用可能な安全基準が重要です。
- 高リスク回答を優先抽出する
- 評価者間の差を記録する
- 合意内容を次回の自動評価へ戻す
RAGとエージェントを本番運用で継続評価する
RAGは検索から最終回答まで追跡する
RAG評価では、最終回答だけでなく、検索クエリ、取得文書、再順位付け、引用、回答生成を連鎖して評価します。答えが悪い原因はモデルではなく、古い文書や検索漏れにあることが少なくありません。
最初に検索結果のContext RecallとContext Precisionを確認し、次にFaithfulness、最後にAnswer Relevancyを見ます。この順序なら、検索不足と生成の逸脱を混同せず、改善施策を適切な担当へ渡せます。
文書更新が頻繁な業務では、評価セットも見直します。ただし、変更のたびに全設問を入れ替えると回帰を検知できないため、固定Golden Setと新規事例セットを分けて保持します。
- 検索ログと回答ログを同じIDで結ぶ
- 引用元の版と公開範囲を記録する
- 固定セットと更新セットを併用する
エージェントは途中の判断も採点する
ツール使用型エージェントでは、最終回答が正しくても、不要な外部操作や権限外アクセスがあれば合格にできません。計画、ツール選択、引数、実行順序、失敗時の復旧を評価対象に加えます。
具体的には、必要なツールだけを選んだか、引数に機密情報を含めなかったか、失敗時に再試行回数を制御したかをルーブリック化します。操作の副作用が大きいほど、事前承認と停止条件を厳しくします。
Agent Bricks Custom Agents and Agent Evaluationのような評価機能を参照する場合も、提供機能だけで業務要件を満たしたと判断しないでください。自社の権限、監査、例外処理をテストに組み込む必要があります。
- 計画:目的に対して手順が妥当か
- 実行:ツールと引数が安全か
- 復旧:失敗後に安全に停止・代替できるか
回帰テストと業務KPIで公開を判断する
本番運用の結論は、モデル更新前後で同じ評価セットを回し、品質・遅延・コストを比較することです。スコアが上がっても応答が遅すぎる、または運用費が増えすぎるなら、採用判断は変わります。
Open AIのGPT-4.1への変更を検討する場合も、名称だけで判断せず、固定問題、実データに近い匿名問題、重大違反テストを同条件で実行します。プロンプトや検索設定も同時変更しないことが比較の基本です。
MLflowなどでモデル、データ、評価結果を記録すると、品質低下の原因を追跡しやすくなります。業務KPIでは、問い合わせ解決率、再質問率、有人転送率を評価スコアと並べ、相関を見ながら基準を調整します。
| 段階 | 実施内容 | 判定の要点 |
|---|---|---|
| 固定評価 | Golden Setを実行 | 重大違反の有無 |
| 差分確認 | 旧版と比較 | 品質低下の有無 |
| 人手確認 | 高リスク例を精査 | 根拠と安全性 |
| 段階公開 | KPIを監視 | 停止条件の発動 |
- 変更ごとに固定セットで回帰確認する
- 品質・遅延・費用を同時に記録する
- スコアと業務KPIの関係を検証する
まとめ
LLMの品質を高める鍵は、単一のベンチマークや総合点ではありません。業務目的から正確性、根拠性、関連性、安全性を定義し、RAGやエージェントの各工程を測り、人間の判断で評価系を校正することが重要です。
要点
- モデル能力と業務アプリの品質を分けて測定する。
- Faithfulness、Answer Relevancy、Context Recall、Context PrecisionでRAGの原因を切り分ける。
- 重大な安全違反は平均点で相殺せず、公開停止条件として管理する。
- 固定Golden Setと監査ログにより、変更時の回帰を検知する。
- 評価スコアを解決率や再質問率などの業務KPIと結び付ける。
まずは対象業務を1つ選び、失敗すると困る回答を20件程度書き出してください。各回答に合格条件、重大違反、根拠資料を付ければ、ツール選定やモデル比較に先立つ、実用的な評価の土台を作れます。
よくある質問
Q1. LLM評価はいつ始めるべきですか?
PoCの段階から始めるべきです。少なくとも公開前には、代表的な正常ケース、失敗しやすい境界ケース、重大リスクのケースを含む固定問題を用意します。
Q2. 自動評価だけで品質を判定できますか?
できません。自動評価は高速な継続監視に有効ですが、採点器の偏りや曖昧な業務判断を補うため、専門家によるGolden Set確認と高リスク回答の人手評価を併用します。
Q3. RAGで最も優先すべき評価項目は何ですか?
根拠資料に忠実かを示すFaithfulnessと、必要な資料を取得できたかを見るContext Recallを優先します。そのうえで質問への適合性と、検索結果のノイズを確認します。
Q4. 評価結果が改善しても本番の成果が上がらない理由は?
テスト問題が実利用とずれている、または評価指標が解決率・再質問率などの業務指標と結び付いていない可能性があります。実際の匿名化事例を追加し、KPIとの関係を検証してください。
Q5. 日本語の評価データで注意すべき点は?
敬語、主語省略、表記揺れ、略称、固有名詞、文化的に不自然な表現を含めます。同じ意味でも複数の自然な回答があるため、完全一致だけに依存しない採点設計が必要です。
参考文献・出典
* [会社概要](https://a-x.inc/about/) * [メンバー](https://a-x.inc/member/) * [サービス](https://a-x.inc/service/) + [AXCAMP サービスページ](https://a-x.inc/service/ax_camp/) +…
a-x.inc
[Artificial Intelligence](https://www.ibm.com/jp-ja/think/artificial-intelligence) [Business operations](https://www.ibm.com/jp-ja/think/business-operations)…
www.ibm.com
[メインコンテンツへスキップ](#main-content) # LLMアプリケーションの性能評価手法「LLM as a Judge」とは? [![電通デジタル|Tech…
note.com