2026.10.31
AI説明責任を実装する企業の実践設計
IT関連
AI説明責任とは、AIが出した結果だけでなく、その利用目的、判断過程、責任者、問題発生後の救済を組織が説明し、改善する責務です。精度が高いだけのAIは、顧客や従業員に影響する場面で十分とはいえません。
生成AIやAIエージェントは、要約、推薦、審査、問い合わせ対応まで判断の範囲を広げています。そのため、開発会社、導入企業、現場利用者の誰が何を確認し、いつ停止できるのかを事前に定める必要があります。
本記事では、AI説明可能性との違いから、AIガバナンスの体制、AI公平性の測定、AI監査対応の証跡、AI倫理研修までを一つの運用サイクルとして整理します。すぐに社内文書へ転記できる観点も紹介します。
AI説明責任とは何かを業務責任に変換する
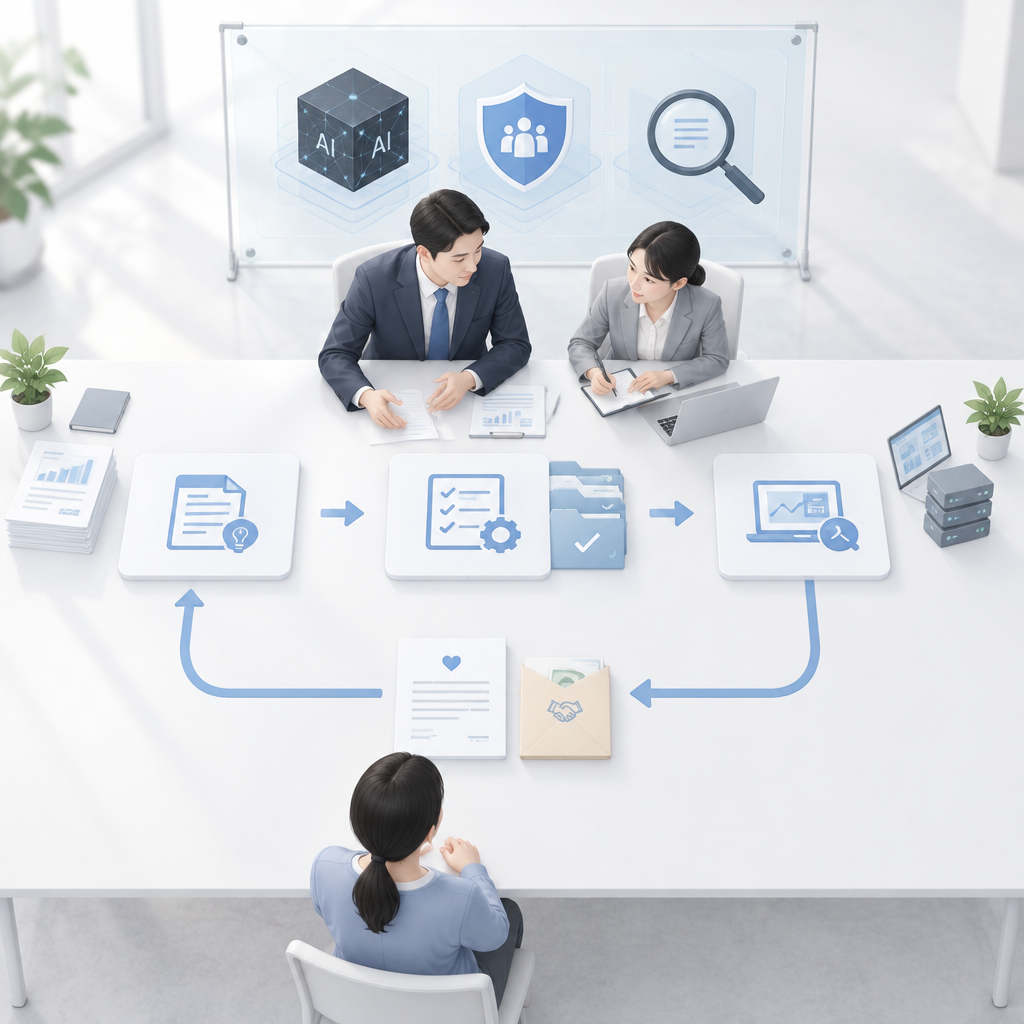
説明責任は結果の説明だけではない
AI説明責任の要点は、判断理由を語ることではなく、意思決定による影響を引き受けることです。大辞林第三版の「業務内容について、対外的に説明をする責任」という考え方を、AIの企画から救済までへ広げて捉えます。
AI説明可能性は、モデルがなぜその出力を返したかを理解できる性質です。一方で説明責任は、説明を受ける相手、承認者、訂正方法、補償や再発防止までを含む組織上の約束です。
透明性は情報を見せること、AI公平性は不当な格差を抑えることに重心があります。これらを個別の施策で終わらせず、説明・判断・是正をつなぐ仕組みにすることが、信頼できる利用につながります。
- 利用目的と対象者を明示する
- 最終判断者と停止権限を定める
- 異議申立てと訂正窓口を用意する
責任はライフサイクル全体で管理する
AI説明責任は、導入前、設計・検証、運用監視という3つのステージで管理します。導入前に用途と許容リスクを審査し、設計時にデータと評価基準を記録し、運用中に性能変化と苦情を監視します。
責任には、適切に設計・運用する責任と、影響を受けた人へ説明・救済する責任という2つの責任があります。前者だけでは内部品質管理に留まり、後者だけでは原因のない謝罪になりかねません。
NIST AI RMF (2023) の統治、把握、測定、管理という考え方は、部門間の会話をそろえる基盤になります。日本の個人情報保護や業法の確認も、企画時点のリスク判定へ組み込むと手戻りを減らせます。
- 企画時に影響を受ける人を洗い出す
- 変更時は再評価と再承認を行う
- 廃止時にも保存・削除の責任を確認する
高影響領域では人が最終責任を持つ
採用、融資、医療のように権利や機会へ大きく影響する用途では、AIの出力を自動確定にしないことが原則です。人によるレビューは単なる押印ではなく、根拠の確認と例外判断を担う設計にします。
たとえば与信モデルでは、閾値を超えない申請を一律に拒否するのではなく、追加資料や誤データ訂正の導線を設けます。担当者が覆した判断も記録すれば、モデルの弱点を継続的に発見できます。
EU AI Act (2024) のArticle 12は、高リスクAIにおける記録保持を重視します。制度の適用範囲にかかわらず、判断ログと人の介入履歴を残すことは、顧客対応とAI監査対応の共通基盤になります。
- 自動実行できる範囲を限定する
- 例外処理の責任者を指定する
- 利用者への通知文を事前承認する
AIガバナンスで責任境界と承認経路を整える
責任者を一人に押し付けない
AIガバナンスでは、AI責任者だけに全責任を集中させず、事業、法務、情報セキュリティ、データ、現場で責任を分けます。経営層は許容リスクと予算を決め、現場は目的外利用や異常を報告する役割を持ちます。
実務では、AI 開発者(AI Developer)、AI 提供者(AI Provider)、AI 利用者(AI Business User)の3つの立場を契約と運用で切り分けます。特に外部APIやSaaSを使う場合、障害通知とログ提供の義務を確認します。
RACIで「実行者」「最終承認者」「相談先」「報告先」を用途ごとに1人ずつ明記します。AI責任者はこの一覧の管理者となり、未決定の責任境界を経営会議へエスカレーションすることが重要です。
- 用途オーナーを事業部に置く
- 高リスク案件は委員会で承認する
- ベンダーの再委託先も把握する
台帳とリスク分類を導入の入口にする
AIガバナンスの出発点は、利用中のAIを見える化する台帳です。モデル名、用途、入力データ、利用者、提供者、最終承認者、更新日、停止方法を登録し、無許可のシャドーAIを減らします。
次に、個人への影響、機密性、安全性、自律性、外部公開の有無でAIリスク評価を行います。EU AI Actは4 つのリスクレベルを示しており、用途に応じて審査の深さを変える考え方として参考になります。
国内の実務資料としてAIガバナンスナビver2.0を参照しつつ、自社の業務フローに合わせることが大切です。調達、開発、提供、利用、変更、廃止の各段階に承認ゲートを置くと、規程が現場で機能します。
- 台帳は利用開始前の登録を原則にする
- 高リスク用途は法務・倫理レビューを追加する
- モデル更新を新規変更として扱う
生成AIとエージェントの権限を絞る
AIエージェントは、検索、要約、メール送信、外部システム操作を連続して実行できます。便利さの裏側で、ハルシネーションやプロンプトインジェクションが誤操作へ直結するため、権限を最小化する設計が不可欠です。
OWASP LLM Top 10(2025年版)を参照し、入力の信頼性、機密情報の出力、ツール実行、認可の抜け道をテストします。読み取り専用から始め、高額決済や人事変更などは人の明示承認を必須にします。
過去20年間に設計されたIDモデルをそのままAIエージェントへ当てはめるのではなく、短時間の認可、操作単位のログ、委任範囲の上限を設定します。1時間に数千もの判断が走る環境ほど、自動停止条件を先に決めます。
- サービスアカウントを個人IDと分離する
- 高リスク操作は二段階承認にする
- 異常な連続実行を遮断する
AI公平性を測り、AIバイアス対策を意思決定にする
公平性は一つの指標では決まらない
AI公平性は、属性の違いによって不当な不利益を生まないよう、設計と結果の両方を点検することです。グループ間の採用率だけでなく、個人が類似条件で同様に扱われるか、手続きが公正かも確認します。
統計的パリティ、機会均等、等オッズは、それぞれ異なる不公平を検知します。しかし、全指標を同時に最大化できない場合があります。どの指標を優先するかは、事業部だけでなく法務とAI責任者が承認すべき判断です。
単一の性別や年齢層だけで結論を出さず、年齢×地域、言語×障害など小規模な交差属性も確認します。サンプルが少ない集団は数値のぶれが大きいため、定量評価に利用者ヒアリングを組み合わせます。
- 評価対象の属性を目的に照らして選ぶ
- 少数集団の誤差を別途確認する
- 採用指標の根拠を議事録に残す
バイアスはデータから運用までに入り込む
AIバイアス対策は、学習データの偏りだけを直す作業ではありません。収集範囲、欠損処理、ラベル付け、特徴量、閾値、人による介入、利用場面の変化まで、偏りが入る地点を順に確認します。
ある調査では、AIの活用率が2020年の4.2%から2021年の20.5%へ変化したとされます。導入が急速に広がるほど、過去の人事・営業データを無批判に学習させず、利用目的との適合性を再検討する必要があります。
対策は、再サンプリングや重み付けなどの前処理、制約付き学習、判定後の補正に分けられます。LIMEやSHAPは説明の補助になりますが、相関関係を因果関係として断定しないよう専門家が解釈します。
- データの収集目的と利用目的を照合する
- 代理変数による差別を検査する
- モデル外の業務フローも見直す
閾値は事業目的と救済手段と一緒に決める
公平性の監視は、合格率だけでなく、誤って不利益な判定をした割合と訂正のしやすさで行います。たとえば40%や25%といった差分を発見しても、直ちに可否を決めず、母数、影響度、原因を確認します。
社内基準として60%以上、50%以上のような数値を用いる場合も、その値だけを独り歩きさせてはいけません。対象業務、比較群、測定期間、許容理由、未達時の対応をモデルカードと承認記録へ記載します。
公平性の改善は信頼のための投資です。適切な権限設計と教育を伴えば、毎年20%成長を目指せる組織基盤は現実的に作れます。数値目標を掲げるほど、現場が異議を上げられる安全な文化が重要です。
- 基準未達時の停止・改善基準を定める
- 月次または四半期ごとに再測定する
- 救済件数も経営指標に含める
AI説明可能性と文書化で監査に耐える証跡を残す
モデルカードは判断の取扱説明書になる
AIモデルカードは、モデルの目的、対象外用途、学習データの概要、性能、既知の限界、評価条件、責任者をまとめる文書です。AI説明可能性の技術資料だけで終えず、利用者が安全な範囲を判断できる内容にします。
高影響な案件では、データの取得元、同意や利用根拠、前処理、ラベル品質、保管期間も追記します。モデルの精度が高くても、適用対象が異なれば性能や公平性は崩れるため、再利用条件を明確にします。
モデル更新時には、変更理由、比較結果、承認者、ロールバック手順を追記します。最終更新日 2025-07-27 UTC。のように更新時点を固定した記録は、いつ誰が何を知っていたかを後から確認する助けになります。
- 目的外利用を明確に禁止する
- 評価データと本番データを区別する
- 更新履歴を削除せず追記する
ログは再現可能な粒度で保管する
AI監査対応では、入力、出力、モデル版、プロンプト、外部ツール呼び出し、人の介入、最終処理を時系列で結べることが重要です。個人情報や営業秘密を含むログは、アクセス権と保存期間も同時に設計します。
たとえば記録に “model_id”: “v2.1.0-stable”、”calibration_window”: “2025-12-01T00:00Z”、”hash”: “sha256:e3b0c442…” を残せば、検証対象の版と設定を特定しやすくなります。
与信のようなルール併用型では、”thresholds”: {“credit_score”: 650, “p_default”: 0.05} を保存し、再検証で “verify_result”: “PASSED” を確認します。ただし、記録の完全性は検証結果だけでなく、改ざん防止と閲覧統制で担保します。
| 項目 | 記録例 | 確認目的 |
|---|---|---|
| モデル版 | v2.1.0-stable | 再現性 |
| 評価設定 | calibration_window | 検証条件 |
| 判定閾値 | credit_score 650 | 判断根拠 |
| 完全性確認 | sha256 ハッシュ | 改ざん検知 |
- ログの時刻基準を統一する
- 証跡へのアクセスを職務で制御する
- 監査用データの抽出手順を文書化する
説明は相手に合わせて設計する
顧客、監査人、現場担当者、経営層では必要な説明が異なります。顧客には結論、主要理由、訂正方法を簡潔に示し、監査人には再現可能なログと評価記録を提示するなど、開示の層を分けます。
説明文は、AIが決めたという表現で責任をぼかさないことが大切です。「この判定は、申請情報と定めた基準を用いて算出され、担当者が確認した」と書けば、判断主体と見直し経路を伝えられます。
異議申立てを受けたら、データ誤り、モデル不具合、運用逸脱を切り分けます。個別案件を訂正するだけでなく、同様の影響がないかを調査し、モデルカード、FAQ、手順書を更新して再発防止へつなげます。
- 専門用語を顧客向けに言い換える
- 判断理由と訂正窓口を近接配置する
- 重大事案は経営層へ即時報告する
AIリスク評価と教育を継続運用に組み込む
リスク評価は導入前だけで終わらせない
AIリスク評価は、導入可否を決める審査であると同時に、運用中の監視計画です。影響範囲、誤作動の重大性、検知可能性、データ感度、外部委託、説明困難性を評価し、リスクに応じた統制を選びます。
生成AIでは、著作権、機密情報、虚偽回答、目的逸脱、サプライチェーンが主要な検討点です。モデルの変更や新機能の追加、接続先の拡大は、同じ名称のサービスでもリスクを変えるため再評価が必要です。
監視指標には性能低下、属性別の格差、拒否・差戻し率、苦情、手動介入、権限逸脱を含めます。閾値超過時の停止担当者と顧客連絡の責任者を決めておけば、障害時にも判断が遅れません。
- リスクと対策の対応関係を台帳化する
- 変更管理に再評価を組み込む
- インシデント演習を定期実施する
AI倫理研修は役割別に実施する
AI倫理研修は、抽象的な理念の周知ではなく、職務ごとの判断力を養う訓練です。経営層は受容可能なリスクと説明責任を、開発者はデータ・評価・ログを、現場は利用制限と異常報告を学ぶ構成にします。
研修では、採用候補者を不当に絞り込むケース、顧客情報を外部AIへ入力するケース、エージェントが誤送信するケースを扱います。受講者が「止める」「相談する」「記録する」のどれを選ぶかを演習で確認します。
研修受講率だけでなく、理解度テスト、相談件数、ヒヤリハット報告、是正の完了率を見ます。AI責任者が結果を委員会へ報告し、規程やプロンプト集を更新すると、教育が現場改善へつながります。
- 経営・開発・利用部門で教材を分ける
- 実案件に近い演習を入れる
- 相談窓口を研修内で周知する
小さく始めて監査可能な運用へ育てる
最初の一歩は、全社規程を完璧に作ることではなく、影響の小さい業務で台帳、モデルカード、ログ、承認を一巡させることです。その経験から不足する項目を洗い出し、高影響用途へ段階的に広げます。
ALION株式会社のように専属チームでシステム開発を支援するパートナーと進める場合も、責任の委任ではなく共同管理が原則です。要件定義時からデータの扱い、テスト観点、障害連絡、成果物の引継ぎを合意します。
最終的な目標は、AIを止めるための統制ではなく、安心して使い続けるための統制です。AI説明責任を日常の開発・業務プロセスに組み込み、利用者の声と監査結果で更新する組織を目指しましょう。
- 低リスク用途で運用テンプレートを試す
- 委託先との責任分界を契約に明記する
- 四半期ごとに統制の有効性を見直す
まとめ
AI説明責任は、説明資料を1枚作って終える施策ではありません。AIガバナンスで責任境界を定め、AI公平性を測定し、AI説明可能性と証跡で根拠を示し、AIリスク評価とAI倫理研修で運用を改善する循環です。
要点
- 説明可能性・透明性・公平性を、救済を含む責任管理へ統合する。
- AI責任者、現場、法務、開発・提供事業者の役割をRACIで明文化する。
- モデルカード、変更履歴、判断ログをAI監査対応の共通資産にする。
- 公平性の指標選定とトレードオフは、承認記録として残す。
- 教育、監視、異議申立てを通じて運用を継続改善する。
まずは、現在利用しているAIを台帳に並べ、用途オーナーと最終承認者が空欄のものを特定してください。その上で高影響な1件を選び、リスク評価、モデルカード、ログ、異議申立ての4点を整えることから始めましょう。
よくある質問
Q1. AI説明責任とAI説明可能性の違いは何ですか?
AI説明可能性はAIの出力理由を理解できる性質です。AI説明責任は、それに加えて責任者、利用目的、監査記録、異議申立て、是正までを組織として担うことです。
Q2. AI責任者は誰が担うべきですか?
全社横断の統制担当をAI責任者として置きつつ、用途ごとの最終責任は事業部のオーナーが担う形が実務的です。法務、セキュリティ、データ、開発部門とRACIで分担してください。
Q3. AI監査対応で最初に整えるべき文書は何ですか?
AI台帳、AIリスク評価票、AIモデルカード、変更履歴、判断ログの順に整えると効果的です。高影響な用途から始め、保存期間と閲覧権限も同時に決めます。
Q4. AI公平性はどの頻度で評価すべきですか?
モデル更新、データ分布の変化、苦情の発生時には必ず再評価します。安定運用中でも月次または四半期ごとに主要指標を監視し、少数集団の影響を確認することが望ましいです。
Q5. AI倫理研修は開発者だけに必要ですか?
いいえ。経営層、開発者、現場利用者で必要な知識が異なります。特に現場には、入力禁止情報、出力の検証方法、異常時の報告先、利用停止の基準を具体的に教育します。
参考文献・出典
[](/jp/top.html “東芝トップページ”)…
www.global.toshiba
[メインコンテンツへジャンプ](#main) [Data + AIの基盤](/jp/blog/category/data-ai-foundations) # AIガバナンスとは何ですか? 組織全体で AI…
www.databricks.com
 # AI公平性とは ## AI公平性とは、AIシステムが特定の個人やグループに対して、不当な差別や偏見を生じさせないようにするための概念である…
umarketing.co.jp