2026.10.29
RAG再ランキングで回答精度を高める実践設計
IT関連
RAG再ランキングは、初回検索で集めた候補を質問との関連性で並べ直し、LLMへ渡す根拠を絞る仕組みです。検索結果はあるのに回答がずれる問題に、直接効く改善策となります。
RAGは外部知識を参照して回答を生成できますが、候補文書の順位が悪ければ、性能の高いLLMでも誤った文脈を採用します。重要なのはモデル交換ではなく、検索から生成までの接続を設計することです。
本記事ではRAG構築の基本から、ベクトル検索RAG、RAGチャンク設計、再ランキング方式、RAG評価指標、RAG引用表示までを解説します。検証用データを用意し、再現性あるRAG精度改善へ進めましょう。
RAG再ランキングが必要になる理由
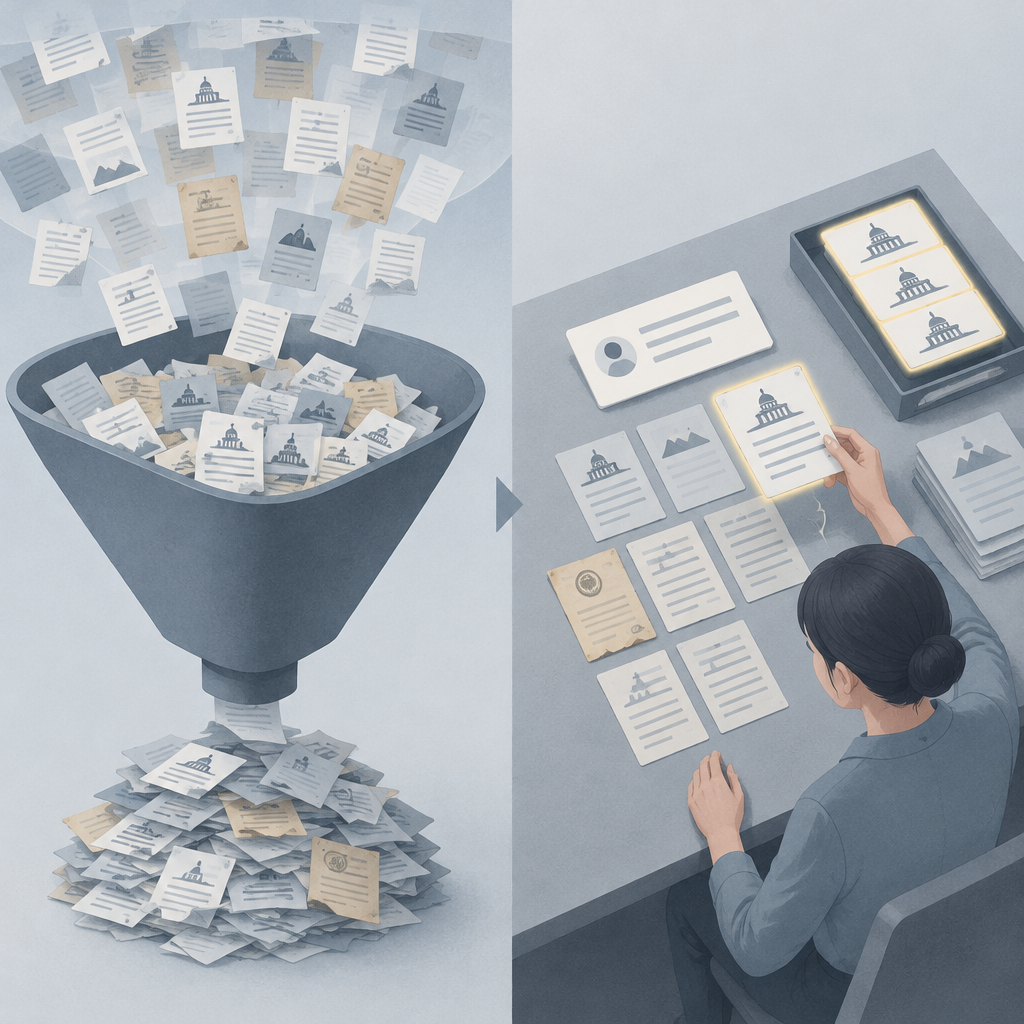
再ランキングは候補の優先順位を正す工程です
結論として、RAG再ランキングは一次検索を置き換えるものではなく、候補集合の精度を上げる第二段階です。質問と各チャンクを対で読み、生成に使う文書を適切な順番へ並べ替えます。
実務では一次検索でtop_k=30〜100件を取得し、rerankerで再採点し、top_n=3〜10件だけをLLMへ渡します。この分離により、大規模検索の速度と、質問単位の判断精度を両立できます。
たとえば社内規程の質問では、語句が似た旧版より、条件・例外・施行範囲が合う条文を上位に置く必要があります。再ランキングは、この局所的な文脈適合を評価するための工程です。
- 一次検索は候補漏れを抑える役割
- 再ランキングは候補順位を正す役割
- 生成モデルには少数かつ高品質な根拠を渡す
ベクトル類似度だけでは質問意図を取り切れません
ベクトル検索は意味が近い文書を高速に探せますが、否定、数値条件、対象部署、更新日といった制約を十分に区別できない場合があります。近い話題であることと、質問への正答根拠であることは別です。
ANNによる近似最近傍検索は、速度のために完全探索を省略します。そのため、ベクトル検索RAGでは候補を広めに回収し、後段で精密に判定する二段構えが、品質とレイテンシーの現実的な折衷になります。
検索品質を考える際は、search recall@k を 70% 程度まで落としても RAG の性能にはあまり影響しないという知見もあります。単純な候補数競争ではなく、最終文脈の質を検証する姿勢が重要です。
- 類似性と正答根拠は一致しない
- ANNは高速だが近似検索である
- 最終投入文脈で品質を判定する
まずは小さな候補数で効果を測ります
PoCでは、まずtop_k=50、top_n=5程度から始めると、検索漏れ、順位誤り、生成の誤読を切り分けやすくなります。候補を無制限に増やす前に、失敗した質問に対して順位がどう変わるかを確認します。
実装イメージは initial_results = vector_db.similarity_search(query, k=50) の後、再採点した候補から top_k_docs = reranked_docs[:10] を作る流れです。最終件数は回答の種類やコンテキスト長に合わせて調整します。
2026-06-09 04:30時点の運用記録として、Daily Active Usersが0.47%向上した例もあります。ただし利用率だけを成功指標にせず、根拠の正しさと回答不能時の挙動を同時に確認すべきです。
- 開始値はtop_k=50、top_n=5程度
- 失敗質問ごとに順位変化を観察する
- 利用率と正確性を別々に追跡する
RAG構築では検索と生成の責務を分ける
RAG構築は知識を更新可能な回答基盤にします
結論として、RAG構築はLLM自体に知識を覚え込ませる方法ではなく、外部文書を検索して回答根拠にする方法です。規程、FAQ、製品資料のように更新が必要な情報で、特に効果を発揮します。
一般的には200〜500トークン程度が目安です。ただし、見出し、表題、対象製品、改定日などのメタデータを失うと、検索後に正しい解釈ができません。分割と同時に文書の構造を保存します。
回答精度だけを導入目的にせず、誰のどの問い合わせを短縮するかを定義してください。RAG構築の価値は、回答を自動化することではなく、確認可能な知識アクセスを業務へ組み込むことにあります。
- 外部知識を検索して回答する
- 更新頻度が高い情報に適する
- 業務上の問いを先に定義する
ハイブリッド検索で候補漏れを抑えます
回答は、ベクトル検索だけに依存しない設計が有効です。製品型番、条文番号、部署固有の略称はBM25が拾いやすく、言い換えや概念的な質問は埋め込み検索が得意という違いがあります。
実践的にはBM25 top20とベクトルtop30をマージし、重複を除いて再ランキングへ渡します。RRFのような融合方法を用いれば、片方の検索器が見逃した候補を補えるため、後段の判定材料を増やせます。
ベクトル検索RAGでは、Vector DB側で候補を20〜100件程度に絞る構成が扱いやすい選択です。候補20〜100件を上位3〜10件へ絞ることで、LLMに不要な文脈を読ませる負担を減らせます。
- 固有語はBM25、言い換えはベクトル検索が得意
- 融合後の候補を再ランキングへ渡す
- LLM投入前に文脈を絞り込む
基盤選定はデータ規模と運用条件で決めます
ベクトルDBはPinecone、Weaviate、pgvectorなどから選べますが、名称だけで決めるべきではありません。更新頻度、アクセス制御、既存DBとの接続、障害時の復旧、検索フィルタの要件を先に整理します。
Amazon Bedrock(Claude Sonnet 4.5)を生成層に使う場合でも、検索器、再ランキング器、引用表示は独立して評価できます。基盤を疎結合にしておくと、LLMやEmbeddingモデルの変更が検索品質へ与える影響を追跡しやすくなります。
2026-05-21、v3.1のようにコンポーネント更新を記録し、評価結果と結び付けてください。ベクトル検索RAGの改善は、一度のモデル選定ではなく、変更履歴を残す継続運用によって安定します。
- 選定基準は運用要件から作る
- 生成層と検索層を疎結合にする
- バージョンと評価結果を記録する
RAGチャンク設計で根拠の粒度を整える
チャンクは小さすぎても大きすぎても失敗します
結論として、RAGチャンク設計では、質問に答えるための意味が一つに閉じる最小単位を作ります。短すぎれば条件や例外が分断され、長すぎれば無関係な文章まで検索・生成に混ざります。
目安として300〜800文字程度を起点にします。FAQのような短い文書は小さめ(200〜400文字)、技術文書のような長い文書は大きめ(500〜1000文字)とし、単なる固定文字数ではなく文書の役割で決めます。
たとえば「製品Aの保証期間は2年間です」という一文は、対象製品、期間、適用条件を同じチャンクに含めます。質問に対する答えだけでなく、答えを限定する条件を残すことが重要です。
- 意味が完結する範囲で分割する
- 文書種別ごとに粒度を変える
- 条件と例外を答えと分離しない
見出しとメタデータを検索可能にします
チャンク本文だけでなく、文書名、見出し階層、改定日、部署、権限、URLをメタデータとして持たせるべきです。これにより再ランキング時にも、質問者が参照可能な最新文書を優先できます。
オーバーラップ(10〜20%)は、段落境界で意味が切れる問題を和らげます。しかし重複を増やしすぎると、似た候補ばかりが上位を占めます。オーバーラップは検索結果の多様性を見ながら調整します。
RAGチャンク設計の評価では、回答がない質問も確認してください。該当箇所がないのに近い文書を返す状態は、チャンクサイズの問題だけでなく、検索閾値や回答抑制ルールの不足を示します。
- 見出し・改定日・権限を保存する
- オーバーラップは10〜20%から試す
- 回答不能ケースも必ず試験する
再ランキング向けには文脈を補って保存します
再ランキング器が精度よく比較できるよう、チャンクには親見出しや文書タイトルを前置して保存します。本文だけでは「対象外」「例外」の対象が不明でも、階層情報があれば質問との対応を判断できます。
約2,000文字のチャンク、96件を4秒弱で処理した例もありますが、速度だけでサイズを決めてはいけません。回答に必要な根拠が一塊にあるか、評価クエリで確認して初めて妥当性を判断できます。
既存資料をそのまま分割する前に、重複版、失効文書、画像化された表、権限外資料を整理します。検索器を高度化しても、知識ベース自体が曖昧ならRAG精度改善にはつながりません。
- 親見出しをチャンクへ引き継ぐ
- 処理速度と回答可能性を両方測る
- 登録前に文書品質を整える
再ランキング方式を用途別に選ぶ
Cross-encoderは精度と速度のバランスがよい方式です
結論として、多くの業務RAGではCross-encoderから試すのが堅実です。質問と候補文書を同時に入力して関連度を算出するため、別々に埋め込むbi-encoderより、語順や条件の対応を精密に評価できます。
代表例の cross-encoder/ms-marco-MiniLM-L-6-v2 は、候補数を絞った再採点に適します。batch_size=16のようにバッチ処理を使い、候補数と応答時間の関係を測ることで、実サービスに合う設定を探せます。
ただしCross-encoderは候補ごとに推論するため、全件検索には向きません。bi-encoderで大規模なデータから候補を絞り込む(例:上位100件)後に、上位10件を選ぶ構成が役割分担として合理的です。
- 質問と候補を対で評価できる
- 全件検索ではなく候補再採点に使う
- バッチ処理でレイテンシーを管理する
API型とLLM型は説明力とコストを比較します
API型の再ランキングは実装を早く始めやすく、運用負担を抑えられます。たとえば Cohere `rerank-english-v3.0`モデルは、model=”rerank-english-v3.0″として候補の順位付けに利用する選択肢です。
LLM型は、規程の例外や複数条件など、関連性の理由を言語的に評価できる点が強みです。model=”gpt-4o”のようなモデルに採点基準を与える設計では、出力形式を固定し、推論文ではなくスコアと根拠種別を取得します。
Vertex AI `semantic-ranker-512`モデルも候補です。方式を選ぶ際は、精度、レイテンシー、データ送信範囲、単価、リージョン要件を同じ評価セットで比較し、用途ごとに使い分けます。
| 項目 | Cross-encoder | API型 | LLM型 |
|---|---|---|---|
| 得意な判断 | 質問と文書の適合 | 高速な再採点 | 複数条件の解釈 |
| 主な負荷 | 推論計算 | 外部API依存 | 応答時間とコスト |
| 向く場面 | 定型的な社内検索 | 短期間の検証 | 複雑な規程照会 |
- API型は導入速度を確保しやすい
- LLM型は複雑な条件評価に向く
- 同一データで精度と運用条件を比べる
Learning-to-Rankは十分な教師データがある場合に有効です
結論として、Learning-to-Rankはクリック、採用回答、専門家ラベルなど、信頼できる行動データが蓄積している場合に検討します。データが少ない初期段階で複雑な学習器を導入すると、評価が不安定になりがちです。
最低でも50〜100件の評価クエリを用意し、誤答が多いクエリ群を10〜20本選びます。正解文書だけでなく、もっともらしい誤候補を含めることで、再ランキング器が本当に順位誤りを直したかを確認できます。
FAQなら20〜50件、社内文書検索なら50〜100件から始める方法が現実的です。教師データを増やす際は、同一質問の言い換えだけでなく、否定、比較、例外、最新性の確認を含めます。
- 信頼できるラベルがあれば学習型を検討する
- 誤答が多い質問を重点的に診断する
- 言い換え以外の難問も収集する
RAG評価指標とRAG引用表示で品質を運用する
評価は正答率だけでは不十分です
結論として、RAG評価指標は検索、文脈、生成の三層に分けます。最終回答が正しく見えても、偶然の知識で答えたのか、正しい根拠を検索したのかを分けなければ、改善箇所を特定できません。
検索層ではRecall@kやNDCG@10、文脈層ではContext Relevance、生成層では忠実性や回答妥当性を確認します。NDCG@10で0.02ポイント差のような小差でも、失敗クエリの内容を見なければ実務影響は判断できません。
LLM評価には、専門家レビューと自動評価を組み合わせます。RagasやAspect Criticを補助に使えますが、自動採点だけで重要な規程回答の合否を決めず、根拠と回答の対応を人が確認します。
- 検索・文脈・生成を分けて測る
- 小さなスコア差は失敗例で解釈する
- 自動評価と専門家確認を併用する
AI評価データセットは実際の質問から作ります
AI評価データセットは、想定質問だけでなく、現場で起きた問い合わせ、検索失敗、回答保留を基に作るべきです。実利用の表記ゆれや省略語が入るため、机上のきれいな質問だけより運用品質を測れます。
各クエリには、期待する根拠チャンク、許容される回答、回答すべきでない条件、重要度を記録します。これによりRAG精度改善の施策を、感想ではなく同じ試験問題に対する前後比較で判断できます。
評価セットは固定化しすぎず、文書更新や業務変更に合わせて追加します。2024-11-25のような文書日付を含む質問では、古い版を引用しないかを確認項目にし、鮮度に関する失敗を可視化します。
- 実問い合わせを評価セットへ反映する
- 根拠・許容回答・不回答条件を記録する
- 更新情報を含む問題を継続追加する
引用表示は回答を検証可能にする機能です
結論として、RAG引用表示は単なるリンク集ではありません。回答文の各主張に対し、どの文書のどの箇所を根拠にしたかを示し、利用者が短時間で確認できるようにする機能です。
表示には文書タイトル、見出し、改定日、該当スニペット、社内URLを含めます。引用先を開けない権限の利用者には、情報を推測して示さず、アクセス申請先または回答保留を案内する設計が必要です。
ベクトル検索RAGの導入事例では、最低20%の工数削減が目標として示されます。しかし削減値だけを追うのではなく、RAG引用表示によって検証時間が短くなったかも測定し、信頼できる業務利用へつなげます。
- 主張と根拠箇所を対応付ける
- 権限に応じて引用表示を制御する
- 工数削減と検証容易性を両方測る
まとめ
RAG再ランキングは、一次検索の候補を精密に見直し、LLMへ渡す根拠を整えるための重要な工程です。RAG構築、RAGチャンク設計、評価、引用表示を分断せず、失敗クエリを軸に改善を繰り返すことで、回答品質は安定します。
要点
- 一次検索は広く集め、再ランキングで少数の根拠へ絞る
- チャンクには本文だけでなく見出し・更新日・権限を保持する
- RAG評価指標は検索・文脈・生成の三層で確認する
- RAG引用表示で利用者が根拠を検証できるようにする
- AI評価データセットを継続更新し、変更の効果を比較する
まずは代表的な失敗質問を50件集め、top_k=50、top_n=5の条件で現状を測定してください。その結果を基に、検索融合、チャンク粒度、再ランキング方式を一つずつ変えれば、原因を見失わずに改善を進められます。
よくある質問
Q1. RAG再ランキングは必ず必要ですか?
小規模で候補が少ないFAQでは必須ではありません。ただし、類似文書が多い、規程の例外が多い、検索結果は出るのに回答がずれる場合には、優先的に検討すべきです。
Q2. 一次検索と再ランキングの候補数はどう決めますか?
最初はtop_k=50、top_n=5程度で評価し、検索漏れと応答時間を確認します。正答根拠が候補に入らないなら一次検索を、候補にあるのに回答されないなら再ランキングやチャンクを見直します。
Q3. RAG引用表示には何を出すべきですか?
文書タイトル、見出し、改定日、該当スニペット、参照先を基本にします。利用者の権限に応じて表示を制御し、参照できない情報を回答根拠として見せないことも重要です。
Q4. LLM評価だけでRAGの品質を判定できますか?
できません。LLM評価は有用な補助ですが、検索された根拠の正しさ、文書の鮮度、権限、回答不能時の抑制は別途確認が必要です。専門家レビューを含む評価設計にしてください。
Q5. RAG精度改善で最初に見るべき点は何ですか?
失敗した質問で、正答根拠が候補に存在するかを確認します。存在しなければ検索やチャンク、存在するのに下位なら再ランキング、上位なのに誤答ならプロンプトや生成制御が主な改善対象です。
参考文献・出典
[](/) [全国無料講演](/lectures)[お問い合わせ](/contact) [x3d AIX 総合研究所…
x3d.jp
 ## Welcome to Helpfeel Based on your language settings we recommend our English language site.…
www.helpfeel.com
![暇さえあればアルゴリズムいじり](https://cdn.image.st-hatena.com/image/square/a7bffef8a18d7be1fea4db275e900952e6c50123/backend=imagemagick;height=128;version=1;width=128/http…
yoshishinnze.hatenablog.com