2026.10.28
AI SBOMで築く信頼できるAI資産管理
IT関連
AI SBOMは、AIシステムを構成する部品と関係性を機械可読な形で記録する台帳です。生成AIの導入が進むほど、どのモデル、データ、API、OSSが使われているかを即答できる体制が重要になります。
従来のSBOMはソフトウェア依存関係の把握に有効ですが、AIでは学習データ、モデルウェイト、プロンプト、RAGデータ、エージェントまで管理対象が広がります。脆弱性対応だけでなく、再現性、説明責任、契約・知的財産の確認にも使える点が特徴です。
この記事では、AI SBOMの基本要素からAIサプライチェーンの防御、AIレジストリを軸にしたAI成果物管理、AIデータ系譜とAIモデルカード、AIライセンス管理までを順に整理します。小さく始めて継続運用する実践手順も紹介します。
AI SBOMとは何か、何を記録すべきか
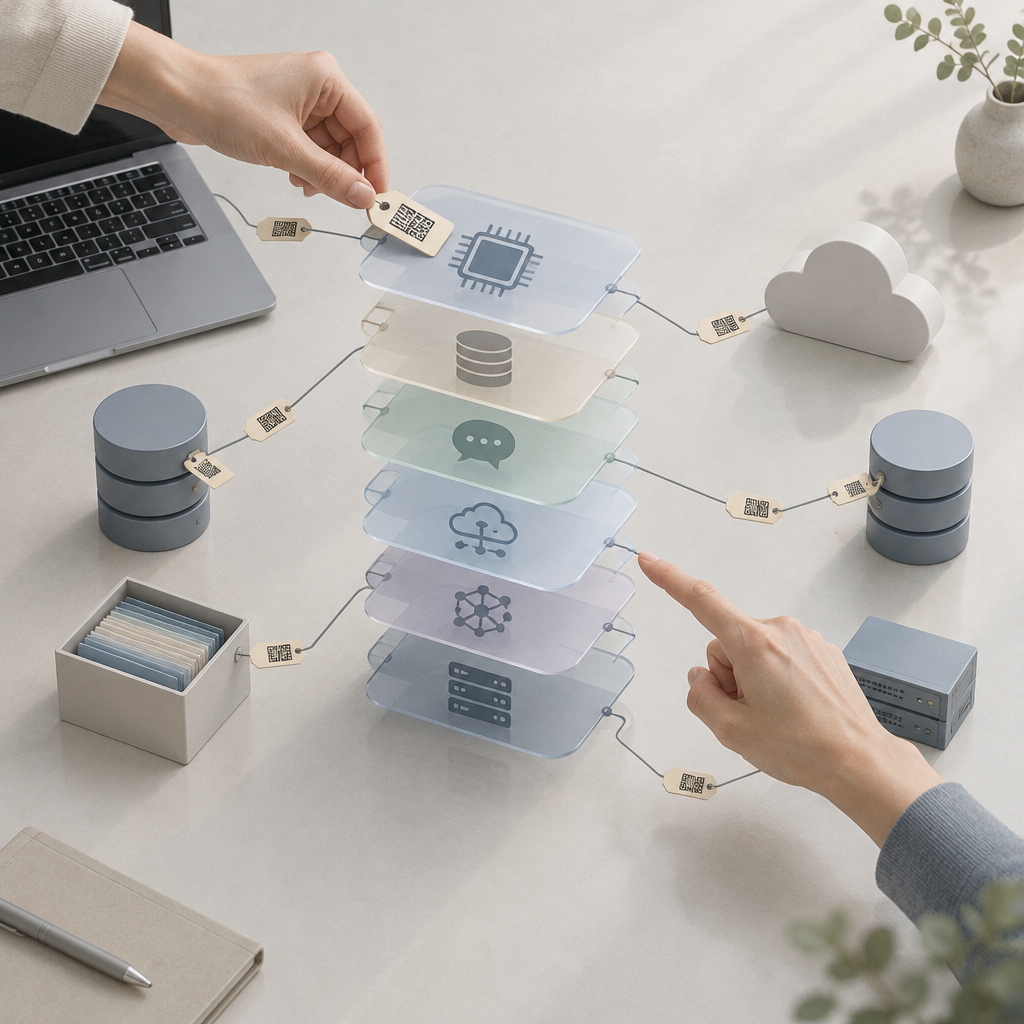
従来のSBOMをAI向けに拡張する理由
AI SBOMは、AIサービスの構成要素・由来・依存関係を追跡するための一覧です。通常のSBOMがライブラリやコンテナを中心に扱うのに対し、AIではモデル、学習・評価データ、モデルウェイト、外部API、プロンプト、推論基盤まで記録対象になります。
例えば、ある回答品質の問題が起きた際、アプリのソースコードだけを調べても原因は判明しません。モデルの更新、RAG検索対象の差し替え、埋め込みモデルの変更、システムプロンプト改訂など、複数層の変更を同じ時系列で確認する必要があります。
SPDX 3.0.1やCycloneDX 1.6 and 1.7では、AI関連の表現を扱う取り組みが進んでいます。特定形式を先に固定するより、後から変換できる識別子、ハッシュ、バージョン、作成者、取得元を欠損なく集めることが導入の第一歩です。
- ソフトウェア、コンテナ、推論APIの依存関係
- モデル名、バージョン、ハッシュ、提供元
- 学習・評価・RAGデータの取得元と利用条件
- プロンプト、エージェント、権限、実行環境
最小構成で押さえるメタデータ
最初に整備すべきなのは、成果物を一意に識別し、変更前後を比較できる情報です。人が読める表示名だけでは同名モデルや再配布物を区別できません。UUID、PURL、CPE、コンテンツハッシュを用途に応じて併記し、登録時刻と承認者も残します。
モデルには、提供元、基盤モデル、ファインチューニング方法、評価指標、デプロイ先を関連付けます。データには収集方法、前処理、利用目的、保存期間、アクセス権限を記載します。これにより、削除要求や用途変更が生じても影響範囲を追跡できます。
AIエージェントを使う場合は、呼び出せるツール、MCP接続先、委任可能な操作、秘密情報へのアクセス範囲も台帳化します。AI SBOMを単なる棚卸しで終わらせず、承認済み構成だけを本番で利用する制御情報として育てることが大切です。
- 一意の識別子と完全性確認用ハッシュ
- 所有部門、責任者、承認状態、更新履歴
- 取得元・契約・利用制限などの根拠情報
- 本番環境、API、ツール権限との紐付け
利用部門ごとに変わるAI SBOMの価値
AI SBOMは、開発、MLOps、セキュリティ、法務、調達が共通の事実を参照するための基盤です。開発者は依存関係を再現でき、MLOps担当者はモデルの昇格履歴を確認できます。セキュリティ担当者は脆弱な部品の利用先を短時間で絞り込めます。
法務・調達部門にとっては、第三者モデルやデータセットの契約条件を導入前に確認できる点が重要です。現場が個別に試用したサービスを放置すると、シャドーAIが増え、利用規約、個人情報、著作権の確認が後追いになります。
ALION株式会社のように専属チームで開発を伴走する体制では、要件定義から運用までの変更記録を共有しやすくなります。AI SBOMを開発完了時の提出物ではなく、設計レビューとリリース判断に使う生きた台帳として扱いましょう。
- 開発:再現可能なビルドと依存関係確認
- セキュリティ:脆弱性通知の影響範囲特定
- 法務・調達:契約条件と利用範囲の照合
- 監査:承認・変更・廃止の証跡保存
AIサプライチェーンを可視化して攻撃面を減らす
守る対象はコードだけではない
AIサプライチェーンの防御では、データ層、モデル層、パッケージ層、ランタイム層、エージェント層を一続きで管理します。OSSの脆弱性に加え、学習データの汚染、モデル改ざん、RAGデータの混入、プロンプトインジェクションが業務判断へ直接影響し得るためです。
OWASPの2025年版Supply ChainやNIST AI 600-1、2024年7月版は、供給元の確認と変更管理の必要性を示しています。NIST AI 600-1の2.9節と2.12節を参照し、学習経路と検索経路を分けて記録すると、汚染源の調査範囲を狭められます。
外部モデルを導入する際は、提供者名だけで信頼せず、取得URL、署名、ハッシュ、取得日時、検証担当者を残します。モデルallowlistと依存パッケージ審査を設け、未登録のモデルやツールを本番パイプラインに投入できない状態にすることが基本です。
- データ、モデル、コード、実行環境を別層で管理
- 署名・ハッシュ照合と許可済み一覧の運用
- 学習経路とRAG検索経路の分離記録
- 最小権限とエージェントのツール利用制限
公開事例の数字を脅威評価に生かす
件数や利用規模の数字は、脅威の深刻さを示す材料であって、自社のリスクをそのまま表すものではありません。2026年3月に約50万件、2026年4月15日には200,000デプロイメント、150M回超、約7,000台という規模を示す報告があり、広範な配布物の追跡が難しいことを示唆します。
また、少なくとも14件のCVE、CVE-2026-42271、2バージョンといった識別情報が公表される場面では、製品名だけでなく使用バージョンを即座に照合できるかが問われます。CycloneDX v1.5などの形式に変換可能な台帳を用意すると、通知への初動が速くなります。
2025年のUSENIX Securityでは16種類、19.7%という測定値も示されています。ただし、検証条件や対象環境が異なる数値を単純比較してはいけません。自社では重要モデル、重要データ、外部接続の3軸で優先度を付け、検知から隔離までの訓練を繰り返します。
- CVEと対象バージョンを成果物IDに結び付ける
- 外部報告の規模値は自社の優先順位付けに利用
- 検証条件が異なる指標の単純比較を避ける
- 通知、影響判定、隔離、復旧を演習する
インシデント時に影響範囲を即答する
AIサプライチェーンでの事故対応は、「何が危険か」より先に「どこで使われているか」を答えることから始まります。AI SBOMから、対象コンポーネント、依存するモデル、参照するデータセット、本番デプロイ先、所有者を抽出し、止めるべき機能を決定します。
たとえばRAGのデータ汚染なら、問題文書の削除だけでは不十分です。索引作成日時、埋め込みモデル、影響を受けた検索コレクション、回答ログを関連付け、再インデックスの要否を判定します。モデル更新なら、評価結果とロールバック先も同時に確認します。
初動の役割分担と証跡の残し方は、AIインシデントの類型と初動対応を解説した記事も参考になります。AI SBOMは原因調査のためだけでなく、隔離・復旧・再発防止の判断を一貫させる記録として活用できます。
- 対象部品からデプロイ先と責任者を逆引き
- データ削除後の索引・キャッシュも確認
- ロールバック候補と評価結果を事前登録
- 事故記録を次回の審査条件へ反映
AIレジストリでAI成果物管理を継続運用する
レジストリは信頼できる登録簿である
AIレジストリは、モデル、エージェント、データセットなどのAI成果物管理を一元化する登録簿です。単なるファイル置き場ではなく、所有者、目的、承認状態、稼働環境、リスク評価、更新履歴を結び付けます。AI SBOMは構成の記述、レジストリは運用上の正本という役割で連携します。
モデルレジストリは学習済みモデルの登録・承認・配備・監視・廃止を扱い、エージェントレジストリはスキル、接続先、認証情報、稼働状態を扱います。発見のための公開情報と、社内で検証済みであることを示す承認情報は分けて管理するべきです。
何千・何百万というエージェントが存在し得る環境では、表示名だけの管理は破綻します。エージェントID、所有チーム、Agent Card、利用可能なツール、監査ログ、ヘルスチェックを登録し、廃止済みのエージェントが呼び出されないようにします。
- 登録対象ごとの一意なIDと所有者
- 利用目的、許容用途、対象外用途の明記
- 承認済み・停止中・廃止済みの状態管理
- AI SBOMへの参照と監査ログの相互リンク
API性能より先に認証と証跡を整える
レジストリの価値は検索速度だけでなく、誰が何を登録・変更したかを検証できることにあります。公開例では「Handles 350+ RPS on just 1 vCPU — no tuning needed」「~10ms Latency」「<10ms p95」といった性能表示がありますが、企業利用では認可設計を同等以上に重視します。
APIはGET /agents?skill=document-extractionによる検索、POST /agents/registerによる登録のように明確に分離します。登録・承認・本番昇格・無効化を別権限にし、OAuth 2.1 + RBACで最小権限を実装すると、誤登録や不正な置換を抑制できます。
稼働状態の鮮度も重要です。30秒以内のハートビートを目標にする設計は有効ですが、接続断を即座に障害と断定するのは危険です。監視の遅延、保守時間、依存先障害を記録し、運用チームが確認できる監査証跡を残しましょう。
- 検索、登録、承認、配備の権限を分離
- OAuth 2.1 + RBACと変更履歴を実装
- ハートビートと監視遅延を併せて確認
- 性能目標と統制要件を別々に評価
外部サービスの情報は検証して登録する
外部のエージェントやレジストリを利用する際は、掲載情報を信頼の根拠ではなく確認対象として扱います。「Updated:October 10, 2026」「Published: July 2, 2026」「6.4k」のような表示は、情報の鮮度や利用状況を判断する補助材料であり、本人性や安全性の証明そのものではありません。
料金表示も同様です。Proは月額$9.99です。というプランや、15,000 USDT、750 USDT、900 USDT、400 USDTといった取引条件を見ても、導入判断では契約主体、データ保存先、解約後の削除、障害時の責任分界を確認する必要があります。
3つの地域で6か月後を見据えた展開、3つの柱、08-31-2026や2026-08-31の期限といった公開計画は、社内台帳に転記する前に一次情報と照合します。AI成果物管理では、未検証の外部メタデータを承認済み情報と混在させないことが信頼性を守ります。
- 公開プロフィールと本人性の検証を分離
- 価格表示だけでなく契約・保存・削除条件を確認
- 外部メタデータには検証状態を付ける
- 承認済み情報と未検証情報を混在させない
AIデータ系譜とAIモデルカードで説明可能性を高める
AIデータ系譜は入力から出力までの履歴である
AIデータ系譜とは、データがどこから来て、どう加工され、どのモデルや回答に使われたかを追える履歴です。データセット名だけでは不十分で、収集元、取得根拠、前処理、分割方法、ラベル付け、保存場所、削除・更新履歴まで関連付けます。
RAGでは、学習データと検索データを混同しないことが重要です。検索対象の文書は日々更新され、同じモデルでも回答が変化します。文書ID、チャンクID、索引バージョン、埋め込みモデル、検索時刻を残すと、特定回答の根拠を再確認できます。
個人情報や機密情報を含むデータは、系譜に本文を複製するのではなく、分類ラベルとアクセス制御情報を持たせます。データ最小化を保ちながら、利用目的外の流用、保持期限超過、削除要求の未反映を検知できる設計にします。
- 収集元、利用根拠、前処理、保存先を接続
- RAG文書と索引、埋め込み、回答ログを関連付け
- 機密本文ではなく分類・権限・保持期限を記録
- 削除・更新が下流成果物へ及ぼす影響を把握
AIモデルカードで利用条件を伝える
AIモデルカードは、モデルの想定用途、性能、限界、リスクを利用者に伝える説明書です。AI SBOMが部品構成を示すのに対し、AIモデルカードは「何のために、どの条件で使えるか」を示します。両者をリンクさせることで、技術情報と利用上の注意を結び付けられます。
最低限、モデルの目的、対象ユーザー、対象外用途、学習・評価データの概要、評価手順、既知の失敗パターン、監視項目、連絡窓口を記載します。精度だけを掲載しても、データ分布や評価条件が異なれば本番の安全性は判断できません。
生成AIでは、幻覚、偏り、有害出力、プロンプトインジェクション耐性、ツール誤操作なども対象になります。評価結果は合格・不合格だけにせず、閾値、テストセット版、実施日、残余リスク、承認者を残し、更新のたびに見直します。
- 想定用途と対象外用途を明文化
- 評価条件と既知の限界を併記
- 残余リスクと監視方法を利用者に提示
- AI SBOMのモデルIDと相互参照
再現性は変更をつなぐことで確保する
再現性を確保するには、モデル単体ではなく実行時の構成全体を固定・記録します。基盤モデル、追加学習のコード、ハイパーパラメータ、データ版、乱数設定、評価データ、コンテナイメージ、推論設定が揃って初めて、同じ結果に近づけます。
現場では、モデル更新後に回答の傾向が変わり、問い合わせが発生することがあります。このときAIデータ系譜とAIモデルカードがAI SBOMに接続されていれば、更新差分、評価結果、参照データの変更を時系列で比較し、原因仮説を迅速に絞れます。
すべてを完全に固定する必要はありません。外部APIや検索インデックスのように変動する要素は、バージョン、利用期間、変更通知、代替手段を記録します。再現不可能な要素を明示することも、利用者への誠実な説明と監査対応につながります。
- 学習・評価・推論の構成をまとめて記録
- 変更差分と評価差分を同じ単位で確認
- 変動する外部依存には期間と代替策を付与
- 再現できない条件も明示して誤解を防ぐ
AIライセンス管理を含む導入手順と運用設計
AIライセンス管理は部品単位で判定する
AIライセンス管理では、モデル、コード、データ、モデルウェイト、フォントや出力物の条件を分けて確認します。「OSSモデルだから自由に使える」とは限りません。商用利用、再配布、改変、帰属表示、用途制限、学習データに由来する条件を成果物ごとに記録します。
Apache 2.0のようなソフトウェアライセンスと、モデル提供者の利用規約、データセット固有の条件は適用範囲が異なります。AI SBOMでは、ライセンス名だけでなく、適用対象、証跡URL、確認日、判断者、例外承認の有無を紐付けるのが実務的です。
調達時に確認する質問票を標準化し、外部APIの入力データの扱い、学習への二次利用、保存地域、終了後のデータ削除を確認します。法務だけに判断を委ねず、開発・調達・情報セキュリティが同じ登録情報を参照できる運用にしましょう。
- コード、モデル、データ、出力物の条件を分離
- 利用規約の証跡と確認者を記録
- 例外利用は期限と代替策を含めて承認
- 外部APIの二次利用・保存条件を確認
小さく始める導入ロードマップ
AI SBOMの導入は、最も重要な1つのAIサービスから始めると定着します。全社の全資産を最初から登録しようとすると、情報品質が下がり、更新も止まります。顧客情報を扱うRAG、外部APIを使う業務支援、ツール実行を伴うエージェントなど、影響の大きい対象を選びます。
第1段階では、モデル、データ、コード、外部API、実行環境、所有者を棚卸しします。第2段階でレジストリに登録し、リリース時にAI SBOMを自動生成します。第3段階で脆弱性通知、ライセンス確認、承認ワークフローを継続運用へ組み込みます。
EU AI ActのArticle 11やAnnex IVのように技術文書が求められる局面でも、日常の記録があれば後追いの資料作成を減らせます。規制対応を目的化せず、変更の安全性と説明の速さを改善する仕組みとして、現場の開発フローに組み込むことが成功の鍵です。
| 段階 | 主な作業 | 完了条件 |
|---|---|---|
| 棚卸し | 重要資産の特定 | 所有者を確定 |
| 登録 | 構成・由来を記録 | 識別子を付与 |
| 自動化 | CI/CDで生成 | 差分を検知 |
| 運用 | 通知・監査を連携 | 定期レビュー |
- 重要度の高い1サービスを対象に着手
- 棚卸し、登録、自動化の順に段階化
- リリース条件に承認と記録更新を組み込む
- 監査向け資料を日常運用から生成
継続監視で台帳を形骸化させない
AI SBOMは、更新されなければ信頼できる判断材料になりません。コードのCI/CDだけでなく、モデル昇格、データ追加、プロンプト変更、RAG索引更新、外部API設定変更を検知し、登録情報との不一致を確認する仕組みが必要です。
月次などの定期レビューでは、所有者不明の成果物、期限切れの例外承認、廃止予定モデル、未評価の外部接続を確認します。重大な変更は、性能だけでなくセキュリティ、プライバシー、AIライセンス管理、利用目的との整合性を同時に審査します。
運用指標には、登録率、所有者設定率、更新遅延、未承認デプロイ件数、通知から影響判定までの時間を使えます。数字の達成だけを目的にせず、実際の変更や事故で台帳が役立ったかを振り返り、項目と自動化範囲を改善します。
- モデル・データ・プロンプト変更を検知
- 所有者不明と期限切れ例外を定期確認
- 安全性・契約・目的適合性を同時審査
- 運用指標と事故後レビューで改善
まとめ
AI SBOMは、AIを構成する部品を列挙するだけの文書ではありません。AIサプライチェーンの可視化、AIレジストリによるAI成果物管理、AIデータ系譜、AIモデルカード、AIライセンス管理をつなぎ、変更とリスクを説明可能にする運用基盤です。
要点
- AI SBOMにはモデル、データ、コード、API、プロンプト、実行環境を含める
- AIレジストリを正本にし、承認・配備・廃止まで管理する
- AIデータ系譜とAIモデルカードを結び、根拠と利用条件を明確にする
- ライセンスと脆弱性を継続監視し、インシデント時に影響範囲を即答できるようにする
- 重要な1サービスから始め、CI/CDと変更管理へ段階的に組み込む
まずは本番で利用中のAIサービスを1つ選び、モデル、データ、外部API、所有者、ライセンス、デプロイ先を書き出してください。その一覧をAI SBOMの初版としてレジストリへ登録し、次回リリースから更新を必須にすることが、実効性あるガバナンスへの第一歩です。
よくある質問
Q1. AI SBOMと通常のSBOMの違いは何ですか?
通常のSBOMが主にソフトウェア部品を対象にするのに対し、AI SBOMはモデル、モデルウェイト、学習・評価データ、RAGデータ、プロンプト、外部AI API、エージェント、推論基盤まで対象を広げます。
Q2. AI SBOMはどのチームが管理すべきですか?
MLOpsまたはプラットフォームチームを運用責任者にしつつ、開発、セキュリティ、法務、調達、プライバシー担当が各項目の正確性を担保する分担が現実的です。
Q3. AIレジストリとAI SBOMはどちらか一方で十分ですか?
一方だけでは不足しがちです。AI SBOMは構成と依存関係の記述に、AIレジストリは承認状態、所有者、配備先、監査ログを含む運用の正本に適しています。
Q4. 小規模な生成AI導入でもAI SBOMは必要ですか?
外部モデルやRAG、顧客データを扱うなら必要です。まずはモデル名、提供元、用途、データの保存先、外部API、所有者、ライセンス条件を記録する小さな台帳から始められます。
Q5. AIモデルカードには何を書けばよいですか?
想定用途、対象外用途、評価条件、既知の限界、データ概要、監視項目、残余リスク、問い合わせ先を記載します。AI SBOMのモデルIDとリンクさせると、構成情報と利用上の注意を一緒に確認できます。
参考文献・出典
[](https://www.linuxfoundation.org/projects) [Close Search](#)…
spdx.dev
公開日 2024年05月20日 更新日 2026年04月1日  By [Amanda…
www.ibm.com
SOFTWARE BILL OF MATERIALS FOR AI Minimum Elements FRANCE G71 VI AN 2026 1 EXECUTIVE SUMMARY Accessing information on the supply chain of an artificial…
www.bsi.bund.de