2026.10.26
LLM結構化輸出實戰:打造可靠 AI Agent 工作流程
AI資訊
LLM結構化輸出是讓生成式 AI 能夠穩定接上資料庫、企業系統與外部工具的關鍵。若模型只回覆一段看似合理的自然語言,程式仍得猜測欄位、處理格式錯誤,甚至把臆測內容當成可執行指令;一旦進入訂單、庫存或客服流程,這種不確定性很快會變成營運風險。
真正可上線的 AI Agent,不是要求模型「請用 JSON 回答」就結束,而是以 Schema 約束輸入與輸出、在伺服器端驗證商業規則,並為工具呼叫建立可觀測、可重試與可稽核的流程。從函數呼叫開發到 MCP協定,核心目的都是把語言模型的機率式回答,轉化為系統可安全處理的明確契約。
本文會從結構化輸出的原理開始,逐步拆解 JSON Schema、函數呼叫開發、Agent工具呼叫、MCP伺服器開發與 AI代理人框架的關係;接著提供 AI工作流程、AI代理人測試與 AI代理人評估的實作準則,也說明如何透過小規模 PoC,以真實資料判斷方案是否值得正式投資。
LLM結構化輸出為何是可靠自動化的底座
先理解自由文字與資料契約的差別
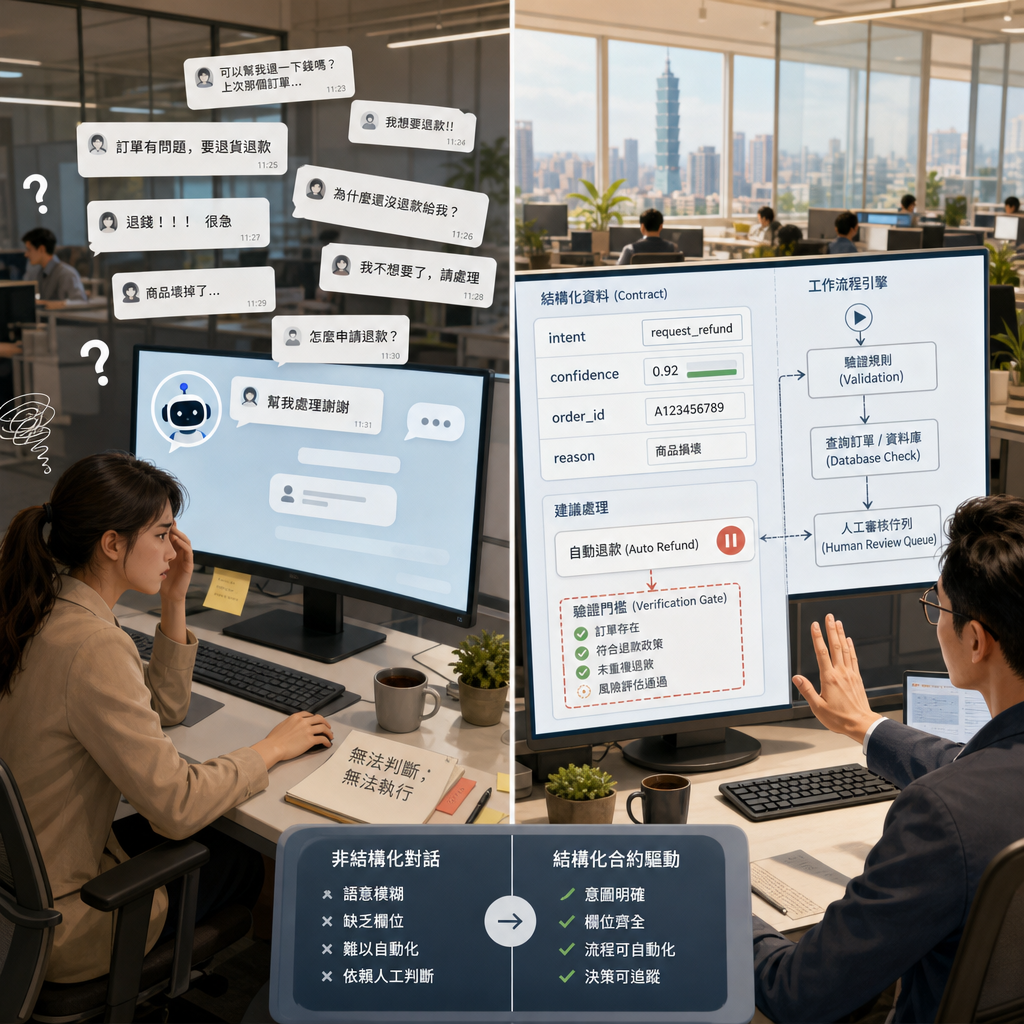
直接答案是:LLM結構化輸出把模型回覆限制為機器可解析的欄位、型別與允許值,讓後端不必從散文中擷取意圖。自由文字適合解釋與對話,但不適合直接驅動退款、建單或排程;同一句「幫我取消」,可能缺少訂單編號、原因與權限資訊,不能貿然執行。
例如客服分類可定義 intent、confidence、order_id 與 rationale;模型回傳「输出: 意图: refund, 置信度: 0.95」後,系統仍應檢查訂單是否存在、是否在退款期限內。把「明确的退款请求>0.9」與「模糊表达<0.7」分流,能讓高風險案件進人工覆核,而非讓模型自行決定。
結構化不等於絕對正確。它解決的是格式可預期與程式介面穩定,並不保證模型理解正確。團隊應將欄位驗證、權限檢查、資料庫交易與人工升級規則放在模型之外,將 LLM 視為提出候選判斷的元件,而非最後的業務裁決者。
- 以 Schema 定義欄位名稱、型別、必填與列舉值
- 將格式驗證與商業規則驗證分成兩層
- 低信心、缺資料與高風險動作必須可升級人工
JSON Mode、Structured Outputs 與提示詞各有角色
直接答案是:可靠度由低至高通常是提示詞要求 JSON、JSON Mode,以及由 Schema 強制約束的 Structured Outputs。只寫「請回傳 JSON」容易混入 Markdown、註解或未定義欄位;response_format = “type” “json_object” 可提高可解析性,但未必完整遵守您的欄位語意。
Structured Outputs(2024 年推出的功能)將 JSON Schema 納入回覆契約,可要求字串、數字、陣列、enum 與巢狀物件。實作時仍要處理逾時、內容拒答與網路錯誤;例如 retries int = 2 是常見起點,但重試前須確認操作是否具冪等性,避免重複建立工單。
提示詞工程並未失效,而是改變職責。用清楚的欄位描述、正反例、分隔符與少樣本示範,可提升語意判斷;Schema 則負責輸出形狀。公開工具生態中,Outlines @OutlinesOSS 7.6k✨、Jsonformer @rahulgs 4.2k✨與 Instructor: Structured LLM Outputs @jxnlco 7k✨,都反映開發者對受約束生成的需求。
- 提示詞負責任務意圖與判斷脈絡
- JSON Mode 優先解決有效 JSON 的問題
- Schema 約束用於欄位完整性與下游整合
選模型前先驗證 Schema 相容性
直接答案是:不要假設每個供應商對 JSON Schema 的支援完全相同,尤其在 union、reference 與巢狀限制上。實務上可用 model =”gpt-4o”、gemini-1.5-flash 或 llama3.1 建立相同測試集合,再比較有效 JSON 比率、欄位正確率、延遲與成本,而不是只比較示範對話效果。
跨平台設計時要記錄能力矩陣。JsonReferenceSchema 目前僅受 Azure OpenAI、Mistral 和 OpenAI 支持;JsonAnyOfSchema 目前僅受 OpenAI、Azure OpenAI 和 Google AI Gemini 支持。若需切換模型,應避免把特定供應商不支援的 Schema 特性寫死在核心流程。
版本亦會改變行為,部署紀錄至少要保存模型名稱、Schema 版本、提示詞雜湊與測試日期,例如 2025-06-01 00:00:00。工作流平台在 dify 1.3.0 與 dify 1.4.0 的升級前後,也應以相同資料集回歸測試;有些案例報告约85.1%、100% 的准确度或高达16%,都必須回到任務定義與樣本母體解讀。
- 將模型能力與 Schema 特性建立相容性清單
- 保存版本、提示詞與測試資料以便重現
- 不要將單一準確率宣稱當成正式上線保證
以函數呼叫開發讓模型安全操作系統
函數呼叫不是讓模型直接執行程式
直接答案是:函數呼叫開發是模型提出符合 Schema 的工具請求,由應用程式驗證、執行,再把真實結果送回模型組織回覆。模型本身不應持有資料庫密碼或付款權限;它只負責選擇工具與填寫參數,實際執行權仍在受控的後端服務。
最小範例可定義 get_current_weather(location: string, unit: ‘celsius’ | ‘fahrenheit’),使用者問 What is the weather like in London? 時,模型應回傳 location 與 unit,而不是虛構溫度。後端取得氣象 API 結果後,再讓模型產生可讀說明,確保回答依據是真實資料。
OpenAI 於 2023年6月13日 OpenAI 公布了 Function Calling(函数调用) 功能,當時主要對象是 GPT-4 和 GPT-3.5-turbo。如今設計重點不在「能不能呼叫」,而在函數命名、參數描述、授權範圍、錯誤回傳與稽核紀錄是否足以承受真實業務情境。
- 模型選擇工具與產生參數
- 應用程式驗證、授權並執行工具
- 工具結果必須回傳模型後再完成回答
把工具定義寫成可維護的 API 契約
直接答案是:函數名稱應表達單一業務意圖,參數描述要包含格式、限制與缺值處理,而不是把複雜流程藏在模糊工具裡。以 temperature=0 降低參數飄移,搭配 enum、最小長度與正規化規則,能讓模型較穩定地產生可驗證的 arguments。
相容性測試要明確記錄實際模型與 SDK。教學環境可能使用 pip install openai==1.47.0、gpt-3.5-turbo-1106 或 model=”gpt-3.5-turbo”;不同 SDK 對 tool_calls、function_call 與識別碼型別的處理可能不同,升級時不可只靠編譯成功判斷安全。
公開整理曾標示「原创 2025-04-21 20:17:47」與 2024-05-18 等時間點,提醒我們文件會快速過期。尤其 SDK 8.0.0 版本之前為 Long 類型,SDK 8.0.0 版本及之後為 String 類型;對外部整合而言,這類看似細微的序列化變更可能讓既有解析器失敗。
- 工具名稱採動詞加業務名詞,例如 create_return_request
- 參數說明要列出格式、範圍與例外條件
- 將 SDK、模型與回傳格式納入版本控管
處理平行呼叫與副作用風險
直接答案是:可平行的讀取工具可以並行,但會寫入資料或扣款的工具應採序列化、確認與冪等鍵。模型`gpt-4-turbo-preview`、`gpt-4-0125-preview`、`gpt-4-1106-preview`和`gpt-3.5-turbo-1106`支持并行函数调用功能,並不表示所有商業操作都適合同時執行。
相容清單雖可協助初步選型,但必須以官方現行文件覆核。常見記載為:目前支持函数调用的模型有:`gpt-4`、`gpt-4-turbo-preview`、`gpt-4-0125-preview`、`gpt-4-1106-preview`、`gpt-4-0613`、`gpt-3.5-turbo`、`gpt-3.5-turbo-1106`和`gpt-3.5-turbo-0613`。正式環境應以帳戶可用模型與版本政策為準。
建議在每次寫入操作前做三道門:Schema 驗證、使用者授權與商業規則檢查;寫入後回傳不可偽造的交易結果。將 max_retries=3 直接套在付款或建單請求可能造成重複交易,必須用 idempotency key、交易狀態查詢與人工補救流程控制。
- 讀取型工具可考慮平行化
- 寫入型工具需確認、冪等與交易紀錄
- 模型支援能力不等於業務上可安全執行
Agent工具呼叫如何形成可控的 AI工作流程
建立觀察、決策、執行、回饋循環
直接答案是:Agent工具呼叫應被設計成可中斷、可觀察的狀態機,而不是一段無限迴圈的提示詞。基本循環是讀取任務與狀態、選取工具、驗證參數、執行、寫回結果,再由模型決定下一步;每一輪都要留下 trace、工具輸入、輸出與失敗原因。
AI Agent 對多步任務特別有價值,例如先查庫存、再估算交期、最後草擬回覆;但它也會放大錯誤。研究觀察曾指出,24% of real-world knowledge work tasks correctly on the first attempt,代表首次就完全正確的比例仍有限,不能以展示案例取代流程防護。
在複雜任務中設定 maxStep: 50 不等於讓 Agent 有 50 次自由嘗試。團隊應設置預算、逾時、禁止工具與人工接管點,並以任務類型設定更小上限。若一個查詢超過預期輪數仍未完成,最安全的答案常是回報不足資訊,而不是繼續猜測。
- 每輪記錄計畫、工具、輸入、輸出與狀態
- 為步數、費用、逾時與權限設置硬限制
- 無法收斂時轉人工,不讓 Agent 無限重試
工具數量增加時要做檢索與分層
直接答案是:工具不是越多越好;在每次推理只提供 3-5 個候選工具,通常比把全部 Schema 注入上下文更容易選對。工具描述相近、參數相似或名稱含糊時,模型會混淆選擇,且不必要的工具定義會消耗大量上下文與成本。
當所有 120+ 工具的完整 schema 一次性注入 system prompt,可能超 50K tokens;資料也指出,5 個 MCP 伺服器就可能引入數萬 token 的工具定義開銷。可先用輕量分類器或關鍵字檢索找出候選,再讓主模型閱讀少量完整 Schema,兼顧準確率與延遲。
加入示例後,工具呼叫的準確率往往明顯提升——在一些基準上可從約 72% 提升到 90%(具體數值因任務而異)。另一項 Anthropic 實驗則顯示按需檢索讓 Opus 4 從 49% 提升到 74%。這些數字可作為設計假設,仍應用自家任務、語言與工具集合重新測量。
| 策略 | 上下文成本 | 選擇穩定性 | 適用情境 |
|---|---|---|---|
| 全量注入 | 高 | 工具少時可接受 | 小型原型 |
| 候選檢索 | 中低 | 較高 | 多工具企業系統 |
| 分層路由 | 低 | 需額外評估 | 大型工具生態 |
- 先檢索候選工具,再提供完整定義
- 將工具依領域、風險與操作類型分層
- 以真實任務比較全量注入與按需載入
選擇 AI代理人框架前先定義控制面
直接答案是:AI代理人框架應協助管理狀態、工具、記憶、重試與可觀測性,而不是取代系統架構決策。LangChain 1.0、Spring AI 2.0 等框架可加速原型,但團隊仍需自行決定身分驗證、秘密管理、交易界線與錯誤升級策略。
選擇框架時,先驗證它能否輸出完整 trace、支援 Schema 驗證、攔截危險工具與注入測試替身。對於只需單次資料擷取的需求,直接 API 加 Pydantic 可能更簡單;只有需要多步規劃、共享狀態或跨工具協作時,才值得引入完整 AI代理人框架。
市場採用不等於風險已解決。調查指出 December 2025. 11% in production, 38% piloting.,也有 only 23% of generative AI (GenAI) early adopters feel highly prepared for managing AI risk and governance. 因此架構選型應把治理能力列為驗收條件,而不是等上線後才補救。
- 框架要能提供 trace、狀態與工具攔截
- 簡單任務優先採用較小的實作面
- 治理、權限與稽核是選型必要條件
MCP協定與 MCP伺服器開發的整合方法
MCP協定解決的是連線標準化
直接答案是:MCP協定讓 AI 應用能以一致方式探索與使用外部工具、資源及提示內容,降低每個模型供應商都要重寫整合層的成本。Model Context Protocol(MCP)是 Anthropic 於 2024 年底發布的開放標準,但採用標準不會自動解決資料權限與業務風險。
傳統點對點整合會隨 Agent 與資料源數量快速膨脹。例如企業中有10个AI Agent(N)需要接入20个数据源/工具(M),理論上就會形成 200个集成点。將工具封裝為可管理的 MCP 服務,可讓多個客戶端共用介面、驗證邏輯與文件。
不過標準化不應變成「把所有內部 API 全部開放」。每項工具都應以最小權限設計,明確區分讀取、草稿、提交與管理操作;伺服器端必須依使用者身分再次授權,因為模型傳來的工具請求本身不是可信的權限憑證。
- MCP 統一工具探索與呼叫介面
- 伺服器端仍須獨立完成驗證與授權
- 工具公開範圍應遵循最小權限原則
MCP伺服器開發要先設計安全邊界
直接答案是:MCP伺服器開發應從資料分類、使用者身分、可呼叫操作與稽核事件開始,而非先把既有 REST API 直接包裝出去。每個 tool 的輸入輸出都要有 JSON Schema,並在伺服器端對租戶、資源所有權、速率與操作權限進行第二次檢查。
良好的 MCP 工具粒度應貼近可驗證的業務動作,例如 search_customer_orders、draft_return_request 與 submit_return_request 分開。草稿與提交拆分後,AI 可先整理資訊並請人確認;即使提示遭注入,也較難從查詢工具直接越權完成不可逆的寫入。
測試環境應提供假資料、模擬失敗與可重播記錄。對於金流、個資與庫存,禁止讓開發期 Agent 連到正式資料庫;須以遮罩資料驗證 Schema、錯誤碼與權限拒絕行為,再進行受控的真實資料 PoC,並簽署必要的保密安排。
- 把查詢、草稿與提交拆成不同工具
- 在 MCP 伺服器重做授權與資源所有權檢查
- 提供測試替身與可重播的工具紀錄
降低 MCP 上下文成本與供應鏈風險
直接答案是:MCP 客戶端必須做伺服器與工具的按需探索,否則工具描述本身會擠壓任務上下文。針對約 2800 個工具的案例,按需方式比全量注入節省約 98% 的 token;A/B 測試也顯示 MCP 工具相關任務總 token 消耗減少了 46.9%。
安全面向則要把 MCP 伺服器視為第三方程式碼與資料供應鏈。導入前應審核來源、版本、維護者、所需權限與網路目的地;執行時記錄工具清單變化與每次呼叫,避免惡意或被竄改的描述誘導 Agent 洩漏機密或做出越權操作。
若企業要連接多種模型,可將 MCP 作為工具層,將模型路由留在應用層。像 gpt-4.1 或 API 版本 2024-12-01-preview 的更換,都應先在隔離環境驗證工具選擇與輸出格式;模型更新不該繞過既有的權限、記錄與回歸測試流程。
- 按需載入工具以節省 token 與降低混淆
- 審核 MCP 伺服器來源、權限與版本
- 模型切換前必須重跑工具呼叫回歸測試
用 AI代理人測試與 AI代理人評估建立上線門檻
測試應同時量格式、決策與副作用
直接答案是:AI代理人測試不能只看最終文字是否通順,至少要分別驗證 JSON 是否符合 Schema、是否選對工具、參數是否正確、是否遵守權限,以及是否達成任務。每筆測試案例應有預期工具序列、可接受輸出範圍與禁止動作,讓失敗可以定位。
建議建立黃金資料集,涵蓋正常案例、缺欄位、多意圖、模糊指令、惡意提示、權限不足與工具逾時。對結構化輸出,除解析成功率外,還要檢查 enum 是否被誤用、必填欄位是否臆造,以及模型拒答時是否回傳符合契約的錯誤物件。
測試不應依賴單次執行。固定 temperature=0 可降低隨機性,但供應商更新、工具資料變化與上下文不同仍會造成漂移。每次模型、提示詞、Schema 或工具描述調整後,都要跑相同資料集並比較差異,將可接受退步門檻寫入發布規則。
- 格式正確不等於工具選擇正確
- 測試集要包含模糊、惡意與失敗情境
- 模型與 Schema 變更後都要做回歸測試
以任務導向指標進行 AI代理人評估
直接答案是:AI代理人評估應以業務任務成功、錯誤類型與人工介入成本為核心,而非只看聊天滿意度。可將指標拆為結構有效率、工具選擇正確率、參數正確率、端到端完成率、平均步數、延遲、成本與安全違規率,才能理解改善真正發生在哪一層。
評估時要將「正確但未完成」和「完成但越權」視為不同失敗。前者可能需要更好的工具描述或資料補齊;後者則代表權限設計有漏洞。對高風險流程,寧可降低自動完成率,也不能以漂亮的成功率掩蓋未經確認的退款、刪除或外傳資料。
除了離線資料集,也應以影子模式觀察真實 AI工作流程:先讓 Agent 提出建議,不實際寫入,與人員處理結果比對。確認工具選擇、欄位擷取及例外處理穩定後,再逐步開啟低風險操作,並持續監控新類型失敗。
| 階段 | 主要檢查 | 可執行權限 |
|---|---|---|
| 離線測試 | Schema、工具、參數 | 無 |
| 影子模式 | 與人工結果比對 | 唯讀 |
| 受控試行 | 例外與升級流程 | 低風險寫入 |
| 正式營運 | 漂移與稽核 | 依角色授權 |
- 端到端成功率需搭配安全違規率解讀
- 把錯誤按格式、選擇、參數、權限與結果分類
- 先以影子模式驗證,再逐步擴大自動化範圍
以小規模 PoC 取得投資判斷證據
直接答案是:最務實的導入方式,是用真實資料與實際工作情境進行小規模 PoC,先驗證精度、效益與現場可用性,再決定是否擴大。ALION 的做法從現場調查與 KPI 設定開始,避免在需求仍模糊時,就投入完整 AI Agent 平台開發。
一個可執行的 PoC 應明定「做什麼、不做什麼」:例如只驗證客服意圖分類與工單草稿,不直接退款;或只驗證需求預測結果能否輔助下單建議。驗證後需整理準確率、人工節省時間、例外比例、資安限制與正式版成本,作為 Go/No-Go 依據。
若團隊缺少 AI 架構與上游工程能力,可採月費 20 萬日圓起的顧問式支援,先完成需求梳理、架構設計與示範原型。以 1,000 萬日圓規模的開發案而言,上游工程約需 3 個月(約 60 萬日圓);重要的是讓 PoC 設計、程式碼與評估資產能延續,而非成為一次性展示。
- 以真實資料驗證,而非只用展示範例
- KPI 同時涵蓋精度、效率、風險與使用體驗
- PoC 結果可以是擴大、再驗證或暫緩開發
總結
LLM結構化輸出是可靠 AI 系統的共同語言:它讓模型輸出能被驗證、函數呼叫能被安全執行、Agent 能在受控流程中使用工具,而 MCP協定則有助於把跨系統整合標準化。真正的成熟度不在於 Agent 能做多少事,而在於團隊能否清楚說明它何時可做、何時必須停下,以及每個決策是否可被重現與稽核。
重點整理
- 以 JSON Schema 約束模型輸出,並在後端執行商業規則與權限驗證。
- 函數呼叫與 Agent工具呼叫都必須由應用程式掌握實際執行權。
- MCP伺服器開發需遵循最小權限、按需載入與供應鏈審核。
- AI代理人測試與 AI代理人評估應量測端到端任務、安全性與人工介入成本。
- 先透過真實資料 PoC 證明可行性與效益,再逐步擴大自動化。
若您正評估客服、知識查詢、庫存預測或內部作業自動化,建議先挑選一個低風險、可量化的流程,定義 Schema、工具權限與成功 KPI。透過現場訪談、原型驗證與回歸測試,把「看起來能做」轉化成能支持投資決策的證據,再決定正式系統的範圍與治理方式。
常見問題 FAQ
Q1. LLM結構化輸出和要求模型回傳 JSON 有什麼差別?
要求 JSON 通常只是提示詞要求,模型仍可能輸出 Markdown、遺漏欄位或加入未定義內容。結構化輸出會以 JSON Schema 限制欄位、型別、必填值與列舉值;不過後端仍要進行權限、資料存在性與商業規則驗證。
Q2. 函數呼叫開發是否代表模型可以直接存取資料庫?
不代表。安全做法是讓模型回傳工具名稱與參數,由應用程式驗證身分、權限與輸入後,透過受控服務執行查詢或寫入。模型不應直接取得資料庫連線字串、付款憑證或高權限 API 金鑰。
Q3. 何時需要導入 MCP協定?
當同一組工具需要被多個 AI 應用、模型或 Agent 使用時,MCP協定有助於統一探索與呼叫方式。若只有一個小型、固定的單一應用,直接以受控 API 進行函數呼叫可能更簡潔;是否採用仍取決於治理與維運需求。
Q4. 如何開始 AI代理人評估?
先選定單一且低風險的任務,建立含正常、模糊、權限不足與工具失敗情境的黃金測試集。依序量測 Schema 有效率、工具選擇、參數正確性、任務完成率與安全違規,再以影子模式和人工結果比對。
Q5. 有哪些可信的技術參考來源?
可優先查閱 OpenAI Structured Outputs 文件:https://platform.openai.com/docs/guides/structured-outputs;OpenAI Function Calling 指南:https://platform.openai.com/docs/guides/function-calling;Anthropic MCP 文件:https://modelcontextprotocol.io/;Google Gemini Structured Output 文件:https://ai.google.dev/gemini-api/docs/structured-output;以及 NIST AI Risk Management Framework:https://www.nist.gov/itl/ai-risk-management-framework。