2026.10.25
AIコードレビューで品質を高める実践設計
IT関連
AIコードレビューは、プルリクエストに対する指摘を速くするだけの仕組みではありません。コードの意図、変更範囲、既存ルールを踏まえて確認し、人間が設計と責任ある判断に集中するための品質プロセスです。
開発の高速化で変更量が増えるほど、属人的なレビューや待ち時間は品質リスクになります。生成AIを活用すれば、定型的な確認、テスト観点の洗い出し、修正候補の提示を補助できますが、導入目的と判断基準が曖昧ではノイズも増えます。
本記事では、AIコードレビューの仕組みと従来ツールとの違いを整理し、Copilot活用、AIテスト自動化、AI品質保証、AI脆弱性診断、AI受入テスト、AI成果物管理を一つの開発フローとして設計する手順を紹介します。
AIコードレビューとは何か、何を任せるべきか
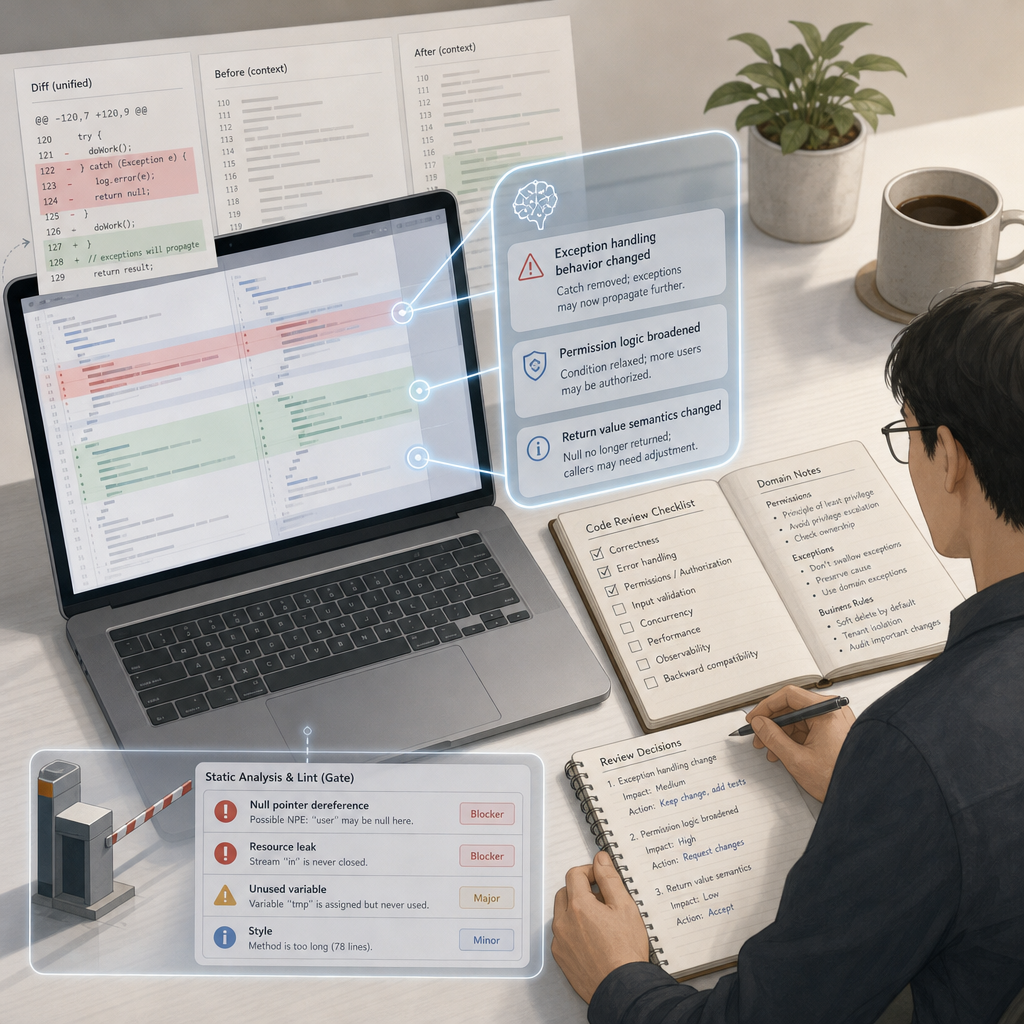
AIコードレビューは変更の意味を読んで確認を補助する
AIコードレビューとは、生成AIや大規模言語モデルが差分、周辺コード、設定ファイル、レビュー規約を参照し、バグ候補や改善案を提示する仕組みです。構文エラーだけでなく、変更が呼び出し側へ及ぼす影響を確認できる点に価値があります。
人間のレビュアーが1時間かかるバグ・ハンティングのミッションが、AI駆動型ツールではわずか数分で完了する場合があります。ただし、これは判断を完全に置き換える数字ではなく、調査の初動を速めるための目安として扱うべきです。
有効な運用では、AIに「差分の説明」「例外処理の漏れ」「既存規約との不一致」を確認させます。一方で、要件の妥当性、ドメイン上の優先順位、顧客影響、マージ可否は、人間が根拠を持って決定します。
- AIが得意:差分の走査、重複実装、例外処理、規約違反の候補提示
- 人間が担う:要件解釈、設計判断、リスク受容、最終承認
- 目標:コメント数ではなく、有用な指摘から修正へ至る割合
静的解析やリンターとは役割が異なる
AIコードレビューは、静的解析やリンターを置き換えるものではありません。リンターは書式や既知の規約違反を高速かつ決定的に検出し、静的解析は型、データフロー、既知パターンを検査する土台になります。
これに対してAIは、関数名、コメント、差分の目的、周辺実装を材料にして、意味的な不整合を仮説として示します。そのため、決定的な品質ゲートは既存ツールで守り、AIは優先順位付けと説明補助に使う設計が安全です。
たとえば認可チェックの削除は、静的ルールで確実に止められる場合があります。AIには、その変更によって別経路の権限確認が失われていないか、テスト観点を追加すべきかを問い、二層で確認すると効果的です。
| 観点 | リンター・静的解析 | AIコードレビュー | 人間レビュー |
|---|---|---|---|
| 主な対象 | 構文・ルール | 差分・文脈 | 要件・設計 |
| 結果の性質 | 決定的 | 仮説的 | 責任ある判断 |
| 実行タイミング | 保存・CI | PR作成時 | 承認前 |
| 強み | 再現性 | 説明と探索 | 優先順位判断 |
- リンター:書式・命名・単純な規約違反を検出
- 静的解析:型・データフロー・既知の危険パターンを検査
- AI:変更意図と周辺文脈を踏まえた確認観点を提案
コンテキスト設定が指摘の質を左右する
AIコードレビューの精度は、モデル名だけでは決まりません。リポジトリ規約、アーキテクチャの境界、命名規則、禁止ライブラリ、重要な業務ルールを明示し、AIが判断に使う文脈を整えることが重要です。
最初は1リポジトリで始め、直近2〜4週間分のプルリクエストを使って検証すると、現場負担を抑えられます。過去のレビューで頻出した指摘を分類すれば、ルール化すべき項目と人間に残すべき項目が見えます。
RAGやMCPで設計書、API仕様、運用手順へ接続する場合も、参照範囲を絞りましょう。機密情報を無制限に渡すのではなく、必要な情報だけを権限に応じて取得させることが信頼の前提です。
- リポジトリ固有のルールを文章化する
- コメントの重要度と対象外を定義する
- 仕様参照には最小権限と監査ログを適用する
レビュー工程にCopilot活用を組み込む方法
Copilot活用は作成からレビュー前確認まで連続させる
Copilot活用は、コード補完だけに限定しないことが重要です。実装前に受け入れ条件を要約させ、実装中に例外ケースを洗い出し、プルリクエスト前に変更内容とテスト不足を説明させると、レビュー前の品質が整います。
レビュー依頼時には、変更目的、影響する画面やAPI、意図的に選んだ設計、未解決の懸念をAIで要約します。レビュアーが差分の探索から始めずに済むため、重要な論点に時間を配分しやすくなります。
Copilot活用の成果は、出力量では測れません。提案が採用された理由、却下された理由、修正後に再発した問題を振り返り、プロンプト、リポジトリ指示、チーム規約を少しずつ改善する運用が必要です。
- 実装前:要件をテスト可能な条件へ分解する
- 実装中:境界値・例外処理・命名の候補を確認する
- レビュー前:変更理由と検証結果をPR本文に整理する
業務で得た知見を開発品質へ還元する
Copilot活用は、開発部門だけのテーマではありません。契約書レビューの所要時間が15分から5分へ約66%短縮されたという報告のように、定型確認を短縮して、人が例外や交渉判断に集中する考え方はコードレビューにも応用できます。
中小企業リーダーの81%が2025年は戦略とオペレーションを根本的に見直す節目の年であると回答しています。レビューの自動化も単独導入ではなく、要件定義、テスト、リリース後の学習をつなぐ業務設計として検討すべきです。
45%がデジタルレイバーによるチーム対応力拡大を優先事項とし、79%が今後12〜18か月以内にエージェント導入を予定しています。だからこそ、AIの提案を誰が承認し、何を記録し、どこまで自動実行するかを先に決めます。
- AIの出力は下書きとして扱い、事実確認を行う
- 業務知識の参照元と更新責任者を明確にする
- 承認が必要な操作は人間の確認を必須にする
コメントのノイズを減らす運用ルールを作る
AIのレビューコメントは、量が多いほど価値が高いわけではありません。既存のリンターと重複する指摘、意図したトレードオフを無視する指摘、修正根拠が弱い指摘は、レビュアーの注意力を奪うノイズになります。
まず重大度を「ブロッカー」「要確認」「提案」に分け、ブロッカー以外はスレッドへ集約します。さらに、対象外のディレクトリ、生成コード、既知の例外をルールに登録し、指摘の繰り返しを減らします。
約52%のコメントがコード変更につながり、人間のレビュアーとほぼ同じ割合という報告があります。一方で採用率だけを追うと、軽微な修正に偏るため、重大な欠陥をどれだけ早期に防げたかも確認しましょう。
- 各コメントに根拠、影響範囲、修正案を求める
- 低価値な指摘はフィードバックしてルールを調整する
- 人間レビューで確認する論点をPRテンプレートに残す
AIテスト自動化でレビュー後の検証を強くする
AIテスト自動化はレビュー指摘を再現可能な検証へ変える
AIテスト自動化は、自然言語の要件や差分からテスト観点、テストコード、テストデータの候補を作り、実行結果の分類まで支援する仕組みです。レビューで見つけた懸念を、一度きりのコメントで終わらせず、継続的な検査へ変えられます。
リリースサイクルは週単位、場合によっては日単位にまで短縮されています。この環境では、すべてを手動で回帰確認する方法は限界があります。ユニット、API、E2Eをテストピラミッドとして分け、速い検査を手前に置くことが基本です。
AIにテストを生成させる際も、期待値とアサーションは人間が確認します。生成されたテストが実装詳細に依存しすぎると、正しい変更でも壊れやすくなり、保守コストが増えるためです。
- レビュー指摘を回帰テスト候補として登録する
- 高速なユニットテストを品質ゲートの中心に置く
- E2Eは重要導線と受け入れ条件へ絞る
生成・修復・トリアージを分けて運用する
AIテスト自動化で最初に狙うべきは、全テストの置換ではなく、反復作業の削減です。スクリプト作成を90%削減した事例もありますが、生成結果を無審査でCIへ組み込むと、脆いテストや誤った期待値が蓄積します。
UI変更でテストが失敗した場合、AIはDOM差分から修復案を出せます。しかし、画面変更が仕様変更なのか不具合なのかは別問題です。失敗を「環境」「テスト」「実装」「仕様」に分類してから修復案を採用します。
「MIXI M」のリグレッションテストの約70%を自動化しました。という実例は、対象を選んで自動化する重要性を示します。頻度が高く、結果が安定し、判定条件が明確な回帰テストから始めるのが現実的です。
- 生成:要件からケースと境界値を提案させる
- 修復:変更理由を確認してからセレクターを更新する
- 分類:失敗原因をタグ付けし、再発傾向を把握する
AI品質保証はテスト数ではなくリスク低減で評価する
AI品質保証では、テスト件数やコードカバレッジだけで成功を判断しません。利用頻度の高い機能、金銭や個人情報を扱う処理、障害時の影響が大きい連携を優先し、欠陥を早く発見できたかで評価します。
テストカバレッジが従来の約30~40%から65~85%程度へ伸びたとしても、重要な分岐を通過していなければ安心できません。ミューテーションテスト、障害履歴、レビューでの指摘傾向を組み合わせ、質的な穴を確認します。
メンテナンス作業を85%削減したという成果も、シナリオの安定性と保守設計があってこそ再現できます。AIが直した変更内容を履歴へ残し、レビューし、同じ原因で壊れないようテスト設計を改めます。
- 重要機能ごとに受け入れ条件と自動検査を対応付ける
- Flaky Testは成功率ではなく原因別に管理する
- カバレッジは品質の代理指標として限定的に使う
AI脆弱性診断と受入確認を品質ゲートにする
AI脆弱性診断は早期警告として組み込む
AI脆弱性診断は、コード差分、依存関係、認可処理、設定変更から危険なパターンを探し、確認順を提案するために有効です。ただし、脆弱性の確定には実行条件、データ到達性、権限設計を人間が検証する必要があります。
プルリクエストでは、シークレット混入、入力検証の欠落、SQLインジェクション、アクセス制御の後退などを確認対象にします。AIの説明を起点に、既存のSAST、依存関係スキャン、シークレットスキャンを通す多層防御が基本です。
特に外部APIや決済、個人情報を扱う変更は、脅威モデルとの照合を加えましょう。攻撃者の視点で「どの入力がどの権限でどこまで到達するか」を確認すると、一般的なレビューでは見落としやすい経路を発見できます。
- 機密情報、依存関係、認可、入力処理を優先検査する
- AIの検出結果は再現手順で確認する
- 重大度と修正期限をチームで定義する
AI受入テストは利用者の成功条件を検証する
AI受入テストは、実装が仕様どおり動くかだけでなく、利用者が目的を達成できるかを確認する工程です。AIは要件文から正常系、異常系、境界条件のシナリオを抽出できますが、受け入れ基準の最終承認は業務担当者が担います。
たとえば予約機能なら、登録できることだけでは不十分です。重複予約、取消期限、通知失敗、権限の違い、海外時差など、業務上の例外を受け入れ条件へ明記し、AIにテスト観点を展開させます。
ALION株式会社のように、アプリ開発から国境を越えたチーム支援まで行う開発体制では、仕様の認識差を早期に解消することが重要です。AIを議事録と要件の照合に使い、曖昧な表現を確認事項として残す運用が役立ちます。
- 受け入れ条件を「操作・結果・例外・権限」で記述する
- 業務担当者がシナリオの優先順位を決める
- 実行結果だけでなく確認者と根拠を記録する
品質ゲートは停止条件と例外処理を明確にする
品質ゲートを機能させるには、AIの指摘が出たら必ず止める、という運用にはしません。重大な脆弱性、テスト失敗、承認不足など、マージを止める条件を明文化し、例外を認める場合の責任者と期限を決めます。
AI脆弱性診断で高リスクの候補が出ても、偽陽性である可能性はあります。根拠、再現結果、リスク受容の判断をプルリクエストへ残せば、速度を保ちながら監査可能性を高められます。
受入確認の未完了も同様です。緊急リリースで後続確認を認めるなら、対象範囲、暫定対策、実施期限を明記し、次のリリースで自動的に忘れられない仕組みにします。
- 停止条件を重大度と変更種別で定義する
- 例外には承認者、理由、期限を必ず残す
- 未完了の受入確認をチケットで追跡する
AI成果物管理と指標で導入を定着させる
AI成果物管理は再現性と説明責任を守る
AI成果物管理とは、AIが生成・要約・修正提案したコード、テスト、レビューコメント、要件整理を、根拠と承認履歴が追える状態で扱うことです。生成物を個人端末だけに残す運用では、知識も責任もチームへ継承されません。
プルリクエストには、使った指示の要点、参照した仕様、AI提案の採否、追加したテスト、最終承認者を残します。すべての会話を保管する必要はありませんが、設計判断に影響した情報は後から確認できる必要があります。
AI成果物管理は、著作権、ライセンス、機密情報の観点でも重要です。外部サービスへ入力してよい情報、利用可能なモデル、ログの保持期間、削除手順を定め、開発者が迷わず守れる形にします。
- 生成物をソースコードと同じ変更管理の文脈に置く
- 採用・却下の判断理由を短く残す
- 入力データの分類と利用可能なAIを対応付ける
30日、60日、90日の区切りで効果を測る
導入効果は、初日から全社展開するより、30日、60日、90日の区切りで評価する方が適しています。最初の30日はコメント品質と設定調整、60日はテスト・セキュリティ連携、90日は対象リポジトリ拡大の判断に充てます。
測定する指標は、レビュー待ち時間、コメント採用率、修正後の再オープン率、リリース後の欠陥、重大指摘の検出時点です。レビュー時間だけを削減目標にすると、確認の省略を促すおそれがあります。
40回の実験を通じて、解決率は52%から70%以上へという報告もあります。自社でも、どのルール変更やフィードバックが改善につながったかを時系列で見て、モデル任せではなく運用の改善として学習させましょう。
- 開始前に現状のレビュー時間と欠陥傾向を記録する
- 指標は速度・品質・安全性の3面で確認する
- 改善施策と数値変化を同じ期間で追跡する
人とAIの役割を継続的に見直す
定着の鍵は、AIを監督不要な自動承認者にしないことです。AIコードレビューは、確認漏れを減らし、説明のたたき台を作る支援者として位置付け、人間は要件、設計、セキュリティ、顧客影響に責任を持ちます。
新しいツールやモデルを追加する場合は、既存の品質ゲートとの重複を点検します。指摘が増えても修正につながらないなら、ルールを増やすのではなく、対象範囲、文脈、重大度設定を見直す方が効果的です。
開発、QA、セキュリティ、業務部門が同じ基準を共有すれば、AI受入テストからAI成果物管理までが一本の流れになります。小さなパイロットで学び、根拠を残しながら広げることが、持続する品質改善につながります。
- AIの提案と人間の承認を明確に分離する
- 定期的に偽陽性・偽陰性をレビューする
- 開発・QA・業務部門で品質基準を共有する
まとめ
AIコードレビューは、単なるレビュー高速化ツールではなく、実装、テスト、セキュリティ、受入確認、成果物管理を接続する仕組みです。決定的な検査は既存ツールで守り、AIには文脈の整理と確認観点の拡張を任せることで、速度と信頼性を両立できます。
要点
- AIは差分確認と観点抽出を担い、人間は要件・設計・承認に責任を持つ。
- Copilot活用は実装支援だけでなく、PR要約と検証観点の整理までつなげる。
- AIテスト自動化は、レビュー指摘を再現可能な回帰テストへ変える。
- AI脆弱性診断、AI受入テスト、AI成果物管理を品質ゲートとして統合する。
- 小規模な検証から始め、30日、60日、90日で速度・品質・安全性を測定する。
まずは対象を1リポジトリに絞り、頻出するレビュー指摘、受け入れ条件、既存テストを棚卸ししましょう。チーム固有のルールと承認基準を整えたうえで導入すれば、AIを安心して使える品質パートナーへ育てられます。
よくある質問
Q1. AIコードレビューだけで人間のレビューは不要になりますか?
不要にはなりません。AIは差分探索、規約確認、テスト観点の提示に有効ですが、要件の妥当性、設計上のトレードオフ、セキュリティ上のリスク受容、最終承認は人間が担うべきです。
Q2. AIコードレビューはどこから導入すべきですか?
変更頻度が高く、レビュー基準が比較的明確な1リポジトリから始める方法が適しています。過去のプルリクエストを使い、指摘の有用性、ノイズ、レビュー待ち時間への影響を確認します。
Q3. AIテスト自動化で手動テストはなくせますか?
完全にはなくせません。回帰テストや定型操作は自動化に向きますが、使いやすさの評価、業務上の例外、仕様の曖昧さを解消する探索的テストや受入確認には人間の判断が必要です。
Q4. AI脆弱性診断の結果はそのまま修正すべきですか?
そのまま修正せず、再現性、到達可能性、影響範囲を確認してください。AIの指摘は調査の優先順位付けに使い、SAST、依存関係スキャン、セキュリティ担当者のレビューと組み合わせて判断します。
Q5. AI成果物管理で最低限残すべきものは何ですか?
生成物そのものに加え、参照した仕様、採用または却下した理由、追加したテスト、承認者、例外処理の期限を残します。後から設計判断と責任範囲を説明できる状態を保つことが重要です。
参考文献・出典
IBM Bobがセルフホスト型になりました 機密性が高くミッションクリティカルなワークロード向けに構築 | 詳細はこちら 公開日 2024年10月15日 更新日 2026年05月28日  [サインイン](/dashboard)[お問い合わせ営業担当に問い合わせる](/contact-sales?source=navbar)[ダウンロード](/ja/download) ·コードレビュー # AIコードレビュー:より多くのコンテキスト、より少ないバグ 読了時間 1分…
cursor.com
[](https://magicpod.com/) * [機能一覧](https://magicpod.com/features/) *…
magicpod.com