2026.10.24
LLM語意快取實戰指南:降低成本並加速 AI 回應
AI資訊
LLM語意快取是讓 AI 應用更快、更省的重要機制:使用者即使換了說法,只要問題意圖相近,系統便可直接回傳已驗證過的答案,而不必再次呼叫大型語言模型。對客服、知識庫與內部 Copilot 而言,這往往是改善等待體驗與 API 帳單最快的槓桿。
傳統快取只能辨識完全相同的文字,但「退貨流程怎麼走」與「我要申請退貨,要準備什麼」雖然字串不同,業務意義卻很接近。語意快取會先將問題轉為向量,再透過相似度搜尋找出可信答案;命中時省下模型推論,未命中才交由 LLM 生成。
本文會從快取層級、命中決策、向量搜尋、TTL 與失效策略談起,接著說明 RAG、客服、多輪對話與代理工作流的實作差異,也提供效能指標、安全治理與 PoC 驗證框架,讓團隊能以真實資料做出 Go/No-Go 的投資判斷。
LLM語意快取的原理與可解決的問題
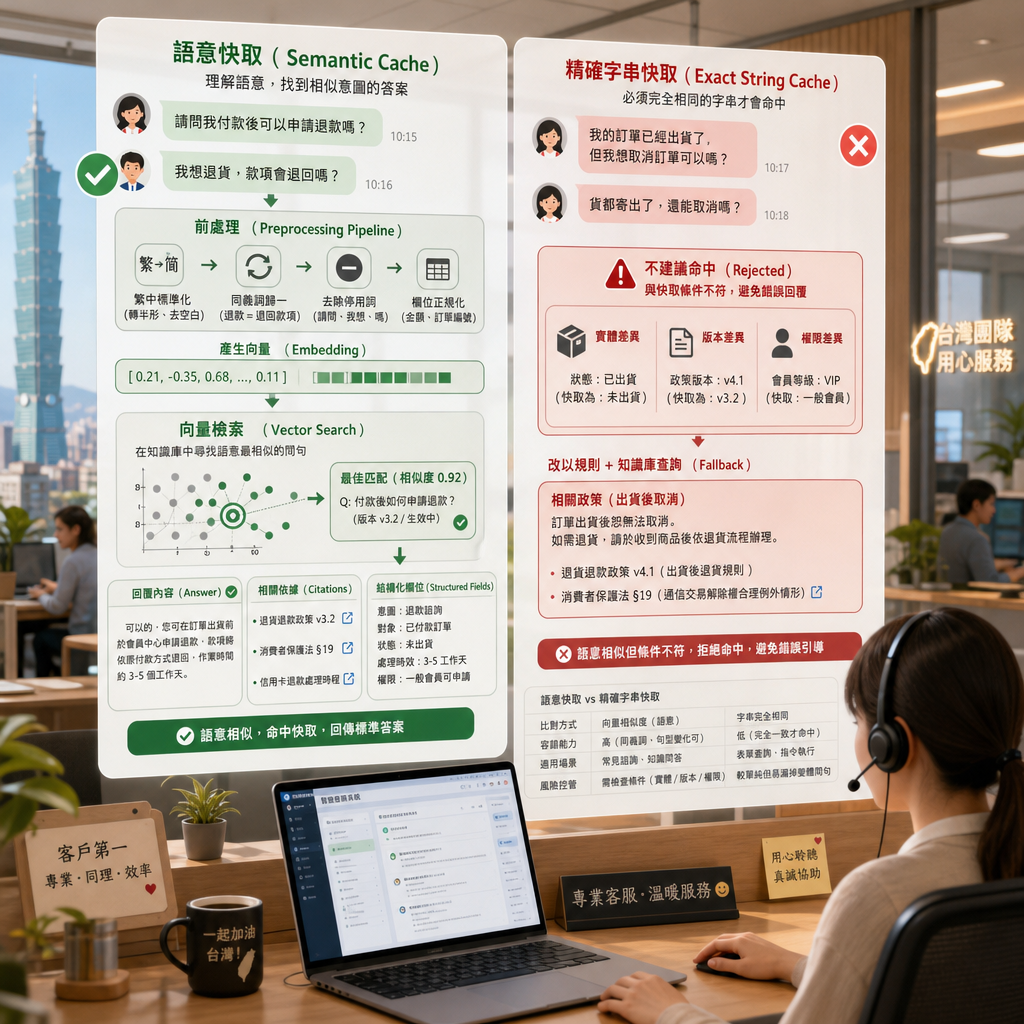
語意快取不是一般的字串快取
直接答案是:語意快取以問題意圖為比對基礎,而非只看字元是否完全一致。系統會把輸入文字做正規化、產生 Embedding,並在向量索引中尋找最相近的歷史問題;若分數跨過安全門檻,便取回先前保存的回答、引用資料與必要的結構化欄位。
這種設計特別適合高重複率的服務情境。客服人員每天可能被問到付款、退換貨、帳號權限與出貨進度;不同客戶的措辭千變萬化,但可對應的政策答案有限。快取命中後,使用者可在極短時間獲得一致回覆,模型也不必重複閱讀相同的長提示詞。
不過,語意相似不等於業務答案必然相同。像「可否取消訂單」與「已出貨後可否取消訂單」字面接近,處理規則卻可能不同。因此可直接快取的內容必須同時考慮意圖、關鍵實體、使用者權限、地區與資料版本,不能只依單一向量距離下判斷。
- 完全相同的請求可先走雜湊快取。
- 語意相近的請求再走向量搜尋。
- 高風險問題應保留 LLM 或人工覆核路徑。
一次請求如何命中或未命中
直接答案是:健全流程應先由低成本、高精度的規則判斷開始,再逐層提高彈性。請求進入 API 後,可先移除無意義空白、統一日期格式與語言標記,接著以租戶、角色、知識版本及模型版本組成精確快取鍵,優先查詢完全相同的結果。
若精確查詢未命中,才產生查詢向量並執行 topK 搜尋。系統不應只拿到最高分就回覆,而要檢查相似度、答案建立時間、文件引用是否仍有效,以及該答案是否符合目前使用者的存取權限;任何一項不符,都應判為未命中。
未命中時,系統會呼叫 RAG 或 LLM 產生新答案,並把通過品質檢查的結果寫回快取。若回答涉及即時庫存、交易狀態或個人資料,建議只快取安全的摘要或模板,不快取完整回覆;如此能避免後續請求讀到過期或跨帳號的資訊。
- 精確快取處理重複請求。
- 向量層處理改寫與同義問法。
- 模型輸出應經安全與新鮮度檢查後才寫入。
哪些工作負載最值得優先導入
直接答案是:結構化 FAQ、固定政策問答與高流量知識檢索,通常最容易先獲得效益。實際生產環境中的命中率可從開放式聊天的 10% 到結構化 FAQ 系統的 70% 不等,因此不能把聊天產品的結果直接套用到企業知識庫,應先分析問題重複度與答案變動速度。
精確雜湊匹配的實作成本為零,通常可以覆蓋約 18% 的真實生產流量。這層雖然不理解語意,卻能攔下重送、重新整理與前端重試等常見請求;再加上語意層,便能擴大有效覆蓋範圍,且降低向量搜尋不必要的計算與維運成本。
若每月 LLM API 支出為 $5,000,20% 的命中率每月可節省約 $1,000。這是評估的起點而非承諾值,還必須扣除 Embedding、Redis、向量索引、監控與工程時間;最值得做的產品,是節省金額、等待時間與回答一致性都能明確量化的產品。
- 優先選擇政策穩定且提問重複的流程。
- 先量測真實流量,再設定節省目標。
- 將向量與維運成本納入完整損益。
快取層級與架構:從提示詞到 KV Cache
五種常見快取各自解決不同瓶頸
直接答案是:回應快取處理已完成的答案,提示詞與前綴快取處理重複輸入,KV Cache 則減少模型解碼前的重算。它們並非互斥關係;成熟架構通常會依請求特性分層配置,讓最便宜、最安全的快取先處理,再把剩餘負載交給較昂貴的推論層。
回應快取可保存文字、JSON、引用連結與安全標記,對 FAQ 最直覺;Embedding Cache 則保存查詢向量,避免相同或正規化後相同的輸入反覆嵌入。提示詞快取適合長系統提示、共同文件前綴或重複工具定義,能減少每次送進模型的輸入 token。
KV Cache 通常位於自託管推論服務,例如 vLLM 或 GPU 叢集內部。Prefill 約占 80% 的 compute,Decode 約占 20% 的 compute,所以當大量請求共享長前綴時,前綴與 KV 快取對首個 token 的影響尤其明顯;但它需要嚴格的記憶體容量與淘汰治理。
| 快取類型 | 主要比對方式 | 適用情境 | 主要風險 |
|---|---|---|---|
| 精確回應快取 | 雜湊鍵 | 重複請求 | 覆蓋率有限 |
| 語意回應快取 | 向量相似度 | FAQ、知識問答 | 誤命中 |
| 提示詞/前綴快取 | 共同前綴 | 長系統提示 | 前綴變動 |
| KV Cache | 注意力狀態 | 自託管推論 | GPU 記憶體 |
- 回應快取:重用完整答案。
- Embedding Cache:減少向量產生次數。
- 前綴與 KV Cache:降低長上下文重算。
供應商原生快取與自建方案怎麼選
直接答案是:若工作負載高度依賴單一雲端模型,原生提示詞快取通常啟動最快;若需要跨模型、跨租戶或自訂失效邏輯,自建語意快取更有控制力。OpenAI 宣稱使用提示詞快取功能可將回應時間減少高達80%,並將成本降低50%,但實際收益仍取決於輸入是否有穩定的共同前綴。
Anthropic 宣稱使用提示詞快取功能可使成本降低高達90%,回應時間降低高達85%。這類數字可用來設定假設,卻不應直接當成企業 KPI;不同模型、提示詞長度、輸出長度與區域網路延遲都會改變結果,因此導入前應用自家請求軌跡重播測試。
自建方案可用 Redis Vector Search(7.2+)保存向量與回應,搭配 GPTCache、FastAPI、Spring AI 或 API Gateway 實作。優點是可統一 Azure、AWS、OpenAI、Anthropic、Ollama(Mistral-7B)等來源;代價是團隊要自行承擔索引維護、權限隔離、可觀測性與版本升級。
- 原生方案適合快速驗證固定供應商工作負載。
- 自建方案適合多模型與複雜治理需求。
- 任何方案都要以實際 token 與延遲測試決策。
記憶體分層是自託管推論的底線
直接答案是:KV Cache 不能只追求命中率,還必須先算清楚 GPU 記憶體餘裕。32K token context 需要 ~10 GB 的 KV cache,而现代 H100 GPU 有 80 GB 记忆体;當多使用者、多輪對話與多模型同時進入服務時,可用空間會很快被上下文狀態占滿。
因此建議將熱資料放 GPU 或 DRAM、暖資料放 Redis 或記憶體索引、冷資料放磁碟或物件儲存,並設定容量配額與淘汰策略。對話摘要、工具呼叫結果與長文件片段要有不同 TTL;否則少數超長對話可能擠掉大量高價值的短查詢快取。
快取保留時間通常以 5 分钟為起點,缓存的生命周期约为5~10分钟,在尖峰时段可能会持续长达一小时。這不是萬用設定:政策、價格、庫存與個資相關資料應採事件失效;穩定的產品說明才適合較長生命週期與 stale-while-revalidate 策略。
- 先做容量預算,再開啟長上下文快取。
- 熱、暖、冷資料採不同儲存媒介。
- TTL 必須服從資料新鮮度,而不是只看成本。
相似度門檻、快取鍵與回答品質控制
門檻不是越低命中率越好
直接答案是:相似度門檻必須以可接受的錯答風險來決定,而不是以命中率最大化為目標。常見做法是在 0.85 以上才考慮直接回應;低於此值的候選答案,可交由 LLM 重新回答、要求使用者補充,或只作為檢索參考,而不應直接把快取內容回傳。
向量搜尋會增加 5–20ms 的開銷,但在命中時能消除 1–5 秒的 LLM 往返時間。這表示門檻調整不只是品質問題,也影響延遲與成本;若分數過低造成錯答,後續客服補救與信任損失往往遠高於一次模型呼叫的費用。
實務上應保留相似度、topK 候選、是否命中、人工抽驗結果與最終解決率。尤其繁體中文、混合中英文、縮寫、錯字與口語問法的向量分布可能不同,不能照搬英文基準;應從真實工單中建立標註集,畫出 precision 與命中率的取捨曲線。
- 高風險領域採較高門檻與回退機制。
- 以人工標註集驗證繁體中文語意效果。
- 同時觀察正確率、延遲與節省金額。
快取鍵必須包含會改變答案的條件
直接答案是:安全快取鍵不應只有使用者問題,還要包含答案會受影響的上下文。建議至少納入 tenant_id、角色或權限範圍、語言、地區、知識庫版本、系統提示版本、模型版本、輸出格式與工具狀態,避免同一句問題在不同條件下拿到錯誤答案。
例如「我的訂單在哪裡」屬於個人交易資料,即使文字與另一位客戶完全相同,也絕不能共享答案;而「退貨期限」可能因商品類別與地區不同而異。將這些條件寫入 namespace 或 metadata filter,才能讓向量搜尋只在正確資料域中比對。
對結構化輸出尤其要把 schema 版本放進鍵值。若前端期待 JSON,卻取得舊版純文字回覆,可能造成程式失敗;若答案包含函式呼叫或工具參數,則應快取已驗證的結構與執行條件,而不是盲目重播可能已失效的外部操作。
- 用租戶與權限做第一層隔離。
- 將資料版本與提示詞版本視為鍵的一部分。
- JSON 與工具呼叫要分開設計快取格式。
以品質閘門避免快取污染
直接答案是:只有通過品質閘門的模型輸出才應寫入共享快取。可先檢查回答是否含有必要引用、是否符合輸出 schema、是否觸發安全政策、是否有拒答標記,以及是否使用了可快取的資料來源;未通過者仍可記錄觀測資料,但不應成為後續使用者的答案來源。
快取污染常見於提示注入、模型幻覺、錯誤文件引用與暫時性系統故障。攻擊者若能讓模型產生看似合理但錯誤的答案,再把它寫進共用快取,就可能影響大量後續請求;因此寫入權限、內容審核與快取來源追蹤都應被視為資安控制。
建議保留 answer_id、來源文件版本、產生模型、建立時間、品質分數及失效原因。出現錯誤時可精準撤銷特定答案,而不是清空整個快取;同時應為高風險意圖設置 denylist,使付款、醫療、法務與帳務異動問題永遠繞過共享語意回應。
- 快取寫入前檢查引用、安全與格式。
- 保留可追溯 metadata 以支援精準撤銷。
- 高風險意圖應明確排除共享回應快取。
從 RAG 客服到代理式 AI 的實作情境
FAQ 與 RAG 最適合建立雙層快取
直接答案是:RAG 應同時快取檢索結果與最終回答,但兩者要採不同失效規則。檢索快取保存查詢對應的文件識別碼與分數,可減少向量資料庫查詢;回應快取則保存已驗證的回答與引用,適合政策穩定、回答格式固定的 FAQ。
FAQ 可設定命中率目標為 ≥60%;一般 QA 則可先以 ≥30–50% 作為驗證假設。這些數字應依內容變動頻率調整:產品規格與流程指南可望較高,包含即時狀態、客製合約或跨部門判斷的問題,則應容許較多未命中與重新生成。
文件更新時,不宜只刪除最終答案,也應依文件 ID 失效相關檢索快取與向量回應。若刪除請求涉及個資,還需追溯向量、回應、備份與觀測紀錄的保存位置;將刪除流程設計成可稽核事件,才能避免資料雖從主庫移除卻殘留在快取。
- 檢索快取與回應快取分別管理。
- 以文件版本或事件驅動失效。
- 個資刪除必須涵蓋向量與衍生回應。
多輪對話不能只拿最後一句做比對
直接答案是:多輪對話的快取單位應是「意圖加上必要上下文」,而不是單一最後訊息。使用者說「那它可以改嗎」時,真正含義取決於前文提到的商品、方案或訂單;若只嵌入最後一句,極容易命中無關答案,造成表面流暢、實則錯誤的對話。
可將最近對話濃縮為結構化 session summary,再與當前問題共同生成向量,並把摘要版本放入快取鍵。也可限制 max-message-count=”10″,避免整段歷史無限制成長;真正需要長期記憶的資訊應保存於權限控管的資料庫,而非任由暫存快取承擔。
對話快取適合保存澄清問題、固定流程與已確認的政策說明,但不適合直接保存個人帳務結果。若快取命中內容與現有 session 的實體不一致,例如前文訂單號不同,系統應強制未命中;這類實體一致性檢查比單純提高相似度門檻更可靠。
- 使用摘要加當前問題建立上下文向量。
- 限制可參與快取比對的對話範圍。
- 以訂單、帳號等實體欄位做一致性驗證。
代理與工具呼叫要快取結果而非盲目重播
直接答案是:代理式 AI 應區分可重用的規劃資訊與不可重播的副作用操作。像「如何查詢庫存」的工具說明、已驗證的查詢意圖與公開產品摘要可快取;下單、付款、寄信、修改資料等操作則必須重新授權、重新確認參數,不能因快取命中就再次執行。
對外部 API 的唯讀結果,可快取資料快照並標示 TTL、來源時間與可用範圍;若結果包含即時價格或庫存,應以短 TTL 或事件失效控制。對串流輸出,建議快取完整且通過驗證的最終內容,而不是暫存中途 token,否則中斷連線或內容修正都可能留下不完整答案。
一個常見成本差異是:代理若重複查詢相同背景,可能叫用 LLM 三次;透過意圖、檢索與工具說明的分層快取,理想情況可只叫用 LLM 一次。前提是每一層都記錄命中來源與副作用邊界,讓工程團隊能追查為何省下呼叫、又為何仍安全。
- 可快取規劃、公開知識與唯讀查詢。
- 禁止快取重播付款、下單與資料修改。
- 串流內容應在完成驗證後才寫入快取。
效能監控、安全治理與 PoC 導入路線
用 SLI 與成本模型證明快取價值
直接答案是:快取專案要同時量測命中率、延遲、品質與成本,單看命中率會誤導決策。建議分別紀錄精確命中、語意命中、未命中、被安全規則拒絕的比例,並以 trace 串起正規化、Embedding、向量搜尋、RAG、模型呼叫與回應寫入的完整路徑。
可設定 cached ≤ 80ms、uncached ≤ 1.2s、stale_served_ratio ≤ 0.5% 等服務目標,再依產品風險調整。TTFT、總回應時間、每秒吞吐量、LLM 呼叫次數與每次請求 token 都應以快取開啟與關閉兩組基準比較,避免只看到局部加速卻忽略品質下滑。
以 token 成本估算時,缓存读取仅需$0.30/百万token,而新处理需$3.00/百万token(节省90%)可作為成本差距的示例;但企業仍要加入向量生成、儲存、網路傳輸、人力與監控費用。一般而言,通常在几周内即可达到盈亏平衡点,前提是流量重複度與快取治理成熟。
| 階段 | 核心工作 | 驗收重點 |
|---|---|---|
| 流量盤點 | 分類重複問題 | 意圖與權限分布 |
| PoC | 建置最小快取 | 品質與成本基準 |
| 試營運 | 灰度流量與告警 | 誤命中抽驗 |
| 正式運行 | 事件失效與治理 | SLO 與稽核紀錄 |
- 儀表板需分開呈現精確與語意命中。
- 以 TTFT、完整延遲與答案品質共同評估。
- 成本模型要包含快取本身的總持有成本。
多租戶與隱私必須在架構階段處理
直接答案是:多租戶語意快取的第一原則是先隔離、再搜尋。每次向量查詢都要以 tenant_id、資料分類與權限 metadata 過濾,不能先在全域索引找相似答案再判斷能否閱讀;後者可能在排序、日誌或錯誤回覆中洩漏敏感存在性資訊。
快取內容應採最小化原則,避免保存原始個資、完整提示詞或高敏感文件。若業務必須保存,應加密、設定 TTL、限制存取者並建立刪除作業;測試環境也不可直接複製正式快取。提示注入內容、惡意 URL 與未經驗證工具輸出則應標記為不可共享。
安全測試應涵蓋跨租戶相同問題、權限變更後立即查詢、文件撤銷、帳號刪除與提示注入污染等案例。只有確認快取命中與未命中都無法繞過授權,才適合擴大流量;資安團隊也應能從 answer_id 追溯來源、使用者範圍與清除紀錄。
- 向量搜尋前先套用租戶與權限過濾。
- 敏感資料採最小保存、加密與可刪除設計。
- 把攻擊測試納入上線驗收,而非事後補救。
用小規模 PoC 做出 Go/No-Go 判斷
直接答案是:導入前先以真實資料建立最小 PoC,比直接全面改造更能降低風險。ALION 的 AI PoC 開發支援會先透過現場調查與訪談定義 KPI,再以貼近實際業務的資料驗證精度、使用體驗與投資效益;即使結論是暫不開發,也能避免把預算投入錯誤方向。
PoC 可先挑選單一 FAQ 或客服意圖,建立精確快取、向量快取、門檻回退與基礎監控,再以歷史問題重播比較。測試時要標記正確命中、語意誤命中、過期回覆及權限攔阻,並由業務人員抽查答案是否真正可用,而非只看工程端的延遲數字。
若企業需要持續的上游規劃,ALION 的 AI 上游工程訂閱服務月費 20 萬日圓起,包含每週一次定期會議、需求定義、架構設計與示範製作。這種小規模起步方式有助於把快取策略、資料治理與正式系統開發銜接起來,讓 PoC 成果不只是一次性展示。
- 先選單一高重複、低風險意圖驗證。
- 以業務正確性與工程指標共同決定去留。
- 讓原型的設計、程式碼與測試資產可延續。
總結
語意快取的核心價值不只是少呼叫一次模型,而是把已驗證、可追溯、仍具時效的答案,以更低成本交付給下一位有相近需求的使用者。從精確雜湊、向量相似度、提示詞快取到 KV Cache,每層都應有清楚的適用範圍、失效條件與回退機制。
重點整理
- 先用精確快取攔截重複請求,再以向量搜尋擴大語意覆蓋。
- 相似度門檻必須以錯答風險、權限與資料新鮮度共同決定。
- RAG、代理與多輪對話需依上下文、工具副作用及文件版本設計不同快取規則。
- 以命中率、TTFT、成本、誤命中與 stale_served_ratio 建立可驗證的決策依據。
- 先做真實資料 PoC,確認可行性與投資效益後再擴大上線。
若您正在評估客服、知識庫或內部 Copilot 的效能瓶頸,建議先整理高頻問題、資料更新事件與現有模型帳單,建立可量測的最小驗證範圍。透過現場流程盤點與小規模原型,能更快確認哪些答案適合快取、哪些必須即時生成,並把效能改善轉成可供決策的數據。
常見問題 FAQ
Q1. 語意快取和 RAG 可以一起使用嗎?
可以。RAG 負責依最新知識檢索文件,語意快取則重用已驗證的檢索結果或最終答案。建議以文件版本、權限與 TTL 控制失效,避免文件更新後仍回傳舊答案。
Q2. 相似度門檻應該設多少?
可先以 0.85 作為直接回應的保守起點,再使用真實繁體中文問題建立標註集,觀察誤命中、命中率與延遲。涉及個資、付款、法務或即時資料的意圖,應提高門檻或完全不使用共享回應快取。
Q3. LLM 快取會不會洩漏不同客戶的資料?
若沒有租戶、權限與資料分類隔離,確實可能洩漏。因此查詢前就必須套用 tenant_id 與角色過濾,快取鍵也要納入會改變答案的上下文;個人交易、帳務與敏感內容不宜放入共享快取。
Q4. 有哪些可信的技術參考來源?
可參考 OpenAI 官方快取說明:https://platform.openai.com/docs/guides/prompt-caching;Anthropic 提示詞快取文件:https://docs.anthropic.com/en/docs/build-with-claude/prompt-caching;Redis 向量搜尋文件:https://redis.io/docs/latest/develop/interact/search-and-query/;以及 Microsoft Azure API Management 的語意快取文件:https://learn.microsoft.com/azure/api-management/llm-semantic-cache。
Q5. 什麼時候不應該使用語意快取?
答案高度依賴即時資料、個人身分、一次性交易狀態或具高風險決策時,不應直接重用共享答案。這類場景可快取公開模板或工具說明,但最終結果仍應重新查詢資料來源、驗證權限並由模型或規則即時生成。