2026.10.11
AI資料去識別化:企業安全訓練與稽核實戰指南
AI資訊
AI資料去識別化不是把姓名遮住就結束,而是要讓企業在保留資料分析價值的同時,降低個人被重新辨識的機率。當客服紀錄、病歷摘要、合約、影像與內部知識庫都可能成為生成式 AI 的輸入時,任何一段未處理的電話、地址或帳號資訊,都可能讓原本有價值的專案變成資安與法遵風險。
企業導入 AI 時,最常遇到的矛盾是:資料愈真實,模型通常愈有用;資料愈敏感,外洩與誤用的代價也愈高。真正成熟的作法不是一律禁止資料使用,而是先辨識直接識別碼、準識別碼與敏感欄位,再依資料目的、使用環境與風險等級選擇遮罩、一般化、代碼化或合成資料等控制措施。
本文以資料生命週期為主軸,說明 AI資料去識別化 的技術邏輯、品質驗證與重新識別風險,並延伸到AI資料治理、企業AI治理、私有化LLM部署、本地端AI部署與AI合規審計。你也會看到可直接用於 PoC 的檢核方式,協助團隊在正式開發前先取得 Go/No-Go 所需證據。
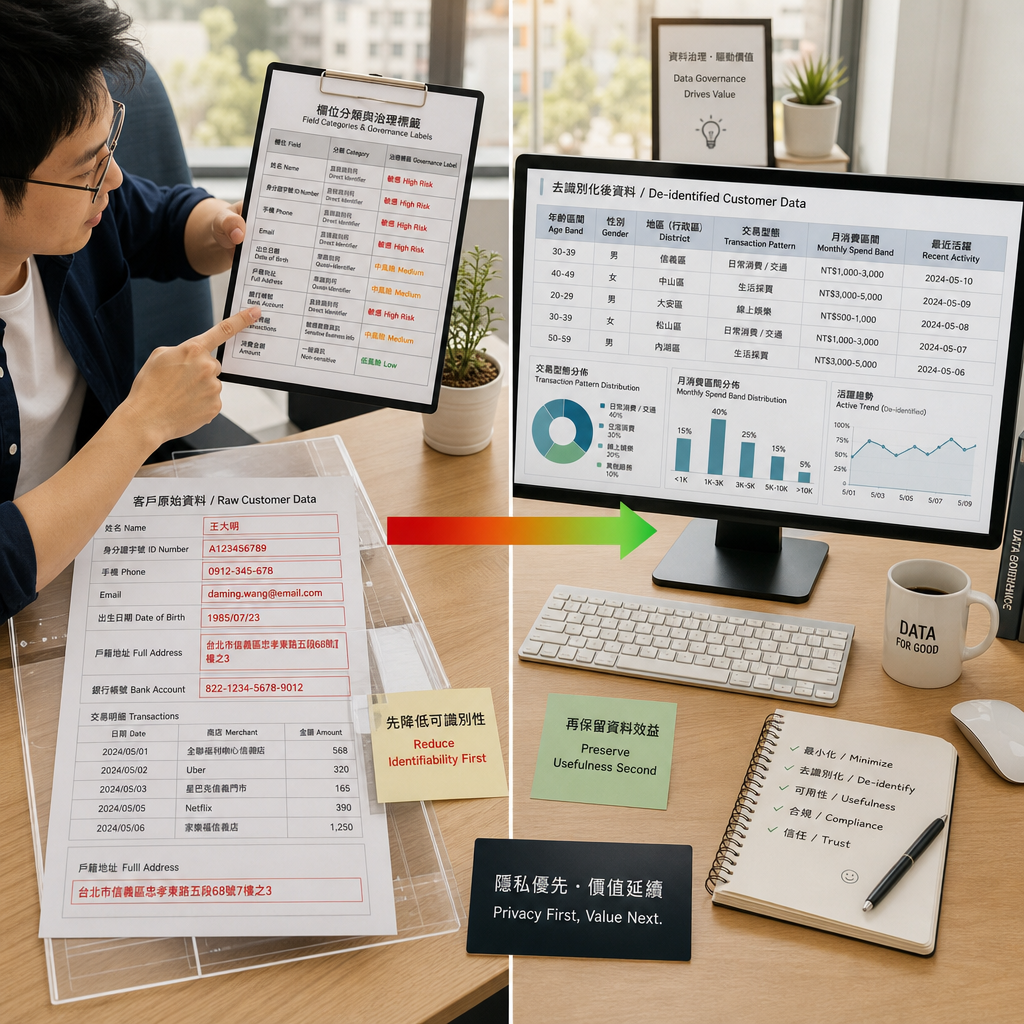
AI資料去識別化的核心:先降低可識別性,再保留可用性
辨識直接識別碼與準識別碼
直接答案是:去識別化的第一步不是選工具,而是完成資料盤點。姓名、身分證字號、電話、電子郵件、銀行帳號等屬於直接識別碼;年齡、郵遞區號、職稱、就診日期與罕見交易組合,則可能在與外部資料交叉比對後成為準識別碼。只移除姓名,並不能保證資料已經安全。
實務上,團隊應把資料欄位分為公開、內部、機敏與高度機敏四級,並標示資料來源、蒐集目的、同意依據、保存期限與可存取角色。這份欄位清冊是AI資料治理的起點,也能讓資料工程師知道哪些欄位必須遮罩,哪些欄位可以透過分群或區間化保留分析價值。
例如零售業想訓練需求預測模型,通常不需要客戶姓名與完整地址,卻可能需要區域、購買時間、商品類別與回購間隔。把生日改成年齡區間、把地址縮小為行政區,能減少可識別性;但若區間切得過粗,也可能破壞季節性或客群差異,因此必須先定義模型真正需要的特徵。
- 直接識別碼:姓名、電話、電子郵件、證件與帳戶資訊
- 準識別碼:年齡、地區、日期、職稱與罕見組合
- 敏感資訊:健康、財務、生物特徵、績效與交易內容
理解去識別化與匿名化的差異
直接答案是:去識別化不等於不可逆的匿名化。代碼化、雜湊與權杖化通常保留重新連結的可能,因此金鑰管理與權限隔離不可省略;若資料仍能透過額外資訊回推個人,企業仍應把它視為受控資料,而不是可自由流通的公開資料集。
常見的3種去識別化作法包括刪除或抑制欄位、一般化準識別碼,以及以代碼取代原始值。以年齡為例,將精確年齡改為「21歲至30歲」或「11歲至20歲」,可降低小樣本族群被鎖定的機率;但面對高齡、罕見疾病或偏遠地區資料時,仍要評估組合辨識風險。
匿名化的目標是使合理手段下的重新識別風險足夠低,但這不是單一按鈕能保證的結果。資料發布者必須考量攻擊者可能掌握的外部資料、資料更新頻率與接收者權限。即使資料經處理,若可與會員名冊、公開社群貼文或定位紀錄拼接,風險仍可能重新升高。
- 代碼化適合需要回連原始個案的受控流程
- 一般化適合統計、分群與趨勢分析資料
- 刪除欄位可降低風險,但可能損失模型訊號
為什麼生成式 AI 讓風險更複雜
直接答案是:生成式 AI 同時擴大了資料輸入、模型記憶與輸出洩漏三個面向。員工將客訴、履歷、合約或醫療摘要貼入聊天介面時,敏感資料可能已離開原本的系統邊界;即使模型不刻意保存內容,組織仍需要確認供應商設定、保留政策與日誌處理方式。
市場快速成長也讓治理不能延後處理。資料顯示,2020年全球AI相關市場規模估計為225.9億美元,前一年度的146.9億美元,成長了53.8%。企業若只追求導入速度,卻沒有把資料分類、用途限制與輸出檢查寫進流程,往往會在規模擴大後才發現權限與責任無法追溯。
模型訓練、檢索增強生成與提示詞輸入的風險並不相同。訓練資料可能造成記憶與再現問題;檢索系統則可能因權限過寬而回答不該揭露的內容;提示詞輸入則偏向即時外傳風險。企業應依場景建立不同的資料最小化規則,而不是用同一套遮罩標準處理所有資料。
- 訓練資料:重點在來源合法性、版本與記憶風險
- 檢索資料:重點在文件權限與引用範圍
- 提示詞輸入:重點在即時偵測、遮罩與外傳管控
從文字、表格到影像:選對資料去識別化技術
結構化資料適合欄位級控制
直接答案是:結構化資料最適合從欄位規則、關聯性與分布開始處理。資料庫中的客戶編號、生日、地址與交易時間通常有固定格式,團隊可用規則偵測、字典比對與資料型態驗證找出敏感欄位,再決定採取刪除、雜湊、權杖化、區間化或擾動。
K-匿名的思路是讓每筆紀錄在準識別碼組合中至少與其他紀錄相似,避免單一個案過於突出。實作時不能只看單一欄位;「年齡、地區、日期」的組合往往比其中任一欄更具辨識性。若某個分群樣本太小,可合併地區、擴大日期範圍或抑制該筆紀錄。
差分隱私則適合發布聚合統計或訓練某些分析模型時使用。它透過加入受控雜訊,降低單一個人是否出現在資料集中的影響。關鍵不是盲目加入大量雜訊,而是預先設定隱私預算、可接受誤差與業務用途;例如預測報表若要求誤差值可在5%以內,就必須同步驗證隱私與分析效能。
- 欄位規則:適合格式固定的識別資訊
- K-匿名:適合準識別碼組合風險控制
- 差分隱私:適合統計發布與受控分析
非結構化文字需要語意辨識與人工抽驗
直接答案是:處理客服紀錄、病歷摘要與合約時,不能只靠正規表示式。文字中的姓名可能有別名、錯字或上下文省略,地址也可能藏在描述句中;因此要結合命名實體辨識、規則字典、上下文模型與人工抽樣審查,才能降低漏標與誤標造成的風險。
常見的偵測類型包括 EMAIL_ADDRESS、PHONE_NUMBER、PERSON_NAME、DATE_OF_BIRTH、CREDIT_CARD_NUMBER、DRIVERS_LICENSE_NUMBER 與 PASSWORD。這些標籤可作為管線的共同語言,讓資料工程、法務與資安團隊討論的是可測量的偵測率、漏失率與誤遮罩率,而不是模糊地要求「把敏感資料清乾淨」。
雲端場景可參考 Google Cloud 的 Sensitive Data Protection 與 Cloud DLP 的概念,分別處理結構化、非結構化與影像內容。不過工具偵測結果不是最終判定;企業仍應將高風險類別送入人工覆核佇列,並保存規則版本、處理時間與例外核准紀錄,以利後續追查。
- 規則適合電話、卡號、身分證件等固定格式
- 語意模型適合姓名、地址、病況與自由文字描述
- 人工抽驗可檢查模型漏標、誤標與業務語境
影像與合成資料不能忽略背景線索
直接答案是:影像去識別化必須同時檢查臉部、車牌、螢幕畫面、文件角落與中繼資料。醫療影像、工廠監視畫面與客服截圖常在背景中保留姓名、病歷號、位置或時間戳記;只模糊主體臉部,仍可能透過制服、門牌、顯示器內容或檔案 EXIF 資訊辨識個人。
合成資料可在不直接發放原始個資的前提下,保留部分統計關係供開發與測試使用;但合成不代表天然安全。若生成器過度記憶少數樣本,或原始資料本身品質偏差,合成資料仍可能洩漏罕見個案特徵,並將偏見帶入後續模型。
部分去識別化工具採用Apache 2.0授權,便於企業檢視原始碼、調整規則與納入內部流程。不過採用開源元件時,仍需進行授權盤點、版本弱點管理與測試資料隔離。尤其當遮罩引擎串接文件儲存、OCR 或模型服務時,資料流向與日誌內容都必須納入安全設計。
- 影像:檢查臉部、車牌、文字、背景與中繼資料
- 合成資料:檢查記憶風險、統計偏差與用途限制
- 開源工具:檢查授權、版本、弱點與供應鏈風險
用AI資料治理讓去識別化成為可持續的日常控制
建立資料血緣與責任分工
直接答案是:AI資料治理必須回答每一份資料從哪裡來、誰能使用、能用在哪裡,以及何時應該刪除。企業應為訓練資料、特徵資料、提示詞紀錄、向量索引與模型輸出建立資料目錄,記錄資料擁有者、敏感等級、去識別化版本、保存位置與下游系統。
角色分工建議至少包含資料擁有者、資料管理員、資料工程師、資安人員、法遵代表與業務產品負責人。資料擁有者決定業務用途與品質門檻;工程團隊落實轉換與存取控制;資安與法遵團隊驗證控制是否足以支撐風險判斷。責任清楚,才能避免所有人都以為別人已經審查。
治理重要性已有明確訊號:在 2024 年對 350 個資料長和資料長同級角色進行的調查中,MIT CDOIQ 發現 45% 的資料長將資料治理視為首要考量。這項結果反映企業不再只把資料當成模型燃料,而是視為需要品質、權限、血緣與責任制度共同維護的長期資產。
- 資料目錄:找得到資料、用途、擁有者與敏感等級
- 資料血緣:追得到轉換規則、版本與下游使用處
- 責任矩陣:分清核准、執行、監督與例外處理角色
把資料品質與隱私風險一起量測
直接答案是:去識別化品質不能只看遮罩成功率,也要看資料是否仍可完成原本任務。若模型需要辨識不同地區的需求波動,地區一般化後仍應保留足夠的區辨度;若文件摘要要提供客服知識,遮罩後的段落也必須維持語意完整,否則系統即使安全也無法被現場採用。
建議同時建立隱私指標與效用指標。隱私面可追蹤敏感欄位偵測率、抽樣漏標率、K-匿名群組大小、重新識別測試結果與例外數量;效用面則可追蹤模型準確度、召回率、人工處理時間與使用者完成任務的成功率。兩組指標應在同一份報告中呈現。
偏見檢查也屬於資料品質控制的一部分。若某些年齡、地區、語言或職務群體在去識別化後被大量刪除,模型可能對這些族群表現較差。企業應保留受控的分群統計,確認資料轉換沒有意外改變母體結構,並把偏差改善措施納入版本紀錄。
- 隱私指標:漏標率、重新識別風險與例外數量
- 效用指標:模型品質、作業時間與任務成功率
- 公平性指標:不同群體的資料保留率與模型表現
以最小權限防止資料在流程中擴散
直接答案是:即使資料已去識別化,仍應採取最小權限與分層防護。資料工程人員不一定需要看原始身分欄位,模型開發者也不一定需要下載整份資料集;透過角色權限、短期憑證、網段隔離、加密與下載限制,可以減少內部誤用或帳號遭入侵後的影響範圍。
對生成式 AI 而言,權限控制必須延伸到檢索內容與輸出內容。向量資料庫若只依文件集合授權,卻沒有依使用者身分過濾,模型就可能回答跨部門機密。較穩健的設計是將來源文件權限同步到索引層,並在檢索、生成與回應交付前各做一次政策檢查。
企業AI治理不應只在專案立案時審一次。資料來源變更、模型版本更新、外部供應商調整、提示詞模板新增或使用人數擴大,都可能改變風險。建立定期權限複核、異常查詢告警與例外到期機制,才能讓控制措施跟得上實際營運,而不是停留在文件上。
- 最小權限:依角色、用途與時間限制資料存取
- 分層檢查:輸入、檢索、生成與輸出各自驗證
- 持續複核:針對版本、供應商與權限異動重評風險
私有化LLM部署與本地端AI部署如何守住資料邊界
先用資料流決定部署位置
直接答案是:私有化LLM部署是否必要,應由資料敏感度、延遲需求、模型能力、維運資源與跨境限制共同決定,而不是因為「私有」聽起來較安全。若工作內容涉及大量個資、研發機密、金融交易或醫療文件,將推論環境與資料儲存放在企業可控邊界內,通常更容易落實存取、留存與稽核要求。
本地端AI部署的優點是資料不必因每次推論離開內部網路,也較容易與既有身分管理、資料庫權限與安全監控整合。但它不會自動消除風險:模型權重、容器映像、GPU 伺服器、管理介面與備份媒體都可能成為攻擊面,因此仍需修補管理、金鑰保護與網路分段。
混合架構也很常見,例如在內部完成敏感資料偵測與去識別化,再將低風險內容送到外部模型;或將向量索引留在內網,僅把最小必要片段交給受控推論服務。重點是把資料流畫清楚,並讓每一個跨出信任邊界的節點都有明確的政策與紀錄。
| 項目 | 私有化LLM部署 | 本地端AI部署 | 受控外部服務 |
|---|---|---|---|
| 資料邊界 | 專屬租戶或隔離環境 | 企業內部網路 | 供應商雲端環境 |
| 維運責任 | 企業與服務商共管 | 企業自主管理 | 供應商為主 |
| 敏感資料適配 | 高 | 高 | 視契約與設定 |
| 擴充彈性 | 中至高 | 受硬體限制 | 高 |
- 高度敏感資料:優先評估受控內網或專屬環境
- 一般性內容:可評估受契約與設定約束的外部服務
- 混合模式:先去識別化,再依風險分流至不同模型
在模型前後設置去識別化閘門
直接答案是:不論模型放在哪裡,都應在輸入前與輸出後建立政策閘門。輸入閘門負責偵測個資、機密詞彙、憑證與敏感附件,並依規則遮罩、代碼化、阻擋或要求使用者確認;輸出閘門則檢查模型是否重述受限資訊、洩漏提示詞內容,或產生不符合權限的回答。
對內部知識問答系統來說,去識別化不應破壞必要的業務脈絡。較好的方式是以一致代碼取代姓名,例如將同一客戶映射為固定代號,讓模型仍能理解案件前後關係;映射表應與語料分離保存,並僅允許有正當業務需求的人員在受控環境中查詢。
若企業正規劃模型客製化,應先釐清訓練、微調與檢索三種資料路徑的差異。可搭配閱讀AI模型微調平台怎麼選?企業從資料準備、實驗追蹤到部署治理的評估指南,把資料集版本、實驗紀錄、權限模型與部署驗收放在同一套管理框架下。
- 輸入閘門:偵測、遮罩、阻擋與使用者提示
- 映射分離:語料代碼化,對照表獨立保管
- 輸出閘門:檢查越權內容、敏感回顯與不當生成
日誌、監控與備份也可能含有個資
直接答案是:部署完成後最容易被忽略的,是日誌與備份中的敏感資料。除錯紀錄可能保留完整提示詞、模型回應、文件片段、帳號識別碼與 IP 位址;若團隊只保護主資料庫,卻任由日誌被廣泛存取,去識別化的成效就可能在營運階段被抵銷。
建議為應用日誌建立欄位級遮罩規則,禁止記錄密碼、權杖、完整證件號碼與未處理原文;同時設定保留期限、加密、存取審批與查詢稽核。對必要的除錯案例,可採抽樣、代碼化與受限調閱,避免把大量真實對話直接複製到工單或協作平台。
模型效能監控也要兼顧隱私。團隊可蒐集延遲、錯誤率、拒答率、敏感資訊攔截數與資料漂移指標,而非永久保存原始對話。當確實需要調查事件時,應透過案件編號、雙人核准與有限時效解封,讓調閱本身也留下可查核的紀錄。
- 日誌最小化:避免保存完整原文與秘密資訊
- 受控除錯:抽樣、代碼化、核准與到期清除
- 隱私監控:以聚合指標取代長期保存原始內容
將AI合規審計與 PoC 驗證納入企業AI治理
用系統盤點建立可稽核範圍
直接答案是:AI合規審計應從完整的系統盤點開始,而不是等事件發生才找文件。盤點範圍要包括自建模型、外部 API、聊天工具、RAG 應用、OCR、預測系統與員工自行使用的影子 AI。每個系統至少要記錄用途、資料類型、模型供應商、部署位置、使用者、風險等級與人類覆核方式。
高風險用途需要更嚴格的文件與控制。歐盟 AI 規則的罰則可達 up to €35 million or 7% of total worldwide annual turnover;其他違規類型可能為 €15 million or 3%,或€7.5 million or 1%。即使企業主要營運不在歐盟,若服務涉及相關市場或合作夥伴,也應及早確認適用性。
審計證據不只包含政策文件,還應包含資料來源核准、去識別化規則版本、測試結果、權限清單、模型卡、提示詞模板、事件紀錄與變更紀錄。當稽核人員追問「為何能用這份資料、誰批准、何時變更」時,團隊必須能從資料血緣與日誌快速提出可驗證答案。
- 系統盤點:辨識正式系統與影子 AI
- 風險分級:依資料、用途、影響與自動化程度判定
- 證據矩陣:把控制措施對應到可提出的紀錄
驗證模型、資料與人類監督是否有效
直接答案是:合規不是完成一次測試,而是要在模型與資料變動後持續驗證。AI合規審計應測試敏感資料攔截、重新識別風險、提示詞注入防護、權限繞過、幻覺、偏見與模型漂移。測試案例要涵蓋正常流程、惡意輸入、邊界資料與例外情境,並留下可重現的測試條件。
在安全關鍵決策中,人類不能只是形式上的簽核者。產業控制要求明確寫出 100% Human-in-the-Loop Required for Safety-Critical AI Decisions,代表人員必須有足夠資訊、權限與時間挑戰模型建議。若系統只讓人員快速按下確認,卻沒有顯示來源、信心程度與替代方案,實際上仍是把風險外包給演算法。
製程安全領域尤其需要嚴謹的紀錄。OSHA 1910.119 PSM 相關工作不能只看模型預測準確率,也要確認變更管理、警示處理、人工覆核與紀錄留存是否完整。資料顯示,73% of oil & gas facilities report AI-related compliance gaps within first year of deployment,顯示上線後的控制落差相當常見。
- 資料測試:偵測率、漏標率、重新識別與資料漂移
- 模型測試:效能、偏差、幻覺、注入與越權回應
- 人類監督:具備覆核資訊、否決權與處理紀錄
以小規模 PoC 取得投資與風險證據
直接答案是:在正式擴大導入前,以受控資料集進行 PoC,是驗證去識別化與模型可用性的有效方法。PoC 不應只展示聊天介面,而要事先設定 KPI,例如敏感資訊偵測率、人工覆核時間、模型任務成功率、重新識別測試門檻與使用者滿意度,並清楚界定哪些資料與功能不納入測試。
ALION 的 AI PoC 開發支援採取「現場調查、最小配置、實際資料驗證」的方式,先釐清業務流程與資料前提,再以原型測試可行性及效益。其 AI 上游工程訂閱服務為月費 20 萬日圓起,可協助需求定義、架構設計與示範製作;若進入正式開發,相關費用可依方案自正式預算扣抵。
PoC 的價值也包括做出不做的判斷。對高風險製程而言,$2.4M+ Average cost of an OSHA PSM violation finding at a process facility,遠高於事前驗證控制設計的成本。企業應把 PoC 報告做成投資決策文件,清楚呈現資料限制、風險缺口、預期效益、維運責任與 Go/No-Go 建議,而非只提交展示成果。
| 步驟 | 主要工作 | 關鍵產出 |
|---|---|---|
| 1. 目標設定 | 界定場景與 KPI | 驗收基準 |
| 2. 資料盤點 | 分類與風險評估 | 欄位清冊 |
| 3. 原型驗證 | 轉換、模型與抽驗 | 測試報告 |
| 4. 投資判斷 | 效益與缺口整理 | Go/No-Go 建議 |
- 先定 KPI:隱私、效用、效率與使用體驗同時衡量
- 最小範圍:使用受控資料與明確排除項目
- 決策文件:呈現缺口、成本、責任與 Go/No-Go 建議
總結
AI資料去識別化的關鍵,不是找到一個能自動遮罩的工具,而是把資料盤點、風險分級、轉換規則、可用性測試、權限管理與稽核證據串成完整流程。當企業將去識別化納入AI資料治理與企業AI治理,私有化LLM部署或本地端AI部署才能真正成為可控的資料使用環境,而不是另一個難以追蹤的風險來源。
重點整理
- 先辨識直接識別碼、準識別碼與敏感資料的組合風險。
- 同時量測隱私風險與資料可用性,避免安全與效益二選一。
- 將去識別化規則、權限、版本與例外處理納入可追溯的治理機制。
- 針對高敏感場景,在模型輸入、檢索、輸出、日誌與備份都設置控制點。
- 先以小規模 PoC 驗證資料、模型與現場流程,再決定是否擴大投資。
若你的團隊已經有 AI 應用構想,卻不確定現有資料能否安全使用,建議先從一個高價值、範圍明確的流程開始盤點。透過受控 PoC 同步驗證去識別化品質、模型效用與現場使用情境,能比直接投入正式系統更早看見風險與效益,讓後續決策更有依據。
常見問題 FAQ
Q1. AI資料去識別化後,資料還需要受到保護嗎?
需要。去識別化降低的是可識別性與誤用風險,不代表資料可無限制公開。只要仍存在映射表、外部資料拼接可能、商業機密或敏感推論風險,就應維持權限控管、加密、日誌與用途限制。
Q2. 去識別化資料可以直接拿來訓練 LLM 嗎?
不建議直接視為零風險。應先確認原始蒐集目的、使用同意、資料品質、重新識別風險與模型輸出測試結果;若是高敏感資料,也要評估採用私有化LLM部署、本地端AI部署或受控混合架構。
Q3. 如何開始做 AI合規審計?
先建立 AI 系統清冊,再依資料敏感度、決策影響與部署方式分級,蒐集資料血緣、權限、模型版本、測試結果與事件日誌。可參考 NIST AI RMF:https://www.nist.gov/itl/ai-risk-management-framework;EU AI Act 官方頁面:https://artificialintelligenceact.eu/;Google Sensitive Data Protection 文件:https://cloud.google.com/sensitive-data-protection/docs;ISO/IEC 42001 概覽:https://www.iso.org/standard/81230.html。
Q4. PoC 階段應使用真實資料還是測試資料?
兩者都可,但應依風險採分層策略。先以合成或嚴格去識別化資料驗證技術路徑,再於簽署保密協議、限制存取與保留期限的受控環境中,以最小必要真實資料驗證正式情境的效果。
Q5. 本地端AI部署是否一定比雲端安全?
不一定。本地端可強化資料邊界與整合既有權限,但仍要自行承擔硬體修補、模型供應鏈、備份、日誌與帳號管理責任。安全性取決於控制措施是否完整,而非單純取決於部署位置。