2026.09.25
RAG引用表示で根拠が伝わる回答を設計する
IT関連
RAG引用表示は、生成AIの回答に「なぜそう答えたのか」を示す根拠を添える仕組みです。回答文だけでは正誤を確認できない社内規程や契約、製品情報の検索で、利用者が原典へ戻れることが信頼の出発点になります。
RAGは検索・拡張・生成を組み合わせ、最新の外部知識を参照して回答します。しかし、検索結果が正しくても、引用箇所と主張が対応しなければ誤引用になります。表示設計、検索品質、権限、継続評価を一体で設計する必要があります。
本記事では、引用の見せ方からRAG構築、RAGチャンク設計、ベクトル検索RAGの改善、RAG評価指標、RAGアクセス制御までを解説します。受入時に確認すべき観点はAI受入テストの実践ガイドもあわせて参照してください。
RAG引用表示とは何か、最初に決めるべきこと
引用表示は回答の検証経路をつくる
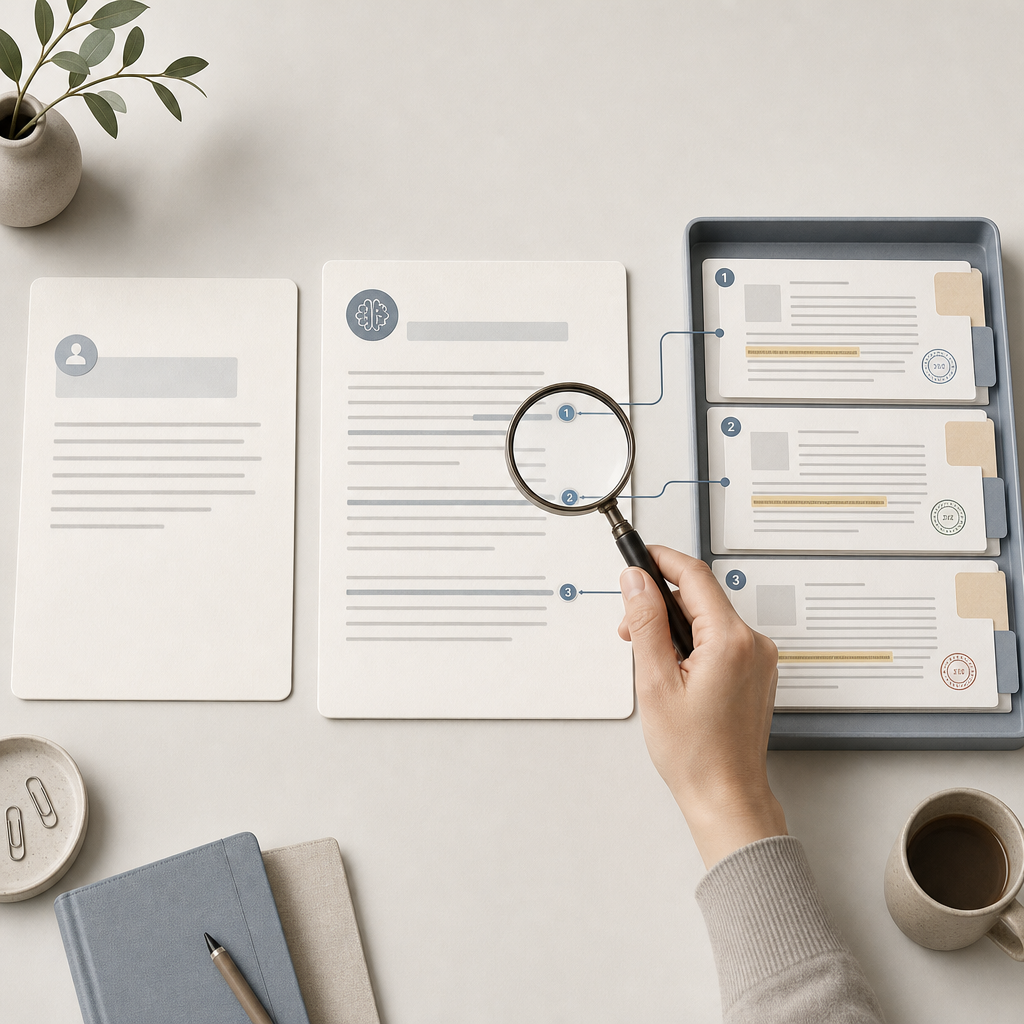
RAG引用表示の目的は、もっともらしい文章を増やすことではなく、回答の検証経路を短くすることです。利用者は回答内の引用番号やリンクを開き、文書名、該当箇所、更新日時を確認できるため、AIの結論を業務判断に使いやすくなります。
基本フローは、質問を受け、関連チャンクを検索し、その内容をプロンプトに拡張して回答を生成し、使った根拠を返す流れです。画面には「1つ目:ユーザからの質問」「2つ目:生成された回答」「3つ目:参考とした情報のパス」を分けて保持すると、障害調査もしやすくなります。
引用は検索上位の文書一覧ではありません。回答中の主張ごとに、その主張を直接裏付ける文節を紐付ける設計が必要です。根拠のない推測には引用を付けず、回答不能として返す方針を明示することが、ハルシネーション対策の基本になります。
- 回答文の主張と引用箇所を一対一または一対多で対応付ける
- 文書名・版・更新日時・見出し・参照位置を返す
- 根拠不足時は推測せず、未回答理由を表示する
利用場面に応じて引用UIを選ぶ
最も実務で使いやすい引用UIは、短い回答にはインライン引用、調査業務には詳細パネルを組み合わせる方式です。回答末尾にURLだけを並べると、どの記述の根拠か分からず、確認負荷が残ります。
インライン引用は「規程の申請期限は5営業日です[1]」のように主張の直後へ置く方法です。短時間で真偽を確認したいFAQに適します。一方、脚注やサイドパネルは、複数資料の比較、長い規程、版差分の確認に向きます。
引用を開いた際は、原文の該当段落をハイライトし、前後の文脈も見せます。文書内検索だけに頼ると、同じ語が多い規程では誤った位置に到達しがちです。参照箇所のアンカーやページ番号も保存しておくと、確認が速くなります。
| 方式 | 主な利点 | 適した利用場面 |
|---|---|---|
| インライン引用 | 主張との対応 | FAQ・短文回答 |
| 脚注 | 一覧性 | 報告書・要約 |
| サイドパネル | 属性確認 | 規程・契約調査 |
| 原文ハイライト | 位置確認 | 長文PDF・手順書 |
- インライン引用:回答の主張との対応を優先
- サイドパネル:文書属性と周辺文脈の確認を優先
- 原文ハイライト:引用位置の再発見を不要にする
引用の失敗を分類して先に防ぐ
引用の品質は、欠落・誤引用・旧版引用・権限外引用の4種類に分けて確認すると改善しやすくなります。引用が存在するだけでは十分ではなく、回答を本当に支持しているかという「含意」の検証が不可欠です。
たとえば、旧版マニュアルが最新仕様を示すように引用されると、回答は文章として自然でも業務上は誤りです。文書IDだけでなく、版番号、有効開始日、失効状態をメタデータに持たせ、検索時に旧版を除外します。
複数文書の記述が矛盾する場合は、片方を黙って採用しないことが重要です。引用表示で差異を示し、優先ルールに従った回答であること、または担当部門への確認が必要であることを利用者へ伝えます。
- 引用欠落:回答の根拠が画面にない
- 誤引用:表示された原文が主張を支持しない
- 旧版引用:失効済みまたは古い版を参照する
- 権限外引用:閲覧できない文書の情報を示す
根拠を返せるRAG構築の基盤を整える
RAG構築は文書の原形を失わないことが第一歩
RAG構築では、文書を集める前に、回答対象・未回答方針・引用要件を定義することが重要です。PDF、表、画像、スキャン文書を単なるテキストへ変換すると、見出し階層や表の列関係が消え、引用しても意味を確認できない状態になり得ます。
取り込み時には、文書名、所有部門、版、更新日時、アクセス権、ページ、見出しをチャンクへ継承します。引用画面で必要になる属性を後から復元することは難しいため、インデックス設計とUI設計は同じ要件定義で決めます。
実装の選択肢にはLangChain、LlamaIndex、Pinecone、Weaviate、Chroma、Milvusがあります。小規模な検証ではAPI利用料が数千円程度でも始められますが、本番化では検索量、同時接続、再ランキング、監査ログを含めて見積もるべきです。
- 原文、抽出テキスト、チャンク、索引を追跡可能にする
- 文書の所有者と更新責任者を明確にする
- 引用に必要なページ・見出し・版情報を保存する
RAGチャンク設計は引用の読める単位で分ける
RAGチャンク設計では、検索精度だけでなく、利用者が引用として読める完結性を優先します。例えば、1万文字のマニュアルを、500文字ごとのブロックに切り分けるような作業です。ただし見出し途中や表の途中で切ると、根拠の意味が壊れます。
一般的には、500〜1000文字程度のチャンクに分割することが多いです。まずは512〜1024トークンは一つの目安として、見出し、段落、手順、表の行群を単位に調整します。日本語の型番や単位は分断されないよう、専用の分割規則を追加します。
文脈の連続性が必要なら、例えば、500文字のチャンクに対し、前後の50〜100文字程度を重複させて保存します。重複を増やし過ぎると似た引用が並び、LLMへ渡すトークンと費用が増えるため、評価セットで最小量を選びます。
- 見出しと本文を同じチャンクに残す
- 表は列見出しとデータ行の対応を保持する
- チャンクごとに原文位置と親文書IDを記録する
ベクトル検索RAGは語句検索と組み合わせる
ベクトル検索RAGでは、意味の近さだけに頼らず、キーワード検索とのハイブリッド検索を採用すると安定します。ベクトル検索は言い換えに強い一方、製品コード、型番、規程番号、固有の略語では完全一致検索が有利になるためです。
候補取得では、例えばベクトル検索で少し多めに(例えば20件〜50件)候補を取得します。その後、キーワード一致、更新日、部門、権限、質問との関連性で再ランキングし、通常は上位5〜10件を質問とともにLLMへ渡します。
検索候補が数十件なら埋もれなかったものが、数千件になると「似ているが正しくない文書」が上位を占めるようになることがあります。検索ログにクエリ、候補、採用引用、クリック結果を残し、語彙辞書とメタデータフィルタを継続的に見直します。
- 意味検索:言い換えや自然文の質問に対応
- キーワード検索:型番・条項番号・固有語に対応
- 再ランキング:引用として使う根拠を絞り込む
RAG精度改善で引用と回答のずれを減らす
RAG精度改善は検索と生成を分けて診断する
RAG精度改善では、検索失敗と生成失敗を同じ問題として扱わないことが最短の改善策です。正しい根拠が上位にないなら、プロンプトを調整しても引用は正しくなりません。逆に根拠があるのに誤答するなら、指示や出力制約を見直します。
検索失敗は、チャンク境界、OCR誤り、表記揺れ、同義語、古い版、メタデータ不足で起きます。生成失敗は、複数根拠の取り違え、根拠を超えた推論、引用と文の対応漏れで起きます。失敗クエリを分類し、施策を一つずつ変えることが大切です。
実務では「原因を5つに分けて、改善の打ち手まで整理します。」という粒度で担当を分けると、対策が曖昧になりません。検索、再ランキング、プロンプト、引用抽出、データ更新の責任境界を明確にし、変更前後を同一セットで比べます。
- 検索評価:正解文書が候補に入ったかを測る
- 生成評価:回答が根拠に忠実かを測る
- 引用評価:主張と出典の対応を人手で確認する
改善効果は業務指標と一緒に測る
引用付きRAGの価値は正答率だけでなく、確認時間と自己解決率で判断します。ある導入例では、導入前比で約65%減少、約80%短縮、問い合わせの約70%をAIが自己完結で対応という成果が示されています。対象業務と測定条件を分けて解釈することが必要です。
別の改善例では、初動調査が平均2.5時間から1.5時間に改善し、調査時間を約40%短縮しました。回答を速くしても原典への到達が遅ければ効果は限定的なため、引用クリックから該当箇所を開くまでの時間も観測します。
見積確認工数が約30%削減しました、一次回答の作成が平均20分から13分となり、処理時間を約35%短縮しました、転記ミスが約50%削減しましたという結果もあります。こうした改善は、回答の採用率と引用確認のしやすさを併せて検証して初めて再現できます。
- 問い合わせ件数だけでなく自己完結率を追う
- 回答作成時間と原典確認時間を分けて測る
- 誤引用による差し戻し件数を継続監視する
根拠がないときに答えない設計を入れる
高品質なRAGは、答えられる範囲を広げるより、根拠がない質問に安全に答えないことを優先します。引用が1件も得られない、候補間で矛盾する、質問の条件が曖昧な場合は、追加質問や担当窓口への誘導を返します。
「手戻り30%削減へ」を目標にする場合も、無理な自動回答は逆効果です。回答文には「参照資料に記載がない」「対象製品・期間を指定してください」といった定型を持たせ、根拠不足を隠さない運用にします。
RAG構築の段階から、回答可能な質問、禁止する判断、承認が必要な回答を分類します。特に法務、人事、医療に近い領域では、引用があっても最終判断をAIへ委ねない文言と、エスカレーション先を画面上に表示します。
- 最低関連度と最低引用数のしきい値を定める
- 矛盾資料がある場合は断定しない
- 未回答ログを次回の文書整備と評価へ回す
RAG評価指標で引用品質を受入基準にする
RAG評価指標は検索・回答・引用の三層で測る
RAG評価指標は、検索、生成、引用体験の三層を分けると、改善箇所を特定できます。検索ではRecall@K、MRR、nDCG、Precisionを用い、正解根拠が上位候補に入ったかを確認します。回答の流暢さだけで合格にしないことが重要です。
生成ではFaithfulness、回答正確性、未回答の適切さを見ます。Faithfulnessは、回答が与えられたコンテキストから逸脱していないかを測る観点です。引用では、主張単位の裏付け率、誤引用率、引用元到達率、引用クリック率を追います。
評価クエリ100〜1,000件・週次を一つの運用目安にし、質問種別を偏らせないようにします。単一事実、複数条件、比較、手順、曖昧質問、回答不能質問を含めると、日常利用に近い品質を確認できます。
- Recall@K:正解根拠を候補へ出せた割合
- Faithfulness:根拠から逸脱しない回答の割合
- 引用元到達率:利用者が原典を開けた割合
受入テストでは主張単位で引用を照合する
受入テストでは、回答全体ではなく、一文ごとの主張と引用原文を照合するべきです。テスターは、主張が原文に明記されているか、条件や例外を落としていないか、別文書の内容を混ぜていないかを確認します。
テストケースには質問、期待する根拠文書、許容する回答範囲、禁止表現、必要な引用属性を記録します。引用先のリンクが開くこと、該当箇所が表示されること、閲覧権限がない利用者に情報が出ないことまで確認対象に含めます。
品質基準の作り方やテストケースの詳細は、AI受入テストの実践ガイドで確認できます。本番ログで見つかった誤引用も匿名化して評価セットへ加え、回帰を防ぐ資産に変えることが重要です。
- 主張ごとに根拠の明記・条件・例外を照合する
- リンク先、ハイライト、文書属性の表示を検証する
- 修正済みの失敗例を回帰テストへ追加する
速度と費用を品質の副作用として監視する
精度施策は、レイテンシと費用を悪化させる可能性があるため、品質指標と同時に監視します。候補数の増加、再ランキング、長いチャンク、複数モデル判定は根拠の取りこぼしを減らせますが、応答を遅くしやすい施策です。
運用監視ではレイテンシP50・P95・P99(ms/1分〜5分窓)を記録します。利用者の画面では数秒〜十数秒の待ち時間が発生することがあります。引用の追加表示だけでなく、検索、生成、権限フィルタの各時間を分解して監視します。
埋め込みや検索にかかる単価も、文書更新頻度と一緒に確認します。たとえば100万トークンあたり$0.15という料金条件では、無制限の再インデックスより差分更新が有利です。費用を下げるために引用根拠を省略するのではなく、不要な処理を削減します。
- P50は通常時、P95・P99は遅延時の体験を示す
- 検索・権限・生成・引用整形を個別に計測する
- 更新量と単価から月額費用を試算する
RAGアクセス制御とRAG運用で信頼を維持する
RAGアクセス制御は検索前に適用する
RAGアクセス制御は、回答を生成した後に隠すのではなく、検索候補を取得する段階で適用します。検索後に表示だけを制限すると、権限外の文章がLLMの文脈に入り、要約や言い換えを通じて漏えいする危険が残ります。
チャンクには部署、役割、テナント、機密区分、文書所有者、有効期限を持たせ、ログイン利用者の属性でフィルタします。親文書の権限を子チャンクへ確実に継承し、文書移管や権限変更時には索引側も更新します。
引用表示にも同じ判定が必要です。回答を閲覧できても、添付資料の原文を開けない設計では確認できません。反対に、原文を開けないユーザーに要約だけを見せる場合は、その可否を情報分類ごとに明文化します。
- 権限フィルタはベクトル検索のクエリ条件へ組み込む
- 文書削除・異動・組織改編を索引更新へ反映する
- 回答、引用、原文閲覧で一貫した権限判定を行う
RAG運用は更新・削除・版管理を止めない
RAG運用では、文書を登録する仕組みより、更新・削除・ロールバックを確実にする仕組みが重要です。更新頻度をどう設計するか(リアルタイム、1日1回、週1回など)は、業務要件とコストのバランスで決定します。
更新時は、旧版を残すなら検索対象外の状態を明示し、新版との関連を記録します。失効した規程を削除せず検索対象に残すと、引用UIが正しくても誤案内になります。差分更新の失敗時に前の索引へ戻せる手順も必要です。
ALION株式会社のように専属チームで伴走する開発では、現場部門が文書オーナーとなり、開発側が取り込み監視と評価を担う分担が有効です。運用会議では、未回答、誤引用、権限エラー、遅延、利用率を同じ台帳で確認します。
- 文書の追加・更新・失効・削除を状態管理する
- 差分更新の成否と索引バージョンを監査ログに残す
- 業務部門と開発部門で修正責任を分ける
引用ログを改善サイクルへ戻す
引用ログは、利用者がどの回答を信頼できなかったかを知るための一次情報です。回答の採用・修正・再質問、引用クリック、引用先での離脱、低評価を匿名化して集計すると、検索品質とUI品質のどちらを直すべきか判断できます。
たとえば引用クリック率が低い場合、回答自体が十分である可能性も、引用ラベルが目立たない可能性もあります。一方で引用元到達率が低ければ、リンク切れ、権限エラー、アンカー不備、長文で該当箇所が見つからない問題を疑います。
改善は一度に複数施策を入れず、チャンク、検索方式、top-k、再ランキング、表示UIを順番に変更します。RAG運用を継続するほど、実利用の失敗が評価セットへ蓄積され、RAG精度改善と引用体験の両方を再現性高く進められます。
- 回答評価と引用クリックを同じリクエストIDで追跡する
- 権限エラーとリンクエラーを品質障害として扱う
- 失敗ログをラベル付けして評価セットへ追加する
まとめ
RAG引用表示は、回答の末尾に出典を置くだけの機能ではありません。読める単位のチャンク、適切な検索、主張単位の検証、権限フィルタ、文書更新、継続評価がそろって初めて、利用者がAIの回答を確かめながら使える仕組みになります。
要点
- 引用は主張ごとに原文の該当箇所へ結び付ける
- 検索評価・生成評価・引用評価を分離して測る
- RAGアクセス制御は検索前から適用し、引用にも一貫させる
- 更新・削除・誤引用ログをRAG運用の標準手順に組み込む
- 受入時は回答の正しさだけでなく、根拠への到達性を確認する
まずは頻出質問から評価セットを作り、回答、引用、原文遷移、権限の4点を確認してください。小さな対象業務で検証結果を蓄積し、根拠を示せる範囲から段階的にRAGを展開することが、信頼されるAI導入への近道です。
よくある質問
Q1. RAG引用表示があれば、AIの回答は必ず正しいですか?
いいえ。引用があっても、原文が主張を支持していない誤引用や、古い文書の引用は起こり得ます。主張単位で原文を照合し、版と更新日を確認できる設計が必要です。
Q2. RAG引用表示では、どの情報を出典として表示すべきですか?
最低限、文書名、該当見出しまたはページ、原文の該当箇所、版または更新日時を示します。利用者が原典を開ける権限を持つ場合は、直接リンクとハイライトも提供します。
Q3. RAGアクセス制御はなぜ検索前に必要ですか?
検索後に画面だけ隠しても、権限外の文章がLLMへ渡り、回答に混ざる可能性があるためです。利用者属性で検索候補を絞り、その同じ判定を引用と原文閲覧にも適用します。
Q4. 引用付きRAGの品質は何から測ればよいですか?
まず、正解根拠が検索候補に入るか、回答が根拠に忠実か、引用リンクで原文の該当箇所へ到達できるかを分けて測定します。誤引用と未回答の適切さも評価対象にしてください。
Q5. RAGチャンク設計で最初に試すサイズはありますか?
文書構造を保てるなら、512〜1024トークンを初期目安にできます。ただし、手順書、表、契約条項では見出しや条件文が分断されないことを優先し、実際の評価結果で調整します。
参考文献・出典
[内容をスキップ](#content) * [TOP](https://www.kagoya.jp/howto/) * [IT用語の部屋](https://www.kagoya.jp/howto/category/it-glossary/) +…
www.kagoya.jp
 [料金](/price) [議事録作成](/function-meeting-minutes)…
taskhub.jp
  # RAGとは?社内文書を学習させるAIの作り方 ### この記事について…
corp.sai-labs.co.jp