2026.09.18
RAGアクセス制御で守る社内ナレッジ設計
IT関連
RAGアクセス制御は、生成AIに社内文書を読ませる際の「見せてよい情報だけを回答に使わせる」ための仕組みです。ファイル共有の閲覧権限があっても、検索用インデックスで権限が失われれば、回答文から機密情報が漏れる危険があります。
RAGは、社内規程、製品資料、議事録などを検索し、関連情報をLLMへ渡して回答を生成します。しかし、従来の検索システムと異なり、検索結果が自然文として再構成されるため、権限境界、引用範囲、出力内容まで一貫して守る設計が必要です。
本記事では、RAG構築時の認可モデル、検索と生成の防御、RAGセキュリティの脅威、RAG運用の監査方法を順に整理します。社内AIナレッジを安全に活用するための、実装・検証・改善の判断軸を持ち帰ってください。
RAGアクセス制御は検索前から設計する
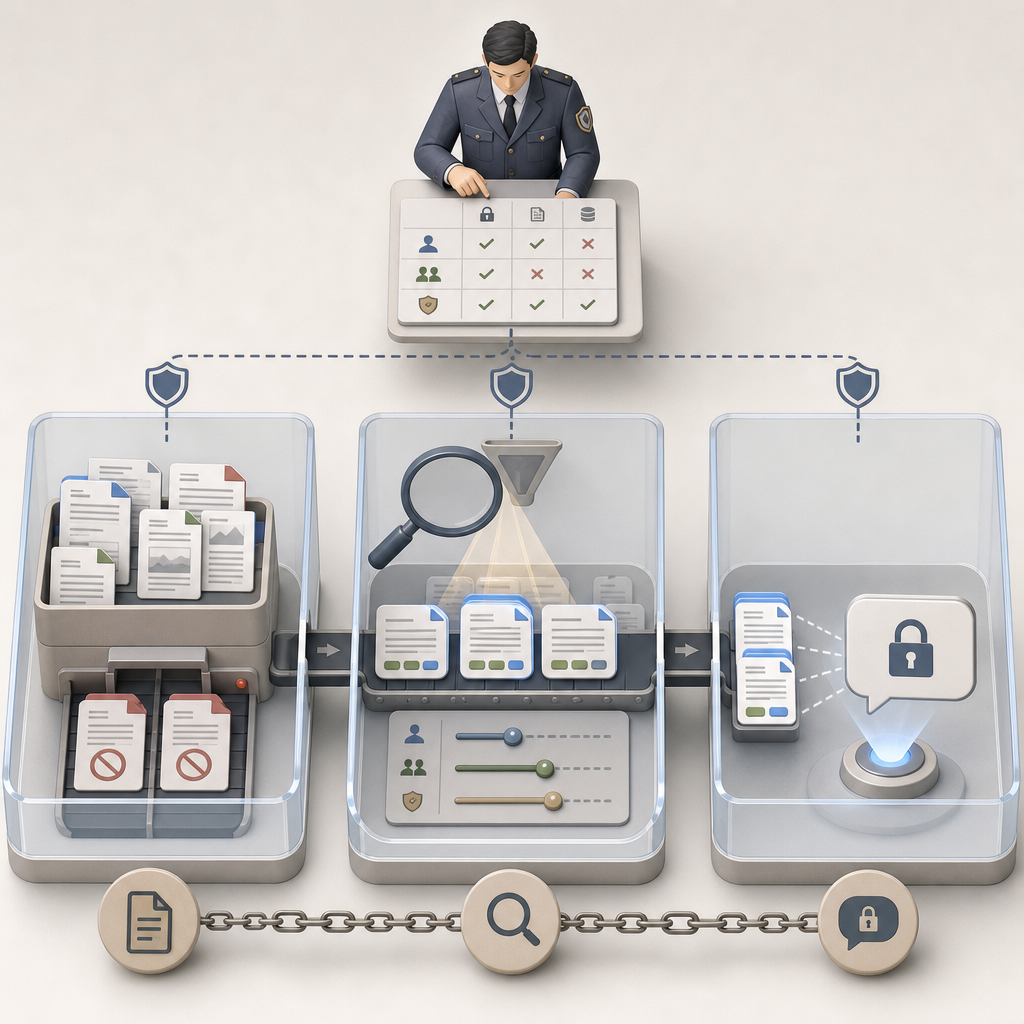
守る対象を三段階で分ける
RAGアクセス制御の出発点は、取り込み・検索・回答の全段階で権限を評価することです。RAGは大きく「取り込む(インデックス化)」「検索する」「回答する」の3段階があります。どこか一段階でも判定を省略すると、後段の対策だけでは漏えいを防げません。
取り込みでは、原文、添付ファイル、OCR結果、更新者、機密区分を記録します。検索では利用者の所属や役割に基づいて候補チャンクを絞り、回答では取得根拠がない内容を出さない制御を加えます。文書単位だけでなく、チャンク単位で一貫させる点が重要です。
設計時には、誰が何を読めるか、外部共有を許すか、回答にURLを表示するかを先に合意します。最初に決めるべきは次の3点です。保護対象、認可判断の主体、権限変更を反映する許容時間を定義し、仕様書とテストケースへ落とし込みます。
- 原文・チャンク・埋め込みの機密度を分けて管理する
- 検索候補に入れる前に認可判定を完了する
- 回答には出典と判定ログを紐付ける
認証と認可を混同しない
安全な設計では、認証は「誰か」を確かめ、認可は「何をしてよいか」を判定します。SSOを使っていても、それだけではRAGアクセス制御になりません。SAMLまたはOIDCで得た利用者ID、部門、雇用状態を、検索時の認可条件へ確実に渡す必要があります。
Microsoft Entra ID、AWS IAM、Oktaなどの既存ID基盤と連携すれば、入退社や異動の手作業を減らせます。ただし、グループ情報をアプリケーション側で長時間キャッシュすると、退職者の権限剥奪が遅れます。トークンの有効期限と同期失敗時の扱いを明文化しましょう。
認可判断は原則拒否と最小権限を基本にします。権限情報が取得できない場合、検索を続行するのではなく回答を停止します。社内ポータルの閲覧権限をACLとして継承し、RAG専用の例外権限は申請・承認・期限設定を必須にすると監査性が高まります。
- SSOのログイン成功と文書閲覧許可を別々に検証する
- ID基盤の所属変更を検索条件へ同期する
- 権限情報の欠落時は原則拒否にする
認可モデルは組織の変化に合わせる
認可モデルは、固定的な組織にはRBAC、条件が多い業務にはABAC、案件や文書ごとの関係性にはFGAが適します。RAGアクセス制御で重要なのは、モデル名ではなく、質問時に候補文書を確実に除外でき、権限変更後に再現可能な証跡を残せることです。
RBACは「営業部」「人事担当」などの役割で管理しやすい一方、プロジェクト限定の共有には細かすぎない設計が必要です。ABACは機密区分、契約状態、端末、場所などの属性を使えますが、属性品質が低いと誤許可につながります。FGAは関係性を明示できる反面、運用設計が欠かせません。
schema 1.1のように、文書、チャンク、利用者、グループ、テナントの関係を型として定義すると、実装者ごとの解釈差を減らせます。認可ポリシーはコードだけに埋め込まず、変更履歴、承認者、検証結果を残し、業務部門と定期的に見直すべきです。
| 項目 | RBAC | ABAC | FGA |
|---|---|---|---|
| 主な判断軸 | 役割 | 属性 | 関係性 |
| 向く環境 | 固定組織 | 条件付き公開 | 案件共有 |
| 強み | 運用が明快 | 条件を表現 | 細粒度制御 |
| 注意点 | 役割肥大化 | 属性の品質 | 関係データ管理 |
- RBACは役割中心、ABACは属性中心、FGAは関係中心で選ぶ
- 文書とチャンクの親子関係を認可スキーマに含める
- ポリシー変更はレビューと回帰試験を通す
検索結果に権限を反映する実装
検索前フィルタを第一防衛線にする
検索時の最も確実な対策は、許可されたチャンクだけを検索対象にすることです。ベクトル類似度の上位結果を取得してから隠す方式では、候補数、ログ、キャッシュ、再ランキング処理に機密データが残る可能性があります。認可条件をベクトルDBのフィルタへ渡してください。
各チャンクには、文書ID、親フォルダ、テナントID、機密区分、ACL、作成日、失効日をメタデータとして持たせます。ユーザーのグループ集合と照合し、tenant_idの完全一致を必須にします。マルチテナント環境では、類似度の高さよりテナント境界を優先することが原則です。
Top-K件(K=3〜10程度)をLLMへ送る前に、許可件数、取得元、フィルタ条件をログへ保存します。回答品質が下がった場合でも、安易にKを増やして権限境界を緩めてはいけません。検索不足は、データ整備やクエリ拡張で改善する課題として切り分けます。
- ベクトル検索APIでメタデータフィルタを強制する
- tenant_idは検索条件と保存領域の両方で分離する
- 許可された根拠チャンクだけをLLMに渡す
インデックス分離とACL継承を使い分ける
部門や顧客ごとに完全な隔離が必要なら、インデックス分離が有効です。一方で、全社規程のように多くの利用者が参照する文書は、ACL継承とメタデータフィルタの方が更新コストを抑えられます。どちらも単独で万能ではなく、データ特性に応じた併用が現実的です。
社内AIナレッジでは、共有フォルダのACLをそのまま同期するだけでは不十分です。親フォルダから子文書、文書からチャンクへ継承する規則と、個別例外の優先順位を定義します。権限の継承元を保存しておけば、なぜ検索可能だったかを後から説明できます。
削除済み文書や期限切れ資料は、画面から消えていても埋め込みやバックアップに残り得ます。削除イベントを受けて、原文、チャンク、ベクトル、キャッシュを順に無効化します。完全削除までの状態を可視化し、回答対象から即時除外する経路を先に実装しましょう。
- 高機密・顧客別データは物理または論理インデックス分離を検討する
- ACLの継承元と例外ルールを記録する
- 削除処理はベクトル、キャッシュ、ログの保持方針まで定義する
チャンク設計を認可設計と一体化する
チャンク分割は検索精度だけでなく、情報境界を決める作業です。機密情報と公開可能な説明が同じチャンクに混在すると、権限のある一文を根拠に不要な情報までLLMへ渡ることがあります。見出し、表、添付、段落の意味を保ちながら、機密区分が混ざらない単位に分けます。
RAG構築では、一般的には数十件〜数百件程度のデータがあると実用的な運用を始めやすくなります。ただし、小規模でも権限メタデータの後付けは高コストです。PoCの段階から文書所有者、公開範囲、保持期限、更新日時を必須項目にして取り込みます。
機密度の異なる資料を扱う場合は、チャンクに単一の最も厳しい区分を付与します。親文書の権限変更が子チャンクへ反映されたことをジョブ単位で確認し、未反映なら検索を停止します。この設計が、RAG構築を本番へ進める際の安全な土台になります。
- チャンク内に異なる公開区分を混在させない
- 親文書のACL変更を子チャンクへ伝播する
- 取り込み失敗時は未分類データを公開しない
RAGセキュリティの攻撃面を減らす
文書ポイズニングを取り込み時に止める
RAGセキュリティでは、信頼できない文書を検索対象へ入れないことが最優先です。攻撃者は文書中に「前の指示を無視する」といった間接プロンプトを埋め込み、正規の検索結果を経由してモデルの応答を誘導します。アップロード権限と文書来歴を分離して管理しましょう。
安全性の検証では、90%(対象質問あたりわずか5つの悪意テキストを注入した場合)という攻撃成功の報告があります。知識ベース(100万件)のうち、悪意ある文書はわずか 5件 だけでも、検索結果(Top-5)では、悪意文書が 3件 を占め過半数になる可能性があります。
取り込み時は、作成者、承認者、取得元URL、ハッシュ、ウイルス検査結果を記録します。SHA-256 minimumを目安に改ざん検知用のハッシュを保存し、更新後の文書と比較します。未承認のコネクタや個人領域からの自動同期は、隔離インデックスで評価してから本番へ反映します。
- 文書の作成者と承認経路を検証する
- ハッシュと取得日時で完全性を追跡する
- 未知のデータソースは本番インデックスへ直結しない
プロンプトインジェクションは出力前にも検査する
プロンプトインジェクションへの対策は、入力フィルタだけでは完結しません。検索文書にも命令文が含まれるため、LLMへ渡すコンテキストを「参照情報」として明示し、ツール実行や秘密情報の開示指示として解釈しないシステムプロンプトを設計します。
特にエージェント型RAGでは、検索結果が外部ツールの実行条件を上書きしないようにします。ツール呼び出しは、利用者の認可と業務ルールを別途検証し、モデルの出力だけで確定させません。高リスクの操作には人間の承認フローを残すことがAIセキュリティ対策の基本です。
出力時には、機密パターン、個人情報、アクセストークン、権限外の文書名を検査します。検査結果が不確実なら、回答を伏せて出典へのアクセス申請へ誘導します。3段階のサニタイズ処理を設ける場合も、誤検知率と業務影響を測定し、例外処理を監査可能にします。
- 文書中の命令を実行命令として扱わない
- ツール実行はモデル出力とは別の認可で確定する
- 出力検査で秘密情報と権限外参照を遮断する
脅威を測定可能な検査項目にする
AI脆弱性診断は、攻撃文字列を一度試すだけでは不十分です。権限なしユーザーが人事資料を検索できないか、異動直後の利用者に旧部署の回答が出ないか、悪意文書の混入で回答が誘導されないかを、固定テストセットで繰り返し測定します。
評価では、権限外情報の取得成功率を0%にすることを必達条件とし、正規利用者の必要情報が拒否される誤拒否率も追跡します。攻撃研究には90% attack success ratesという結果もあるため、通常精度だけで安全と判断せず、攻撃クエリを回帰試験へ組み込みます。
脆弱性情報や検査ルールは更新されます。運用文書にLast updated at Posted at 2026-03-13といった更新日時を残し、診断の実施日、対象モデル、対象インデックス、結果、是正期限を記録します。再現できる証跡が、インシデント時の原因分析を支えます。
- 権限外取得率、誤拒否率、検索遅延を継続計測する
- 異動・退職・削除直後のテストを必須化する
- 診断対象とルールの更新日時を証跡化する
RAG構築で安全性と回答品質を両立する
PoCでも本番と同じ権限前提で作る
安全なRAG構築は、後からアクセス制御を追加するのではなく、最初のデータ取り込みから認可を組み込むことが答えです。RAGは数枚のPDFや数十ページ程度のマニュアルからでも構築自体は可能です。しかし、実運用の権限構造を無視したPoCは、本番移行時に作り直しになりがちです。
データ整備は工数全体の80〜90%を占める場合があります。OCRの誤り、重複資料、失効した規程、権限不明の共有ファイルを放置すれば、検索精度と安全性は同時に下がります。データオーナーが公開範囲を承認するワークフローを、取り込みパイプラインに組み込みます。
社内AIナレッジのPoCでは、部門横断の公開資料、部門限定資料、高機密資料を意図的に混在させます。そのうえで、役割ごとに同じ質問を実行し、検索候補、引用、最終回答が変わることを確認します。単に答えられるかではなく、答えてはいけない内容を出さないかを合格条件にします。
- PoCデータにも実際の公開区分とACLを付ける
- データオーナーが公開範囲を承認する
- 役割別の同一質問で境界を検証する
検索品質と安全性を別の指標で見る
品質評価では、検索品質と生成品質を分けて測定します。検索では許可文書だけから正解根拠を取得できたか、生成では根拠を逸脱せず回答したかを確認します。高い回答評価でも、権限外の文書が混ざっていればRAGアクセス制御としては不合格です。
ハイブリッド検索、再ランキング、キャッシュを適切に組み合わせると、クエリの応答時間が40〜60%改善することがあります。ただし、キャッシュキーに利用者、役割、テナント、ポリシーバージョンを含めなければ、別利用者へ回答を再利用する漏えいを招きます。
検索の適合度が70〜85%でも、生成回答の正確性が15〜30%にとどまる場面はあります。その差を縮めるため、出典の表示、回答不能時の明示、再質問の誘導を実装します。精度改善のために検索範囲を広げる前に、許可集合と評価データの品質を見直してください。
- 検索根拠の適合と回答の正確性を分離して評価する
- キャッシュキーに認可コンテキストを含める
- 回答不能を安全に伝えるUXを用意する
モデル選定にも情報境界を持ち込む
モデル選定では、性能だけでなく、送信データの範囲、保存ポリシー、リージョン、監査ログを確認します。70B規模のモデルを自社環境で扱う場合は、推論基盤だけでなく、埋め込み生成、ベクトルDB、監視基盤まで含めて責任分界を設計する必要があります。
RAGは必要な根拠だけをコンテキストに渡せるため、ケースによっては推論コストを40〜70%削減できます。ただし、コスト削減を理由に権限フィルタや出力検査を外してはいけません。安全性の処理は、処理時間と費用を測りながら最適化する対象です。
外部API、埋め込みモデル、コネクタ、ベクトルDBの各層で、どの事業者へ何のデータが送られるかを台帳化します。NIST、ISO/IEC 27001、CIS Controlsの考え方を参照し、暗号化、ログ保全、委託先管理を統一します。これが継続可能なAIセキュリティ対策になります。
- データ送信先と保持範囲をコンポーネント別に記録する
- コスト最適化と認可処理を別の要件として扱う
- 外部連携先を含めた責任分界を明確にする
RAG運用で権限変更と監査を継続する
異動と削除を即時に検索から外す
RAG運用で最も見落とされやすいのは、権限を剥奪した後のデータ残存です。利用者が異動・退職したとき、ID基盤、認可サービス、ベクトルDBのフィルタ、再ランキングキャッシュ、会話履歴のすべてで旧権限が使えないことを確認しなければなりません。
運用ジョブは、権限変更イベントを受け、対象チャンクのACLを更新し、古い検索キャッシュを失効させます。失敗したジョブを自動再試行するだけでなく、未完了件数を管理者へ通知します。権限変更から検索遮断までの時間をSLOとして定め、定期的に実測してください。
文書削除では、検索対象外にする論理削除と、保持期限後の物理削除を分けます。法務・監査上の保持要件がある場合でも、削除要求後に回答へ使わないことは別要件です。バックアップ復元時に失効済みACLを復活させない手順まで、復旧訓練で確認します。
- 権限変更後の検索遮断時間を測定する
- キャッシュと会話履歴の扱いを設計する
- バックアップ復元時にも失効状態を再適用する
監査ログを回答の根拠までつなぐ
監査ログは「誰が質問したか」だけでなく、なぜその回答が許可されたかを示せる必要があります。利用者ID、所属、適用ポリシー、検索フィルタ、取得チャンクID、出典、出力検査結果、拒否理由を相関IDで結び、改ざんされにくい保管先へ送ります。
ログに原文や機密質問を無制限に保存すると、監査基盤そのものが新しい漏えい経路になります。質問内容は必要に応じてマスキングし、閲覧者にも最小権限を適用します。監査目的、保持期間、削除手順を定め、通常運用のログと分離してアクセスを管理しましょう。
AI権限全体の役割設計や承認フローは、AI権限管理の解説と合わせて検討すると整理しやすくなります。RAG固有のログは、既存のID管理・SIEM・インシデント対応手順へ接続し、孤立した運用にしないことが大切です。
- 認可判断から出力検査までを相関IDで追跡する
- 監査ログ閲覧者にも権限を適用する
- 既存の監視・対応基盤と連携する
段階導入と定期診断で改善を続ける
導入は、公開範囲が明確な部門から始め、利用者と文書を段階的に広げる方法が安全です。初期導入段階で平均51%、最適化後には最大86%という改善指標が示されることもありますが、数値だけで展開範囲を決めず、権限外取得率と監査可能性を必ず併せて評価します。
月次では、拒否された質問、検索ゼロ件、権限変更の反映失敗、出力検査の遮断、文書更新の滞留を確認します。四半期ごとにはAI脆弱性診断として、権限昇格、テナント越境、プロンプトインジェクション、削除済み資料の再出現を想定したテストを実施します。
RAG運用の改善は、現場が回答を使えることと、管理部門が説明責任を果たせることの両立です。業務部門、情報システム、セキュリティ、法務が同じ評価結果を見て、ポリシー、データ、プロンプト、システム構成のどこを直すかを合意する場を作りましょう。
- 小さな公開範囲から検証可能な形で始める
- 安全性と利用価値を別々の指標で判断する
- 定期診断の結果をポリシー改善へ反映する
まとめ
RAGアクセス制御は、ログイン機能や文書の閲覧設定だけでは完結しません。取り込み時の来歴管理、検索前の細粒度認可、生成後の出力検査、権限変更の即時反映、根拠まで追える監査ログを一つの流れとして設計することが、生成AI情報漏えいを防ぐ鍵です。
要点
- 認証、認可、検索、生成の各段階で権限を途切れさせない
- ベクトル検索の前にテナント・ACL・機密区分で候補を絞り込む
- 権限外取得率を0%の必達指標として継続検査する
- 異動・退職・文書削除後の残存データまで運用対象にする
- 監査ログで回答の根拠と認可判断を説明できるようにする
まずは、現在の社内AIナレッジについて「誰が、どの文書を、どの根拠で回答に使えるか」を棚卸ししてください。RAG構築の初期段階から権限情報と検証シナリオを組み込み、業務価値と安全性を両立する運用基盤を整えましょう。
よくある質問
Q1. RAGアクセス制御と通常のファイル権限は何が違いますか?
通常のファイル権限は原文の閲覧を制御しますが、RAGアクセス制御はチャンク化、ベクトル検索、再ランキング、LLMによる回答生成まで、情報が回答に使われる全経路を制御します。
Q2. SSOを導入すればRAGの情報漏えいは防げますか?
防げません。SSOは本人確認の仕組みです。利用者の属性や役割を検索フィルタへ渡し、文書・チャンク単位で認可し、出力も検査して初めて漏えい対策として機能します。
Q3. RAGで権限変更があった場合、何を確認すべきですか?
ID基盤、認可サービス、ベクトルDBのメタデータ、検索キャッシュ、会話履歴、バックアップ復元手順を確認します。旧権限の利用者で検索・回答が遮断されるテストを実施してください。
Q4. RAGセキュリティで最初に行うべき診断は何ですか?
権限なし利用者による機密文書検索、別テナントの情報取得、悪意文書を介した間接プロンプトインジェクション、削除済み文書の再取得を、固定シナリオで検査することです。
Q5. 小規模なRAG構築でもアクセス制御は必要ですか?
必要です。数枚のPDFから始める場合でも、文書所有者、公開範囲、機密区分、更新日時をメタデータとして保持してください。後から権限を追加するより、安全かつ低コストに本番へ拡張できます。
参考文献・出典
[Book a Demo](/book-a-demo) [Back to all posts](/blog) # RAG Security: Risks and Mitigation Strategies ![The Lasso…
www.lasso.security
[](https://japan-ai.co.jp/media)…
japan-ai.co.jp
* [Solutions](#) + [WitnessAI for Applications](https://witness.ai/for-applications/) + [WitnessAI for Employees](https://witness.ai/for-employees/) +…
witness.ai