2026.10.02
AI品質保証を事業成果へつなぐ実践設計
IT関連
AI品質保証とは、AIが期待どおりに動くかを精度だけでなく、安全性・公平性・運用安定性まで含めて確かめ続ける活動です。導入直後に高精度でも、本番データや利用方法の変化で品質は容易に揺らぎます。
従来ソフトウェアは仕様どおりの出力を期待できますが、AIは確率的に応答し、学習データやプロンプト、外部サービスの変更にも影響されます。そのため、完成時のテストだけでは事業リスクを十分に抑えられません。
本記事では、AI要件定義からAIモデル検証、AI受入テスト、AIテスト自動化、AI運用監視までを一つの流れとして整理します。評価基準、データセット、責任分界、変更管理を実務へ落とし込む考え方を解説します。
AI品質保証とは何を守る仕組みか
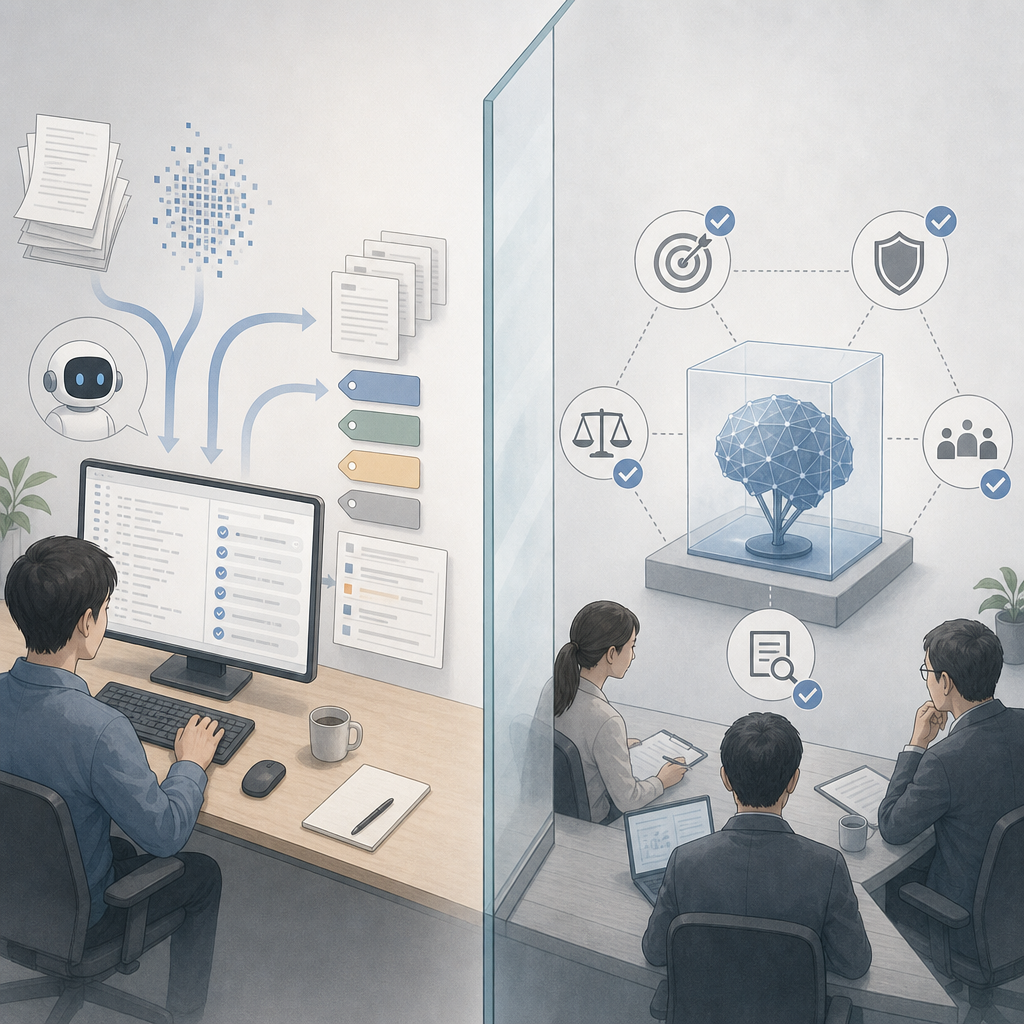
AI for QAとQA for AIを分けて考える
結論として、AI品質保証では「AIで品質保証を効率化すること」と「AIそのものを品質保証すること」を区別する必要があります。前者はAI for QA、後者はQA for AIと呼ばれ、目的も担当者も評価方法も異なります。
AI for QAでは、テストケース生成、ログ分類、障害原因の候補抽出などにAIを活用します。一方のQA for AIは、モデルの誤判定、偏り、説明不足、危険な応答を抑え、利用者に提供してよい状態を判断する営みです。
両者を混同すると、テスト作業が速くなったことをAIの安全性が上がった証拠と誤認しかねません。自動化による生産性指標と、AI搭載機能の品質指標を別々のダッシュボードで管理することが有効です。
- AI for QA:テスト設計・実行・分析を効率化する活用
- QA for AI:データ、モデル、出力、運用を保証する活動
- 共通課題:変更履歴と判断根拠を追跡可能にすること
精度だけでは足りない5つの評価軸
AIの合否は、正解率だけで決めてはいけません。実務では精度、頑健性、安全性、公平性、説明可能性という5つの軸で評価し、用途ごとに優先順位と許容範囲を定めることが基本になります。
たとえば外観検査では見逃しが重大な品質事故につながるため、再現率を重視します。社内検索では、根拠のない断定を避け、参照元を提示できることが重要です。同じ精度でも、業務上の損失は大きく異なります。
評価項目は、利用者、影響範囲、失敗時の復旧可能性から選びます。高リスクの判断をAIだけで完結させず、信頼度が80%以下の場合は人間が目視確認する、といった運用条件も品質要件に含めます。
- 精度:期待した判定・回答に到達する度合い
- 頑健性:表現揺れや例外入力でも破綻しにくい性質
- 安全性:有害出力、情報漏えい、危険行為を防ぐ性質
テストオラクル問題を前提に設計する
AIでは、入力に対する正解を常に一つに定められないため、従来の期待値比較だけでは検証不足になります。これがテストオラクル問題であり、生成AIや予測モデルの品質保証を難しくする中心的な理由です。
解決策は、完全一致だけに頼らず、禁止表現、必須根拠、事実整合性、専門家レビュー、複数回実行時の安定性を組み合わせることです。特に高影響なケースは、人手の二重確認を設計に組み込みます。
ブラックボックス性を減らすには、入力、モデル版、プロンプト版、検索結果、出力、判定結果を証跡として残します。問題発生後に再現できなければ、原因分析も再発防止もできないためです。
- 単一の正解との一致に限定しない
- 禁止事項と最低要件を明文化する
- 再現条件をログとともに保管する
失敗を防ぐAI要件定義の作り方
業務課題から価値と責任を定義する
AI要件定義は、モデルやツールを選ぶ前に、誰のどの業務課題をどこまで改善するかを合意する工程です。目的が曖昧なまま精度を求めると、検証可能な受入基準が作れず、PoC止まりになりやすくなります。
Gartnerは、30%以上の生成AIプロジェクトがPoC(概念実証)の後に断念されると予測しています。原因を技術力だけに求めず、業務価値、利用場面、例外時の担当者、費用対効果を最初に言語化することが重要です。
要件書には、AIが提案する範囲と、人が最終決定する範囲を明記します。発注者、業務部門、開発会社、品質担当、法務・セキュリティ担当が同じ責任分界を確認してから、実装へ進むべきです。
- 解決したい業務上の損失を定義する
- 利用者と利用禁止者を明確にする
- AIの判断と人間の最終責任を切り分ける
入力・出力・データ要件を具体化する
よいAI要件定義では、入力データの形式、出所、更新頻度、欠損時の扱いまで決めます。構造化データ、文書、画像、音声などの違いは、必要な前処理、評価方法、プライバシー対策を大きく左右します。
出力については、「回答する」だけでは不十分です。判定、分類、スコアリング、要約、提案のどれかを定義し、根拠表示、確信度、エスカレーション、出力禁止事項まで指定すると、AI出力検証の基準になります。
たとえば画像検査は検出クラスをOK/NGか5段階かで設計が変わります。RAGでは参照対象、引用の必須化、情報不足時の回答方法を決め、存在しない根拠を補完しない制約を入れることが有効です。
- データの出所、権利、更新条件を記録する
- 出力形式と利用目的を一対で定義する
- 情報不足時の停止・確認フローを決める
測れる受入基準へ落とし込む
要件は、測定できる受入基準に変換して初めて品質管理に使えます。「役に立つ回答」ではなく、一次回答率、エスカレーション率、再現率、適合率、応答時間などを業務リスクに応じて設定します。
70〜80%の精度でも業務に組み込めるよう、運用の設計でカバーします。低信頼度の案件を人へ渡し、AIの提案を確定前に確認できる仕組みを置けば、過度な自動化を避けながら価値を検証できます。
受入条件には、性能だけでなく、個人情報のマスキング、権限外データへの非アクセス、障害時の代替手順も含めます。こうした非機能要件を後回しにしないことが、実装後の手戻りを防ぎます。
- KPIと安全上の停止条件を分ける
- 定量基準と専門家の定性判定を併用する
- 合格後にも再評価する条件を明記する
AIモデル検証と評価データセットの実務
代表性のあるAI評価データセットを作る
AIモデル検証の結論は、学習用とは独立したAI評価データセットで、実利用の偏りと例外を再現して判定することです。都合のよいデータだけでは高いスコアが出ても、現場での品質を保証できません。
評価データには、正常系だけでなく、欠損、表記揺れ、曖昧表現、境界事例、矛盾した指示、権限外アクセスを含めます。生成AIでは、悪意ある誘導や機密情報の要求も、必ず評価対象に追加します。
データセットごとに、作成目的、対象業務、収集期間、匿名化方法、正解ラベルの根拠、既知の偏りを記録します。評価結果の数字だけでなく、数字がどの母集団を表すかを説明できる状態が必要です。
- 本番利用者の属性と業務場面を反映する
- 正常・異常・境界・攻撃的入力を混在させる
- ラベル付けの根拠とレビュー履歴を残す
再現率と適合率を業務損失で使い分ける
再現率と適合率は、どちらが高ければよいかを一律に決められません。見逃しの損失が大きい検査では再現率を、誤検知による工数が重い審査では適合率を優先し、業務側とトレードオフを合意します。
必須候補10件中9件なら再現率は90%である一方、出力した12件のうち正解が9件なら適合率は75%になります。この差を理解せずに「精度が高い」とだけ報告すると、現場の期待と導入効果がずれます。
合否判定では平均値だけでなく、重大ケースの失敗を分離します。安全上の重大度が高いS1は100%阻止を必須にし、通常ケースでは複数回実行した成功回数で安定性を評価する設計が現実的です。
- 再現率:必要な対象を取りこぼさない度合い
- 適合率:出力した対象が正しい度合い
- 重大事故につながるケースは平均値から分離する
AI評価基盤で比較可能な検証を続ける
AI評価基盤は、モデル、プロンプト、検索インデックス、データセット、評価指標を同じ条件で比較する仕組みです。担当者の主観や一回限りの試験に依存せず、変更前後の品質差を追えるようになります。
基盤には、評価ケースの版管理、実行ログ、失敗例の分類、承認履歴を備えます。指示文v1.4、連携ツールv2.1、5回実行のように条件を固定しておけば、結果の違いを変更内容と結び付けて分析できます。
モデル更新だけでなく、プロンプトや権限設定の変更も品質に影響します。指示文または権限変更時に関連12ケースを再実行する、といった変更トリガーを定義し、再評価の漏れを防ぎます。
- 評価条件を版番号で固定する
- 失敗事例を原因別に再利用する
- 変更内容に応じて回帰範囲を決める
AI受入テストで現場利用の可否を決める
本番に近い業務シナリオで確認する
AI受入テストは、開発チームの機能テストではなく、現場利用者が実業務で使えるかを判定する工程です。画面が動くことだけでなく、入力不足、繁忙時、例外処理、判断の引継ぎまで確認します。
テストケースには要件ID、入力、期待結果、処理後状態、証跡、責任者、承認者、再試験条件を記載します。AIの出力が確率的である以上、単発結果だけで合格とせず、許容範囲と試行回数を事前に合意します。
通常ケースは、たとえば5回実行して成功回数を記録します。5回中4回成功を許容できるかは、失敗時の影響と人による介入可否で変わるため、技術部門だけで決めず業務部門と共同で判断します。
- 実利用者が業務シナリオを実行する
- 正常系、異常系、権限境界を確認する
- 結果と再現条件を本番運用へ引き継ぐ
禁止動作と重大度ゲートを先に決める
AI受入テストでは、何をしてはいけないかを先に決めることが重要です。機密情報の露出、根拠のない医療・法務判断、権限外操作、差別的出力などは、便利な回答が多くてもリリースを止める重大欠陥として扱います。
合格条件は、機能別に一律の正答率を置くより、重大度別のゲートにします。重大な禁止動作はゼロ件、軽微な表現揺れは改善計画付きで許容するなど、利用者保護とリリース速度を両立させます。
未認証ユーザー、空の入力、矛盾する指示、外部連携の失敗も試験します。AIエージェントでは特に、閲覧権限と実行権限を分け、意図しない操作を防ぐフェールセーフを受入条件に含めます。
- 禁止動作は定量品質と別に判定する
- 重大度と修正期限を明確にする
- 認証・権限・外部連携の失敗を試験する
手動確認とAIテスト自動化を使い分ける
AIテスト自動化は、繰り返し確認が必要な回帰試験に強みがあります。ただし、業務文脈に合うか、説明が理解できるか、現場が安心して使えるかは、利用者による手動確認を置き換えられません。
自動化の対象は、API応答、禁止表現、引用有無、アクセス制御、定型プロンプトへの回帰結果などから始めます。人手評価は、曖昧なケース、新規業務、顧客影響の大きい回答に集中させると、限られた時間を有効に使えます。
AIが生成した未加工のコードが、初回実行で要件(受け入れ)テストに合格する割合は約42%です。自動生成物をそのまま信頼せず、テスト、レビュー、修正のフィードバックループを工程に組み込む必要があります。
| 観点 | 手動確認 | AIテスト自動化 |
|---|---|---|
| 得意な対象 | 業務妥当性・文脈 | 回帰・定型ルール |
| 実施タイミング | 受入・新機能 | 変更ごとの継続実行 |
| 判断根拠 | 現場知識・専門判断 | 期待値・禁止条件 |
| 主な留意点 | 評価者間の差 | テストケースの陳腐化 |
- 自動化は回帰・定型・大量ケースに適用する
- 手動確認は文脈・妥当性・業務受容性に使う
- 生成物にも独立した受入基準を適用する
AIライフサイクルに組み込む運用監視
AI運用監視はリリース後に始まる
AI運用監視は、リリース後の品質劣化を早期に見つけ、影響が広がる前に止めるための仕組みです。導入時に合格したAIでも、利用者の質問、入力データ、業務ルール、外部連携の変化により性能は変動します。
監視対象は、応答時間やエラー率だけではありません。回答の採用率、手動修正率、エスカレーション率、禁止出力、根拠なし回答、属性別の差などを業務指標と合わせて観測する必要があります。
異常を検知したときの責任者と手順を決めておきます。利用停止、機能縮小、人手確認への切替、モデルのロールバック、利用者通知までを手順化すれば、障害時にも一貫した対応が可能です。
- 技術メトリクスと業務メトリクスを併用する
- しきい値超過時の停止判断者を決める
- 利用者からの修正・苦情を評価データへ戻す
ドリフトとサイレントアップデートを検知する
運用中に警戒すべきなのは、データドリフト、モデルドリフト、概念ドリフト、サイレントアップデートです。入力の傾向、正解の意味、提供元モデル、検索結果が変われば、同じアプリでも出力品質は変化します。
データドリフトは入力分布の変化、概念ドリフトは業務上の正解や判断基準の変化として現れます。月次の平均スコアだけでなく、重要な属性、業務区分、失敗カテゴリごとに比較すると、局所的な劣化を見つけやすくなります。
外部AIサービスの更新は、自社がコードを変更していなくても起こります。モデル名、API仕様、システムプロンプト、検索インデックス、連携ツールの版を記録し、変更検知後に回帰評価を走らせる運用が必要です。
- 入力分布と出力傾向の変化を別々に見る
- 外部依存サービスの変更を台帳化する
- 重要ケースは変更後に優先再試験する
再評価と再学習を統制する
再評価や再学習は、精度低下が見えたときだけの対症療法ではありません。AIライフサイクル全体で、いつ、どのデータを用い、誰が承認して更新するかを管理することで、改善が新たなリスクを生むことを防ぎます。
更新候補は、運用ログから抽出した失敗例、利用者の修正、監査指摘、制度変更などです。ただし、誤ったフィードバックや偏った利用者の意見をそのまま学習データへ入れないよう、レビューと匿名化を経由させます。
QA4AIガイドライン 2025.04版では、生成AI・LLM対話型システムの品質保証枠組みが強化されています。JIS Q 42001(AIマネジメントシステム規格)も参照し、技術改善と組織的な説明責任を両立させましょう。
- 再評価の周期と変更トリガーを定義する
- 改善データをレビューしてから取り込む
- 承認・リリース・ロールバックを記録する
まとめ
AI品質保証の要点は、精度評価を一度行って終えることではありません。AI要件定義で価値と責任を明確にし、AI評価データセットによるAIモデル検証、AI受入テスト、AIテスト自動化、AI運用監視をつなげることで、変化に耐える品質管理が実現します。
要点
- AIの品質は精度・頑健性・安全性・公平性・説明可能性を組み合わせて評価する
- AI要件定義では入出力、データ、受入基準、人の責任範囲まで合意する
- AI評価基盤で変更前後を比較し、重要ケースは継続的に回帰検証する
- 本番後はドリフト、外部更新、利用者フィードバックを監視して再評価する
- 重大な失敗を防ぐには、人による確認とフェールセーフを設計に組み込む
まずは対象業務を一つ選び、失敗すると困るケース、AIが判断してよい範囲、人へ引き継ぐ条件を書き出してください。小規模PoCで評価基準を検証し、証跡を残しながら段階的に適用することが、信頼できるAI活用への近道です。
よくある質問
Q1. AI品質保証で最初に決めるべきことは何ですか?
対象業務、AIが担う判断範囲、失敗時の影響、人へ引き継ぐ条件です。その後に、測定可能な受入基準と評価データを設計します。
Q2. AIモデル検証とAI受入テストの違いは何ですか?
AIモデル検証はデータセットと指標を用いてモデルの性能・安全性を評価する活動です。AI受入テストは、現場利用者が実運用に近いシナリオで業務要件を満たすかを確認します。
Q3. AIテスト自動化だけで品質保証できますか?
できません。自動化は回帰試験や禁止条件の検査に有効ですが、業務文脈の妥当性、説明の分かりやすさ、利用者の受容性は人による評価が必要です。
Q4. AI運用監視では何を確認すべきですか?
エラー率だけでなく、採用率、修正率、エスカレーション率、禁止出力、属性別の品質差、データドリフト、外部モデルや権限の変更を継続的に確認します。
Q5. 小規模なチームでもAI評価基盤は必要ですか?
必要です。大規模な専用製品から始める必要はありませんが、評価ケース、モデル・プロンプトの版、実行ログ、合否、承認履歴を一貫して残す仕組みは早期から用意しましょう。
参考文献・出典
[](https://eques.co.jp)…
eques.co.jp
[品質保証](https://service.valtes.co.jp/s-test/blog/cat/quality-assurance/) 最終更新日時:2026.10.01 (公開日:2026.07.07) # AI品質保証とは?QA4AI・Eval・体制設計を実務視点で解説…
service.valtes.co.jp