2026.09.28
AI成果物管理を実務で定着させる設計術
IT関連
AI成果物管理とは、AIが生む文書・コード・回答だけでなく、要件、データ、プロンプト、評価結果を関連付けて管理する実務です。出力だけを保存しても、再現性と説明責任は確保できません。
生成AIの活用範囲が広がるほど、「誰が、どのデータと指示で、何を作り、どの基準で承認したか」を追える状態が重要になります。特に顧客情報や業務判断を扱う場合、品質・権利・機密性を一体で扱う必要があります。
本記事では、AI要件定義からプロンプト管理、AI評価データセット、AI受入テストまでを一つの流れとして整理します。台帳設計、変更管理、レビュー基準、段階的な導入方法を、現場で実行しやすい形で解説します。
AI成果物管理で追跡すべき対象を定義する
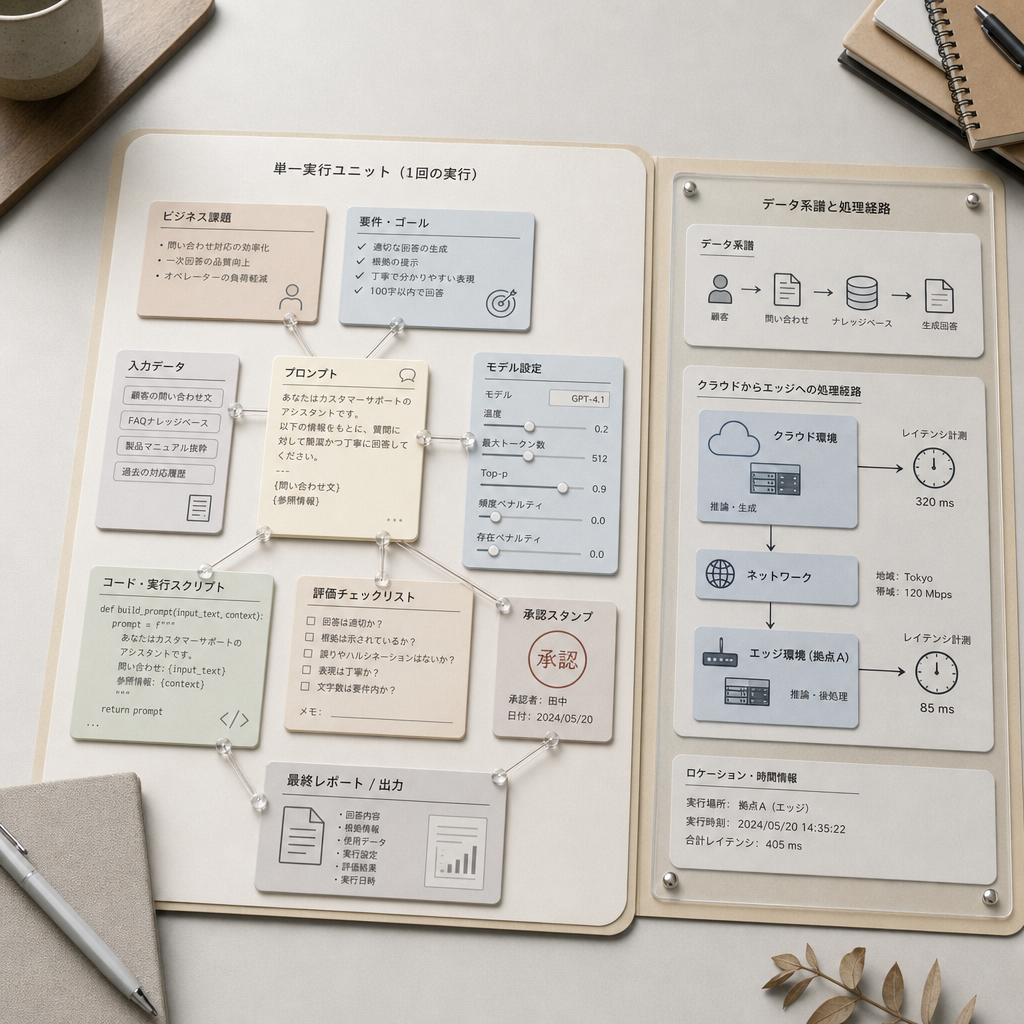
成果物は生成された出力だけではない
AI成果物管理の対象は、最終回答やレポートだけではありません。業務課題、要件、入力データ、プロンプト、モデル設定、コード、評価結果、承認記録を一つの単位として結び付けることが出発点です。
例えば営業提案書を生成する仕組みでは、参照した商品情報、使用モデル、テンプレート、生成日時、担当者レビューを残します。これにより、誤記が見つかった際にも、修正対象と影響範囲を短時間で特定できます。
管理単位を「ファイル」ではなく「再現可能な実行」と考えると、部署間の引き継ぎも進みます。成果物IDを発番し、案件名、用途、機密区分、所有者、利用期限を必須属性にすると、検索と監査の土台になります。
- 成果物IDと案件IDを分けて付与する
- 作成者・責任者・承認者を明記する
- 入力、処理、出力、評価を相互にリンクする
データ基盤と処理場所を管理範囲に含める
AIの品質はモデルだけで決まりません。収集、クレンジング、アノテーション、統合を経たデータの来歴と、クラウド・エッジなどの処理場所も、成果物の信頼性を左右する重要な管理対象です。
リアルタイム性が求められる現場では、処理方式の記録が欠かせません。従来のクラウド処理では数十秒かかっていた解析が、フォグ処理では数秒に短縮されます。遅延要件を台帳に残し、検証値と比較しましょう。
ファナックの事例では、従来10分かかっていた解析処理を数秒に短縮し、予防保全システムの精度向上を実現しています。製造・物流では、モデル精度に加え、判断が間に合うかを受入条件に含めるべきです。
- 収集元と利用許諾を記録する
- 加工手順とデータ版を保存する
- 処理遅延と可用性の要件を測定する
台帳は最小項目から始めて育てる
最初から高価な専用基盤を導入する必要はありません。スプレッドシートや既存のチケット管理を使い、登録漏れが起きにくい最小限の台帳項目から始めることが、定着への近道です。
最低限、成果物ID、名称、用途、所有者、機密区分、版、参照元、使用モデル、評価結果、承認状態、保存先URLを登録します。特に「廃止予定日」を持たせると、古いプロンプトやデータの放置を防げます。
大規模化したら、モデル・データ・プロンプトを横断して把握できるAIレジストリの設計と導入手順へ接続します。台帳を移行可能な形式で整えることが、ベンダー依存を抑える備えになります。
- 名称は「業務_用途_版」で統一する
- タグは部門・業務・機密性・状態で付ける
- 保存先ではなく責任者を起点に検索できるようにする
AI要件定義を成果物の起点として固める
業務課題から入力と出力を決める
AI要件定義では、先にツールを選ぶのではなく、解決したい業務課題と意思決定を定義します。誰が、どの入力を使い、どんな出力を受け、最終的に何を判断するかを具体的に言語化します。
要件書には、入力の種類、参照可能なデータ、出力形式、禁止事項、利用者、例外時の対応を記載します。RAG、画像判定、業務自動化、最適化といった4つの類型から、業務に必要な方式を選びます。
Gartner 2024年7月予測では、30%以上の生成AIプロジェクトがPoC(概念実証)の後に断念されるとされています。PoCの目的を精度確認だけにせず、運用責任と業務効果の検証まで含めることが重要です。
- AIで置き換えない人間の判断を明記する
- 失敗時のエスカレーション先を決める
- 入力データの更新頻度と責任部署を決める
受け入れ基準を要件段階で合意する
要件の完成条件は、曖昧な「便利になる」ではなく、観測できる受け入れ基準で決めます。AI要件定義の段階で、正答性、根拠表示、応答時間、禁止出力、手動確認の条件を合意してください。
ユーザーストーリーにはGiven-When-Then形式を用いると、業務担当者と開発担当者の解釈差を減らせます。「顧客情報を含む質問なら、許可済みの情報だけを根拠付きで返す」のように、条件と期待値を記述します。
精度は100%でなければ使えないわけではありません。70〜80%の精度でも業務に組み込める場合があります。ただし、誤りが許されない判断は人間承認を必須にし、利用範囲を限定する設計が必要です。
- 業務KPIと品質KPIを分けて設定する
- 正常系・異常系・境界条件を記述する
- 受入条件と評価データを要件IDで結び付ける
変更の影響を追える構造にする
AI要件定義は一度作って終わりではありません。データ、業務ルール、モデルの更新に伴い要件も変わるため、要求からテストまでをIDでつなぐトレーサビリティが不可欠です。
要件変更が起きたら、関連するプロンプト、API、参照データ、評価ケース、運用手順を一覧化します。変更理由、決定者、想定リスク、再テスト範囲を残せば、後からの説明と監査が容易になります。
実務では、従来は約7時間かかっていた要件定義書の作成が、最短10分程度まで短縮される例もあります。ただし短縮できるのは下書き作成であり、優先順位付けや責任判断まで自動化してはいけません。
- 要件・設計・テストに共通IDを採番する
- 変更は差分と理由をセットで記録する
- 法務・セキュリティの確認履歴を残す
プロンプト管理で再現性と安全性を高める
プロンプトは設定一式として保存する
プロンプト管理では、指示文だけをコピーして保存しても再現性は得られません。モデル名、温度、参照データ、ツール、出力スキーマ、実行環境を含めた実験単位として記録する必要があります。
例えば「ChatGPT-4」「Claude 3.5」で同じ指示を実行しても、応答形式や安全性は異なります。利用モデル、モデル版、パラメータ、実行日時を残し、同じ条件で比較できるようにしましょう。
業務別テンプレートには変数を設けます。顧客名や案件条件を変数化し、固定の安全指示と分離すれば、担当者が毎回書き換える範囲を抑え、誤入力や意図しない指示の混入を減らせます。
- プロンプトIDと版番号を必ず付ける
- モデル設定と参照データ版を紐付ける
- 機密情報の入力可否を明記する
承認済みの指示だけを本番利用する
本番環境で使うプロンプトは、作成者の個人メモから直接配布せず、draft、review、staging、production、deprecatedの状態を経て昇格させます。状態ごとの責任者と合格条件をあらかじめ決めます。
レビューでは、意図どおりの出力に加え、プロンプトインジェクション、機密情報の露出、不適切表現、過剰なコストを確認します。業務影響が大きい用途ほど、業務部門とセキュリティ担当の二者承認が有効です。
利用ログと業務成果を結び付けると、標準化の優先順位が見えます。対応時間が平均20~40%短縮したとしても、修正工数や問い合わせ増加を含めて評価しなければ、実際の効果は判断できません。
- 本番版は編集権限を限定する
- 承認者と有効期限を表示する
- 失敗時に直前版へ戻せるようにする
定期評価と廃止で品質低下を防ぐ
プロンプトは、モデル更新や参照情報の変更で性能が変わります。そのため、月次で使用頻度の高いプロンプトの効果検証を行い、四半期ごとにモデルアップデートを踏まえた大規模な見直しを実施します。
評価には代表例だけでなく、失敗しやすい質問、長文、曖昧な依頼、機密情報を含む依頼を入れます。変更前後の結果を比較し、品質、安全性、レイテンシー、コストのどれが悪化したかを確認します。
提案業務では、プロンプトの標準化で顧客からの質問が従来比50%減少した例があります。一方で使われないテンプレートは整理が必要です。廃止時は依存アプリケーションと代替版を確認してからアーカイブします。
- 利用回数が少ない版は廃止候補にする
- モデル変更時は回帰テストを行う
- 評価結果と利用者の声を同じ台帳に残す
AI評価データセットで品質を測定可能にする
評価用データは学習用データと分離する
AI評価データセットは、AIの品質を同じ尺度で継続測定するための検証用データです。学習や検索拡張に使ったデータと分けることで、既知の回答をなぞるだけの評価を避けられます。
最低限、正常例、例外例、禁止例、境界例を含めます。問い合わせAIなら、正しい回答だけでなく、情報不足時に保留できるか、権限外の情報を拒否できるかも評価対象にしてください。
各ケースには、入力、期待結果、評価観点、正解根拠、重要度、データ提供元、個人情報の有無を記録します。これにより、誤答を発見したとき、プロンプト、データ、モデルのどこを修正すべきか切り分けられます。
- 評価ケースに一意のIDを付ける
- 期待結果には根拠資料を添える
- 重要業務のケースは削除せず履歴を残す
品質指標は用途ごとに設計する
評価で重要なのは、単一の正答率だけに依存しないことです。生成AIでは、正確性、根拠性、完全性、形式遵守、安全性、回答時間を組み合わせ、業務リスクに応じた合格基準を設けます。
例えば要約では、原文にない事実を追加しないことが重要です。製造画像の検査では見逃し率、社内検索では根拠リンクの正しさ、顧客向け文章では表現の適切性を重く評価します。
評価者間で判断が揺れる項目は、具体例を添えた採点ガイドを作ります。AIによる自動採点は効率的ですが、重要ケースでは人間レビューを残し、評価の根拠そのものを成果物として保存します。
- 重大な誤りは加点方式ではなく即不合格にする
- 業務リスク別に重み付けを変える
- 定量指標と人間のコメントを併用する
データの機密性と利用権を確認する
AI評価データセットには、実案件の会話、画像、帳票が含まれがちです。持ち出しや外部モデル送信の可否をデータ単位で分類し、匿名化済みか、利用目的に同意があるかを確認します。
評価データを複数部署で共有する場合は、閲覧権限を最小化し、ダウンロード・更新・削除の監査ログを残します。テナント分離と保存期間の設定は、利便性より先に決めるべき統制です。
ソフトウェアやデータセットの利用条件も台帳に残します。Apache 2.0 ライセンスのように利用条件が明示された資産でも、著作権表示、ライセンス文、改変内容の扱いを確認してから成果物へ組み込みます。
- 原本と匿名化版を混在させない
- データ提供元と利用目的を記録する
- 削除依頼に対応できる保存場所を選ぶ
AI受入テストを運用開始後までつなげる
受入テストは業務で使えるかを確かめる工程
AI受入テストは、開発側の動作確認ではなく、利用部門が実業務で安全に使えるかを判定する工程です。要件で決めた受け入れ基準をもとに、実際の利用シナリオで合否を判断します。
テストでは、正しく答えるケースだけを試してはいけません。誤った前提、情報不足、権限外の質問、連続利用、障害時の案内などを含め、期待どおりに止まるか、担当者へ引き継げるかを確認します。
本番化の判定記録には、実施日、使用したデータセット版、モデル版、結果、不具合、例外承認、判定者を残します。この記録があれば、後日の問い合わせに対して導入時の判断根拠を説明できます。
- 業務部門が合否判定に参加する
- 不合格時の修正期限と責任者を決める
- 例外承認は期限付きにする
品質・安全・運用を同時に検証する
AI受入テストでは、回答品質だけでなく、可用性、応答時間、アクセス制御、監査ログ、障害時対応を確認します。高可用性が必要な業務では、99.99999%の可用性のような目標を掲げるだけでなく、測定方法と対象範囲を明確にします。
特に生成AIでは、もっともらしい誤答を検出する運用が重要です。根拠表示がない回答を保留にする、人間確認が必要な条件を画面に示す、利用者が問題を報告できる導線を設けるといった対策を検証します。
AIの結果をそのまま外部送信する業務では、著作権、秘密保持、委託契約も確認対象です。AI利用の開示要否、入力データの取り扱い、出力物の利用範囲を、法務確認済みのルールとして受入条件に組み込みます。
- 性能試験と業務シナリオ試験を分ける
- 誤答報告から改善までの流れを試す
- 利用規約・契約条件の確認者を残す
小さく導入し、運用指標で改善する
定着するAI成果物管理は、一斉展開よりも小規模な対象業務から始めます。まずは利用頻度が高く、判断基準が比較的明確な業務を選び、台帳登録、評価、承認、受入までの流れを一周させます。
あるプロンプト運用では、合計:21時間削減(従来比60%削減)という結果が示されています。ただし、削減時間だけで成功とせず、手戻り率、要件漏れ、受入不合格、問い合わせ件数も継続して追います。
国境を越えた開発体制では、記録の粒度が品質を左右します。ALION株式会社のように専属チームで伴走する開発では、業務側・開発側・運用側が同じ台帳と承認フローを見て、変更の認識差を早期に解消できます。
- 最初は一業務・一部門に範囲を限定する
- 月次でKPIと登録率をレビューする
- 改善内容を次のテンプレートに反映する
まとめ
AI成果物管理の本質は、生成物を保存することではなく、要件・データ・プロンプト・評価・承認を追跡可能にすることです。管理対象と責任者を明確にし、変更時に再評価できる仕組みを整えることで、AI活用を安全に拡大できます。
要点
- 成果物は出力、入力、モデル設定、評価、承認記録を含む
- 要件IDからプロンプト、評価、受入結果までを追跡する
- 本番プロンプトは承認・評価・廃止のライフサイクルで管理する
- 品質、安全性、業務効果を継続的に測定する
- 小規模な業務から台帳運用を始め、標準を育てる
まずは、現在使われているAIの成果物を10件だけ棚卸しし、所有者、用途、入力、プロンプト、評価、承認状態を記録してください。その一覧を起点に、再利用できる資産と見直すべきリスクを可視化しましょう。
よくある質問
Q1. AI成果物管理で最初に管理すべきものは何ですか?
最初は、用途、所有者、入力データ、プロンプト、使用モデル、出力、評価結果、承認状態です。これらを成果物IDで関連付けると、再現性と責任範囲を確保しやすくなります。
Q2. プロンプト管理はスプレッドシートでも始められますか?
はい。小規模なら開始できます。ただし、版番号、承認状態、利用モデル、評価結果、保存先、機密区分を必ず記録し、更新権限を限定してください。
Q3. AI評価データセットはどの程度用意すべきですか?
件数よりも業務上の重要ケースを網羅することが優先です。正常例だけでなく、例外、禁止、境界条件を含め、変更のたびに同じケースで比較できる構成にします。
Q4. AI受入テストで人間確認を残すべきケースは何ですか?
法的判断、対外発信、個人情報、金額確定、安全に関わる判断など、誤りの影響が大きい業務では人間による最終確認を必須にするべきです。
Q5. AI成果物の著作権や契約はどう管理しますか?
入力データの利用許諾、外部AIへの送信可否、生成物の利用範囲、委託先との責任分界を成果物台帳に記録します。重要案件は法務レビューの結果も承認履歴として残します。
参考文献・出典
資料39-1-2 新たな情報通信技術戦略の在り方 <平成26 年12 月18 日付け諮問第22 号> 第3次中間報告書 ~ 次世代AI×ICT データビリティ戦略 ~ ~ 次世代人工知能社会実装戦略 ~ 平成29 年7 月20 日 情報通信審議会 「次世代AI×ICT データビリティ戦略」 情報通信審議会…
www.soumu.go.jp
 # フォグコンピューティングとは?エッジコンピューティングとの違いやメリット・導入事例を解説  2. [レポート・書籍・コラム](/publication/) 3. [コラム](/publication/column/) 4. 生成AI活用時の委託者・受託者間成果物管理:著作権の不確実性に対する契約実務での対応策 #…
www.tokio-dr.jp