2026.09.29
AIデータ契約で守る学習データと権利
IT関連
AIデータ契約は、AI開発でデータを「渡す」ためだけの書面ではありません。誰が何のために使い、品質問題や漏えいが起きたときに誰が対応するかを、事業継続の観点で決める実務設計です。
生成AI、画像認識、予測モデルのいずれでも、価値の源泉は学習データと運用データにあります。一方、データの利用許諾と所有権を混同すると、再学習、外部委託、成果物の利用を巡る争いになりやすいため注意が必要です。
本記事では、工程別の契約、AIデータ品質の受入基準、AIデータ標準化の変更管理、AI匿名加工とデータクリーンルームの使い分けまでを一つの流れで整理します。契約書を運用可能なルールへ変える視点を持ち帰ってください。
AIデータ契約は利用権を設計する約束
最初に決めるべきは所有権ではなく利用権
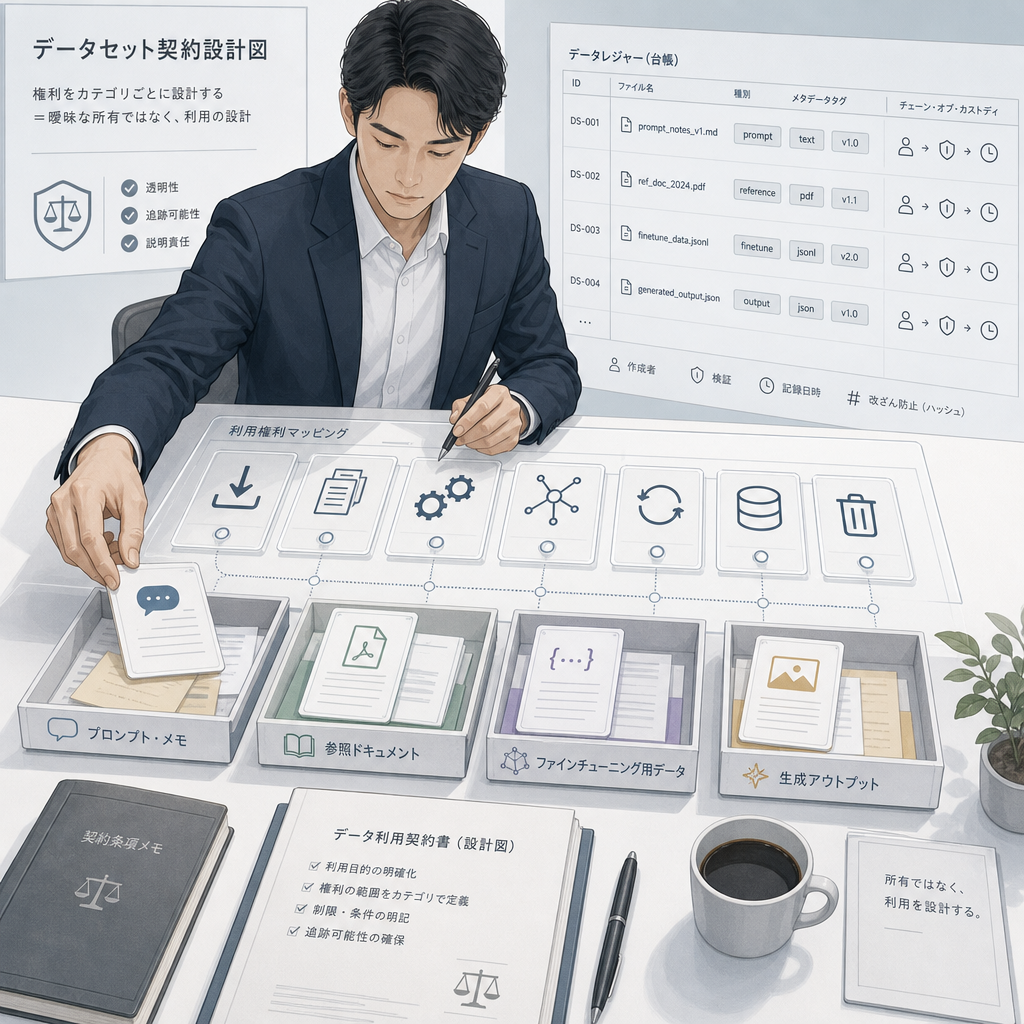
AIデータ契約の中心は利用権です。データそのものの所有権という曖昧な言葉だけに頼らず、取得、複製、加工、学習、再提供、保存、削除の各行為を、誰にどこまで許すか分解して定義します。
特に生成AIでは、入力プロンプト、RAG用の参照データ、ファインチューニング用データ、出力物を別々に扱う必要があります。ひとまとめに「データ」と書くと、検索インデックス化や委託先での保管が許されるか判断できません。
画像認識の人工知能を作るには、大量の画像データが必要です。音声認識の人工知能を作るには、様々な人の音声データが必要です。量だけでなく、撮影者・被写体・収集者の権利関係をデータ台帳で追える状態にします。
- 利用目的と禁止する目的外利用
- 地域・期間・再委託の可否
- 複製、加工、学習、再提供の権限
- 終了時の返却、削除、継続保管の条件
データの性質を契約の入口で分類する
契約前の分類は、条項の選択を速くします。構造化データか非構造化データか、パーソナルか非パーソナルかを、提供元の説明だけでなく実際の項目・ファイル単位で確認してください。
たとえば顧客IDを削除しても、他の情報との照合で個人を推定できる場合があります。個人情報、匿名加工情報、営業秘密、著作物を含むデータでは、利用条件と安全管理措置を同じ強度で設計できません。
データセット名、版数、取得元、収集目的、権利者、保持期限を記録すると、監査時の説明力が高まります。モデルに取り込んだ後も、元データに遡れるリネージュを残すことが、削除要請や紛争への備えになります。
- 構造化・非構造化の区別
- パーソナル・非パーソナルの区別
- 著作物・営業秘密の有無
- 由来と加工履歴の記録
取引類型に応じて対価と責任を変える
データ取引は、主に3つの類型で考えます。既存データを渡すデータ提供型、共同活動でデータを生むデータ創出型、複数者で使うデータ共用型・プラットフォーム型では、交渉すべき利益とリスクが異なります。
データ提供型では、利用範囲と対価を明確にし、提供者の過度な保証を避けます。データ創出型では、取得費、ラベル付け費、再学習費を誰が負担し、共同で生じたデータをどちらが再利用できるかを先に決めます。
共用型では、参加者が互いの営業秘密を見られない構造が重要です。利用量連動、固定額、成果連動のどれを採るとしても、計測方法、監査権、支払時期をタームシートで合意してから詳細契約へ進みます。
| 類型 | 主な対象 | 優先条項 | 対価の考え方 |
|---|---|---|---|
| データ提供型 | 既存データ | 利用目的・再提供 | 固定額・利用量連動 |
| データ創出型 | 共同取得データ | 帰属・費用分担 | 共同負担・成果連動 |
| 共用型 | 参加者のデータ | アクセス制御・監査 | 参加料・利用量連動 |
- 提供型は利用範囲と保証範囲を優先
- 創出型は費用と再利用権を優先
- 共用型は閲覧制御と監査を優先
開発工程ごとに契約をつなげる
工程別契約で曖昧な引継ぎを防ぐ
AI開発は一括契約にせず、段階ごとに合意を更新する方法が有効です。大きく分けてアセスメント、PoC、開発、追加学習の4つの段階があるんだ、と捉えると、必要なデータと責任範囲を整理しやすくなります。
評価段階では、秘密保持契約を結びます。ここではデータの閲覧範囲、持ち出し禁止、評価結果の秘密性を定め、目的達成後に試料を削除する手順まで確認します。
次に、実証実験段階では、導入検証契約を結びます。そして開発段階では、ソフトウェア開発契約を結びます。成果物の検収条件と、学習済みモデルを業務利用する権限を切り分けることが肝心です。
- 評価では秘密情報の範囲を特定
- PoCでは検証目的と中止条件を明記
- 開発では検収と成果物利用を分離
追加学習とモデル更新を契約に残す
追加学習の権限は、初期開発時に予約しておくべきです。最後に、追加学習段階、つまり人工知能をさらに賢くしていく段階では、再利用に関する契約を結びます。初期契約だけでは、運用データの二次利用に対応できません。
契約には、再学習に使えるデータの範囲、第三者モデルへの投入可否、性能劣化時の通知、停止基準を置きます。精度目標を約束する場合も、データ分布の変化や利用環境を前提条件として明記し、無制限の保証にしないことが重要です。
モデル更新のたびに、データセット版、プロンプト、評価結果、リリース承認者を記録しましょう。AI成果物管理の実践ガイドを参照すると、契約上の引渡物を追跡できる成果物単位に落とし込めます。
- 再学習対象と除外対象を列挙
- 性能劣化の通知・停止基準を設定
- モデル版と評価結果を紐付けて保管
終了時のデータとモデルを先に決める
契約終了後の扱いは、開始時に決めるほど紛争を減らせます。返却・削除・匿名化して継続保管するデータを分け、削除証明の提出方法と期限を定めます。バックアップやログに残る複製物も対象から漏らさないでください。
学習済みモデルは、元データを削除しても知識が残る可能性があります。そのため、継続利用を認めるのか、提供者の利用停止通知でサービス停止や再学習を要するのかを、用途別に合意する必要があります。
終了後も残すべきなのは、監査証跡と法令対応に必要な最小限の記録です。モデル、データ、プロンプトの利用状況を一元化する際は、AIレジストリの設計と導入手順が実務上の基盤になります。
- 削除対象にバックアップとログを含める
- モデル継続利用の可否を用途別に定義
- 削除証明と監査記録を分けて管理
AIデータ品質を受入条件に変える
品質要件は精度ではなく測定可能な条件で書く
AIデータ品質は、契約上の受入条件として数値化します。正確性、完全性、一貫性、適時性、代表性、ラベルの正確性を、用途に応じて定義しなければ、「使える品質」という曖昧な約束になってしまいます。
たとえば画像分類なら、ラベル定義、判定不能画像の扱い、重複率、アノテーター間の不一致時の再確認手順を定めます。RAGなら、出典の保持、更新日、検索結果の関連性、回答に引用できる範囲を品質条件に含めます。
JIS X 25012:2013 (ISO/IEC 25012:2008)は、データ品質を検討する共通言語の一つです。契約では規格名を掲げるだけでなく、どの品質特性を、誰が、どの検査で確認するかまで具体化します。
- 用途別の品質次元を選ぶ
- 測定方法と検査標本を明記
- 不合格時の是正方法を定義
受入検査と再ラベルの責任を分ける
品質事故を防ぐ鍵は、検収前のサンプル検査です。全件検査が難しい場合は、抽出方法、許容できる誤り、再提出の条件を合意します。提供者の自己申告だけで検収せず、利用者側の業務担当者も妥当性を確認します。
ラベル誤り、欠損、重複、偏りが見つかった場合、原因が収集仕様、作業手順、利用側の要件変更のどれかを切り分けます。そのうえで修正費、納期延長、再学習費を誰が負担するかを、原因帰属に応じて定めます。
分類精度が 90% 以上に到達する場合もある一方、データの母集団や評価方法が変われば同じ水準は保証できません。品質基準とモデル性能の指標を混同せず、各々の測定データを保存して因果を検証できるようにします。
- 抽出方法と合否基準を明記
- 誤りの原因を三者で切り分け
- 品質指標とモデル性能を別管理
運用中の品質劣化を監視する
データ品質は納品時だけでなく、運用中にも変化します。新しい商品の追加、入力画面の変更、収集機器の交換などで分布が変わると、モデルの判断が不安定になるデータドリフトが起こり得ます。
契約と運用手順には、監視頻度、アラートの受信者、調査開始の条件、再学習の承認者を置きます。データスチュワード、業務責任者、開発者の役割を分けることで、異常を見つけても対応が止まる事態を防げます。
AIイニシアチブのうち、企業全体でスケールアップに成功したのはわずか16%に過ぎません。品質監視を開発チームだけに任せず、現場の利用判断と契約上の変更管理に接続することが、継続利用の条件です。
- データドリフトの監視頻度を決める
- アラート後の責任者と期限を決める
- 再学習の承認記録を残す
AIデータ標準化で再利用できる形にする
標準化は企業間で意味をそろえる作業
AIデータ標準化は、データの意味と形式を共通化する作業です。項目名、単位、コード、日付形式、欠損値の表現をそろえることで、部門・委託先・システム間でデータを再利用しやすくなります。
投稿日 2024-09-25の解説でも、標準化は前処理として広く扱われています。ただし、企業データにおいて重要なのは数値変換だけではなく、顧客、商品、拠点といった業務用語を同じ意味で使えるようにすることです。
契約書には、データ辞書、コード体系、必須項目、更新通知の方法を別紙で添付します。CSVやAPIの仕様だけで済ませず、同義語や例外値の判断ルールも管理すると、委託先変更時の移行コストを抑えられます。
- 共通語彙とコード体系を定義
- データ辞書を契約別紙にする
- 例外処理と変更通知を規定
意味の標準化と数値変換を混同しない
業務データの標準化と、機械学習の特徴量変換は別の工程です。前者は意味・形式をそろえる作業であり、後者はモデルが数値を扱いやすくする前処理です。成果物と責任者も分けて管理します。
特徴量の標準化とは、データを平均0、標準偏差1に近づける前処理です。標準化後の値 = (元の値 – 平均) / 標準偏差で計算され、学習用データで算出した平均と標準偏差を検証・本番データにも一貫して適用します。
一方、代表的な正規化は、値を0〜1の範囲に変換する方法です。正規化後の値 = (元の値 – 最小値) / (最大値 – 最小値)であり、外れ値や将来値への対応を決めずに採用すると、本番運用で値が範囲外になるおそれがあります。
| 観点 | 業務データ標準化 | 特徴量標準化 | 正規化 |
|---|---|---|---|
| 主な目的 | 意味・形式の統一 | 分布の調整 | 範囲の調整 |
| 主な成果物 | データ辞書・マッピング | 平均・標準偏差 | 最小値・最大値 |
| 主な管理者 | 業務・データ管理者 | 分析・開発担当 | 分析・開発担当 |
- 業務標準化は意味と形式が対象
- 特徴量標準化は学習前処理が対象
- 変換パラメータの版管理が必要
変更管理を契約と運用に組み込む
標準化ルールは、一度決めたら固定ではありません。新商品、制度変更、統合先の追加によって項目やコードは変わります。ルール変更が学習データやAPI連携へ与える影響を評価し、承認後に版番号を更新します。
大規模な組織は1000台のシステムと数十万の統合ポイントを持っています。影響範囲が広い環境では、変更の発効日、後方互換性、旧ルールで作成されたデータの扱いを、契約と実装仕様の両方で明らかにします。
非構造化PDFや画像では、OCR誤り、項目抽出の信頼度、同義語統合のルールも対象です。低信頼度のデータを自動確定せず、人手レビューへ回す閾値と記録方法を設けることで、静かな誤りの蓄積を抑えられます。
- 変更要求の承認者を定める
- 発効日と互換性を管理する
- 低信頼度データのレビュー経路を作る
AIデータガバナンスで安全な共有を実現する
ガバナンスは契約を日常業務で守る仕組み
AIデータガバナンスは、契約上の約束を運用に変える統制です。データオーナー、利用承認者、データスチュワード、開発者、監査担当者の役割を決め、アクセス申請から失効までを記録可能にします。
権限管理では、閲覧できる人と、モデル学習へ投入できる人を分離します。最小権限、目的単位のアクセス、定期的な権限棚卸しを採れば、担当異動や委託終了後も不要なアクセスを残しにくくなります。
AIファーストの組織の68%が、成熟した十分に確立されたデータおよびガバナンスのフレームワークを報告しているのに対し、他の組織ではわずか32%です。体制を文書化し、契約違反の検知と報告経路を整備する価値は大きいといえます。
- 役割ごとの責任と権限を分離
- アクセス承認と失効を記録
- 定期棚卸しと監査を実施
AI匿名加工は再識別リスクを前提に設計する
AI匿名加工は、識別子を消すだけでは完了しません。直接識別子の削除に加え、準識別子の組合せによる再識別可能性、利用目的、第三者提供の有無を評価し、適切な加工手法と安全管理を選びます。
匿名化後のデータでも、外部データとの突合や属性の細かさによってリスクは変わります。したがって、加工前後の項目対応表は限定された担当者のみが保管し、利用者には必要最小限のデータだけを提供します。
AI匿名加工を契約へ組み込む際は、加工責任者、再識別の禁止、目的外の照合禁止、事故時の連絡・調査手順を定めます。加工済みデータの品質低下がモデル性能へ及ぼす影響も、事前評価の対象にしてください。
- 再識別リスクを利用目的ごとに評価
- 対応表へのアクセスを制限
- 再識別禁止と事故対応を明記
データクリーンルームで持ち出さずに分析する
データクリーンルームは、原データを相手へ渡さずに共同分析する選択肢です。参加者ごとにアクセスを制御し、許可された集計や照合結果のみを出力することで、データ共用型の取引における露出を抑えます。
ただし、データクリーンルームは契約を不要にする技術ではありません。持込み可能なデータ、照合キー、分析目的、出力の最小集計単位、結果の二次利用、ログの保存期間を、参加契約で具体的に定める必要があります。
秘密保持、競争上の懸念、個人情報保護を同時に扱う案件では、法務・セキュリティ・事業部門が設計段階から参加します。分析結果から個社の営業情報を推測できないかを検査し、出力審査を運用手順に組み込みましょう。
- 原データの持ち出しを抑制
- 出力の粒度と二次利用を制限
- 分析ログと出力審査を実施
まとめ
AIデータ契約は、データの権利、品質、標準化、安全な共有を一貫して扱うための設計図です。利用目的だけで終わらせず、工程別の契約、受入条件、変更管理、終了時の削除までつなげることで、AI活用を継続可能な事業へ近づけられます。
要点
- 利用権を行為単位に分解し、目的外利用を防ぐ
- 品質基準は測定方法、不合格時の是正、費用負担まで決める
- 標準化ルールと特徴量変換を区別して版管理する
- 匿名加工やクリーンルームでも、契約上の用途・出力制御を定める
- データ、モデル、評価結果を追跡し、終了後の扱いまで管理する
まずは、現在利用しているデータを「取得元・利用目的・利用者・品質基準・終了時の扱い」の5項目で棚卸ししてください。新規のAI開発や共同利用では、この台帳を起点に法務、現場、開発チームで契約条件をすり合わせることが有効です。
よくある質問
Q1. AIデータ契約で最も重要な条項は何ですか?
利用目的、利用期間・地域、再委託、再提供、学習利用、終了時の削除を具体化する条項です。所有権という一語ではなく、許される行為を分解して定めます。
Q2. PoCでも本契約と同じ水準の契約が必要ですか?
PoCでは、検証目的に必要な範囲へ絞った導入検証契約が実務的です。ただし、秘密保持、データの持出し制限、終了時の削除、成果の扱いは省略しないでください。
Q3. AIデータ品質はどのように契約へ書けばよいですか?
正確性や完全性などの指標、測定方法、検査対象、合格基準、不合格時の再提出・費用負担をセットで定めます。モデル精度とは別の指標として管理することが重要です。
Q4. データクリーンルームを使えば契約上のリスクはなくなりますか?
なくなりません。原データを持ち出さない利点はありますが、持込みデータ、照合方法、出力の粒度、二次利用、ログ管理を契約と運用ルールで定める必要があります。
Q5. AI匿名加工済みデータなら自由にAI学習へ使えますか?
自由に使えるとは限りません。再識別リスク、元の収集目的、契約上の利用制限、第三者提供の条件を確認し、学習利用と再提供の可否を個別に定める必要があります。
参考文献・出典
By [Alexandra Jonker](https://www.ibm.com/think/author/alexandra-jonkeribm-com) , [Judith Aquino](https://www.ibm.com/think/author/judith-aquino.html)…
www.ibm.com