2026.09.24
AI受入テストで業務利用の品質を守る実践法
IT関連
AI受入テストは、AIが技術的に稼働するだけでなく、実際の業務で安全かつ継続的に使えるかを最終確認する工程です。精度だけで合否を決めると、権限逸脱や誤案内、現場負荷といった本番特有の失敗を見落とします。
生成AIやAIエージェントは、同じ質問でも表現や結果が揺れる確率的な仕組みです。そのため従来の画面・機能テストに加え、出力内容、例外時の振る舞い、利用者の判断、監査証跡まで含めた受入条件が欠かせません。
本記事では、受入基準の作り方からAIプロジェクトKPIとの接続、AI出力検証、LLM評価、データセット設計、AI評価基盤とAI運用保守までを一連の実務として解説します。発注者・開発チーム・現場が同じ判断材料を持つための手順を確認しましょう。
AI受入テストで確認すべき業務適合性
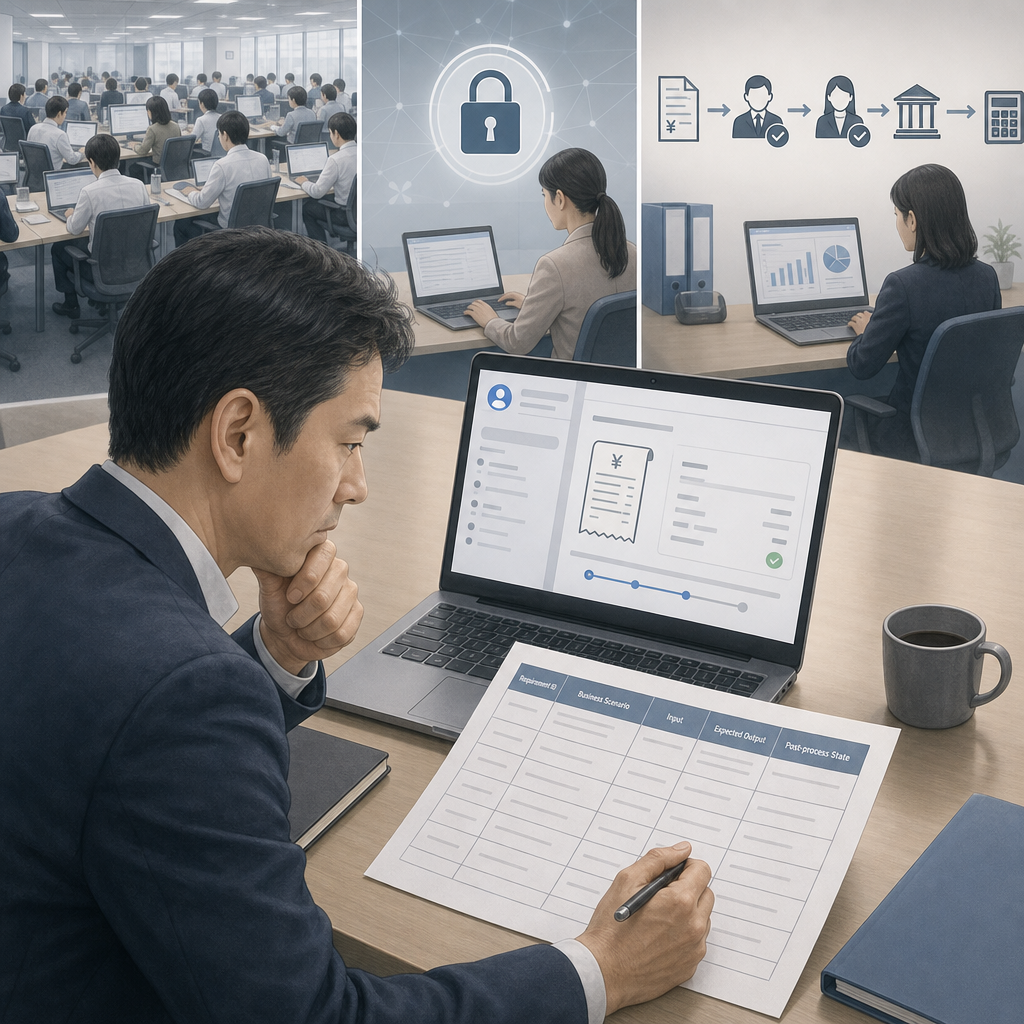
受入テストは本番業務で使えるかを判定する工程です
AI受入テストの結論は、機能が動くかではなく、業務責任者が本番利用を承認できるかです。単体テストやコンポーネントテストは部品の正しさを見ますが、受入テストは利用者、データ、権限、後続業務を通した価値と危険を確認します。
たとえば経費精算支援AIなら、回答の自然さだけでは不十分です。月末に全社員(約500名)が一斉にログインして経費精算システムを使った場合でも、応答性能、アクセス制御、問い合わせ導線が業務を止めないことを確認します。
E2Eテストは複数システムをまたぐ技術的な流れの確認に有効です。一方、受入判断では「担当者が結果を信頼して処理できるか」「誤答を訂正できるか」まで確認し、現場責任者が承認します。
- 単体テスト:関数や部品の仕様確認
- E2Eテスト:システム間連携と処理経路の確認
- 受入テスト:業務シナリオと利用条件での承認判断
受け入れ基準は要件IDから期待結果まで具体化します
受入基準は、曖昧な「便利で正確」を避け、要件ID、業務シナリオ、入力、期待出力、処理後の状態を一組にして記録します。誰が実行しても同じ結論に近づける書式が、検収時の認識差を減らします。
ECの割引コード機能なら、「5ステップ以内でチェックアウトを完了できる」を正常系の条件にできます。入力に誤りがある場合は、「Invalid or expired code」というメッセージが表示され、入力フィールドはクリアされない、と状態まで定義します。
生成AIでは期待出力を完全一致にしない場面もあります。その場合は、必須情報、禁止表現、根拠提示、有人確認への誘導を判定項目に分けます。合格、条件付き合格、不合格の責任者と再試験条件も、開始前に決めます。
- 正常系:目的の業務を完了できること
- 異常系:誤入力や連携失敗時に安全に案内すること
- 禁止動作:権限外操作や根拠のない断定をしないこと
手動確認と自動化は役割を分けて併用します
受入テストは、反復可能な確認を自動化し、業務判断を人が担う形が最も実践的です。固定入力への応答、API形式、権限エラー、回帰確認は自動化し、顧客影響や現場の納得感は利用部門が手動で確認します。
CIでは、すべてのPRに対してCIで実行します。という運用により、プロンプト、連携ツール、実装変更で既存要件が壊れたことを早期に検出できます。フィードバックループは数日から数分に短縮されます。
一方で、大きなリリースの最終承認を自動判定だけに委ねるべきではありません。利用者代表が代表シナリオを操作し、証跡、ログ、未解決リスクを確認したうえで、リリース可否を明確に署名・記録します。
- 自動化:回帰、形式、権限、固定ケースの検証
- 手動UAT:業務妥当性、説明品質、例外処理の確認
- 証跡管理:実行日時、入力、結果、ログ、承認者を保存
成果につなげるAIプロジェクトKPIの設計
KPIは受入条件を事業成果へつなぐ指標です
AIプロジェクトKPIは、受入合格を「導入してよい」という判断で終わらせず、導入価値が実現したかを追うための指標です。KGI、業務KPI、技術指標をつなぎ、精度が高くても使われない状況を見逃さない設計にします。
基本はPoC・本番・定着の3段階KPI設計です。PoCでは業務課題との適合、本番では安全性と利用開始、定着では工数・品質・収益への効果を測ります。各段階で継続、修正、撤退の判断条件を先に合意します。
KPIは多すぎると監視が形骸化します。重要な指標を3〜5個に絞り、ベースライン、目標、測定頻度、データ取得方法、責任者を定義してください。利用率だけを成功とせず、誤答率や手戻りも並べて見ます。
- 経営層:収益、コスト、リスク、投資対効果
- 現場:処理時間、完結率、手戻り、利用継続率
- 技術:応答時間、失敗率、評価スコア、変更影響
測定可能な目標と計算式を先に定めます
良いKPIは、対象業務と期限、比較基準が明確です。たとえば「2026年12月末まで」に、AIチャットボットを導入し、メールでの問い合わせ件数を月間500件から300件に削減する、というように受入後の成果まで言語化します。
問い合わせ業務では、一次回答完結率 ← AI回答件数 ÷ 全問い合わせ件数、と定義できます。ただしAIが回答数を増やしても、誤案内で再問い合わせが増えるなら成功ではありません。解決率、有人転送率、苦情件数も確認します。
費用対効果は、ROI = (効果 – 投資額)÷ 投資額 × 100%で比較できます。例: 10分/件 削減 × 1,000件/月 × 時給3,000円 = 50万円/月のように、削減時間を金額化し、検証・運用費用も投資額に含めます。
| フェーズ | 主な目的 | 受入時の確認指標 |
|---|---|---|
| PoC | 課題適合 | 評価スコア・業務適合 |
| 本番移行 | 安全な利用開始 | 失敗率・権限逸脱・応答時間 |
| 定着 | 成果の継続 | 利用率・工数・品質・ROI |
- ベースライン:導入前の件数、時間、品質を取得
- 先行指標:利用率、初回解決率、レビュー率
- 結果指標:人件費、売上、事故・手戻りの減少
KPI未達は原因を分けて改善判断します
KPI未達時は、モデル精度だけを疑わないことが重要です。利用導線、教育不足、データ欠損、承認フロー、季節要因などを分解し、対照群や段階導入でAIの効果と他施策の影響をできるだけ切り分けます。
導入初月の利用率は伸び悩むのが普通で、半年程度かけて定着していくケースが多くあります。したがって「利用率は70%です」という単発の報告ではなく、対象者、業務頻度、継続率、未利用理由を含めて判断します。
受入時にリスク調整済みの基準も設定します。たとえば処理時間を10分から30秒へ短縮(95%削減)しても、高重大度の誤案内が増えるなら、利益と損失を比較し、人手確認や対象範囲の縮小を選びます。
- 継続:成果と安全性が基準を満たす
- 修正:原因が特定でき、対策を再試験できる
- 停止:重大リスクや費用対効果の悪化が解消しない
AI出力検証で誤情報と危険な回答を防ぐ
出力検証は正誤だけでなく公開可否を決めます
AI出力検証では、回答が正しいかに加え、根拠、最新性、文脈への適切さ、安全性、公開可否を確認します。特に提案書、決裁資料、顧客回答、IR関連情報は、一見自然な誤情報が大きな損失や信用低下につながります。
重要文書は、主張単位で出典URL、引用箇所、取得日時、判定者を残す証拠台帳を作ります。公開前に根拠確認の対象を80% 以上確保する、といった運用基準を置くと、確認漏れを定量的に管理できます。
AI出力検証の結果は、正解・不正解の二択だけにしません。軽微な表現不備、要確認の主張、公開不可の誤情報に分類し、重大度に応じて修正、専門家レビュー、出力停止へつなげることが実務的です。
- 正確性:事実と数値が根拠に一致するか
- 適切性:対象者・目的・法令に合う表現か
- 安全性:差別、個人情報、危険行為を助長しないか
ハルシネーションはリスク別に扱います
ハルシネーション対策は、「誤りを減らす」だけでは足りません。誤った金額、存在しない制度、架空の引用、古い情報の断定、文脈を外した助言など、業務影響の異なる誤りを分類して、受入基準を変える必要があります。
低リスクの社内たたき台なら、利用者が原典を確認する前提で使えます。一方、顧客・行政・投資家に出す内容は、人間の専門家による確認を必須にし、AIが作ったことではなく、誰が根拠を承認したかを残します。
検証担当者には批判的思考も必要です。回答のもっともらしさに引きずられず、反証となる情報、欠けた前提、代替案を探します。AIの回答を鵜呑みにしないワークフロー自体が、受入品質を左右します。
- 高リスク:外部公開、契約、医療・法務・財務判断
- 中リスク:顧客対応案、社内意思決定資料
- 低リスク:構成案、要約、社内の初稿作成
再現可能な検証ログが説明責任を支えます
検証結果を再現するには、質問文だけでは不十分です。モデル名、プロンプト、温度設定、検索対象、接続ツール、実行日時、取得した根拠を記録し、同じ条件で再試験できる状態にします。
外部情報を参照するAIでは、検索結果やAPI応答が変化します。そのため受入証跡には、参照元の保存可否、情報更新時の扱い、再実行担当者を含めます。機密情報を扱う場合は、保持期間、学習利用、国外移転、削除手続きも確認します。
誤公開が起きた場合は、訂正、影響範囲の特定、利用者への通知、再発防止までを手順化します。検証ログがあれば、何が原因だったかを追跡でき、問題を個人の注意力だけに帰さず仕組みとして改善できます。
- 入力条件:質問、文脈、モデル、ツール設定
- 判定根拠:出典、確認日時、判定理由
- 承認記録:公開者、承認者、再検証条件
LLM評価は確率的な出力を継続測定する
LLM評価は一回の成功ではなく安定性を測ります
LLM評価では、単発で正しい回答が出たことを合格根拠にしません。同じ条件でどの程度安定して期待水準を満たすかを測り、業務リスクに応じた許容失敗率と再試験ルールを定めます。
候補抽出型の業務なら、必須候補10件中9件なら再現率は90%である。というように、見落としの少なさを評価します。一方、出力した12件のうち正解が9件なら適合率は75%になる。ため、不要な候補の混入も別に確認します。
自由回答では、正解性、根拠性、指示遵守、簡潔性、安全性を採点基準に分けます。採点者の主観だけに頼らず、具体例を含む判定ガイドを用意し、複数人の判定差をレビューして基準を調整します。
- 再現率:必要な情報を取りこぼさない度合い
- 適合率:出した情報が正しい度合い
- 安定性:繰り返し実行で基準を満たす度合い
試行回数と重大度を合否条件に組み込みます
確率的な回答を扱う受入では、5回実行して成功回数を記録する。という基本ルールが有効です。失敗の内容も併記し、表現の揺れなのか、根拠のない断定なのか、権限を超える操作なのかを区別します。
高重大度の禁止動作は、平均スコアが良くても1件で不合格にすべきです。たとえば個人情報の露出、承認なしの外部送信、危険行為の誘導は、成功率の平均で相殺せず、ゼロ許容のゲートとして扱います。
逆に軽微な言い回しの差は、業務影響と修正可能性を踏まえて条件付き合格にできます。このように精度、安全性、損失額、法令違反リスクを重み付けすると、数値が高いだけの評価から実用的な受入判断へ進めます。
- 必須条件:禁止動作が発生しないこと
- 品質条件:評価項目の基準点を満たすこと
- 再試験条件:変更後に関連ケースを再実行すること
変更管理と回帰試験をLLM評価に組み込みます
LLM評価は、初回受入で終わりません。モデル更新、プロンプト修正、検索インデックス更新、外部ツールの変更により、以前は合格だったシナリオが失敗するため、変更管理と結び付けて継続します。
実行条件は、指示文v1.4、連携ツールv2.1、5回実行のように版数まで固定します。条件が変われば結果の比較可能性が失われるため、変更理由、影響範囲、承認者を記録してから回帰試験を開始します。
たとえば指示文または権限変更時に関連12ケースを再実行します。全件を毎回同じ深さで確認するのではなく、変更箇所に関連するケースを必須とし、重大機能は追加で人手確認する運用が効率的です。
- 変更検知:モデル、プロンプト、権限、ツール、データ
- 影響分析:変更箇所と関連シナリオを対応付ける
- 再承認:結果と残余リスクを確認してリリースする
AI評価データセットで本番に近い試験を作る
評価データは本番の業務分布を表す必要があります
AI評価データセットは、モデルの良し悪しを測る物差しです。本番の利用者、質問、例外、データ品質を代表していなければ、高い評価スコアでも実運用で失敗します。まず対象業務の入力を分類し、頻度と影響度でケースを選びます。
問い合わせAIなら、よくある質問だけを集めると、困難な問い合わせで破綻します。通常の依頼、曖昧な表現、誤字、複数条件、情報不足、怒りを含む文章、権限外の依頼を含め、現場が実際に遭遇する分布を反映させます。
データセットには正解だけでなく、許容できる回答範囲、必ず確認すべき根拠、禁止される応答、有人引継ぎ条件を注記します。これにより、開発者と業務担当者が同じ品質定義でAI受入テストを実施できます。
- 代表性:頻出ケースと高影響ケースを含める
- 多様性:入力形式、利用者、言語、例外を含める
- 追跡性:各ケースと要件ID・リスクを結び付ける
機密情報は匿名化と合成データで保護します
本番データをそのまま評価に使えない場合は、個人情報や機密情報を匿名化し、必要に応じて合成データを組み合わせます。ただし、識別子を消すだけでは不十分で、自由記述や複数項目の組み合わせから再識別されないかを確認します。
合成データは安全性を高めますが、現実にない偏りを持つことがあります。実データの傾向と比較し、入力の長さ、語彙、例外率、業務パターンが大きく乖離していないかを、データ管理責任者と確認してください。
評価用データが学習データやプロンプト例に混入すると、実力以上の結果が出ます。データの作成者、利用目的、保管場所、アクセス権、改版履歴を管理し、評価データ汚染を防ぐことが信頼できる判定の前提です。
- 保護:匿名化、マスキング、アクセス制御
- 代表性:実データとの分布差を確認
- 汚染防止:学習・例示・評価データを分離
データセットは失敗事例で継続的に育てます
最初から完全なAI評価データセットを作る必要はありません。運用中に発生した誤答、利用者からの指摘、監査で見つかった抜け漏れを、個人情報を除去したうえでケース化し、次回の回帰試験に追加します。
追加ケースは、単なる失敗の保存ではなく、原因と期待動作を明確にします。入力の曖昧さ、検索データ不足、ツール連携失敗、権限設定、プロンプト解釈のどこに問題があったのかを分類すると、対策の優先順位が見えます。
業務や規程が変われば、正解も変わります。古いケースを残し続けるのではなく、利用期限、見直し日、廃止理由を管理し、現行ルールに合う評価セットを維持することが、誤った合格判定を防ぎます。
- 新規追加:インシデント、苦情、レビュー指摘
- 定期見直し:規程、商品、業務手順の変更
- 廃止管理:古い正解や不要なケースを更新
AI評価基盤とAI運用保守で品質を維持する
評価基盤はテスト結果を判断可能な形で集約します
AI評価基盤は、テストケース、実行結果、ログ、評価スコア、承認記録を一元管理し、いつ、何を、どの条件で評価したかを追えるようにする仕組みです。表計算だけで管理できなくなった段階で、特に効果を発揮します。
基盤では要件IDとテストIDを結び、モデルやプロンプトの版数、入力、出力、判定根拠を保存します。これにより、リリース後の不具合が見つかったときも、どの変更から影響が出たのかを追跡しやすくなります。
ダッシュボードには合格率だけでなく、高重大度失敗、未承認ケース、評価データの更新状況、実行不能だったテストを表示します。見栄えのよい平均値ではなく、意思決定を止める問題が見える設計を優先してください。
- 評価管理:ケース、基準、実行条件、結果
- 証跡管理:ログ、根拠、承認、変更履歴
- 可視化:重大失敗、傾向、未対応リスク
運用保守は品質劣化を早く検知する活動です
AI運用保守は、リリース後に障害を直すだけの作業ではありません。利用状況、回答品質、費用、レイテンシ、セキュリティ事象を監視し、品質ドリフトを早期に発見して再評価する活動です。
モデル提供者の更新や外部APIの仕様変更は、アプリケーション側のコード変更なしに挙動を変えることがあります。定期評価と変更時評価を分け、重要な業務では代表ケースを継続実行して、受入時の水準からの差を確認します。
運用チームだけに判断を任せると、業務影響が見えにくくなります。開発、情報セキュリティ、業務部門、法務・コンプライアンスが、重大度別の連絡先と停止権限を合意し、異常時の対応時間を短縮します。
- 監視対象:品質、利用量、費用、応答時間、安全性
- 検知契機:モデル更新、データ更新、苦情、KPI悪化
- 対応手段:制限、ロールバック、有人化、再受入
契約と責任分界を受入条件に反映します
外部ベンダーと進めるAI開発では、検収条件を「画面が完成したこと」だけにしないことが重要です。受入基準、評価データの責任、再試験の範囲、障害時の連絡、ログ保管、瑕疵対応を、契約・SLAと矛盾しない形で定めます。
発注者は業務要件、承認権限、データ利用条件を明確にし、ベンダーは実装条件、既知の制約、再現手順を説明します。AIが自律的に判断する範囲と、人間が最終判断する範囲を分けることが、責任の曖昧化を防ぎます。
ALION株式会社のように専属チームで伴走する開発体制を活用する場合も、評価を丸投げにはしません。現場責任者が受入に参加し、実際の業務シナリオで確認することで、開発品質と業務価値を両立しやすくなります。
- 発注者:業務要件、データ権限、最終承認
- 開発側:実装、試験証跡、制約と再現条件
- 共同管理:変更承認、インシデント対応、再受入
まとめ
AI受入テストは、AIの精度確認にとどまらず、業務適合性、安全性、出力根拠、データ品質、運用継続性をまとめて判断する仕組みです。受入基準とKPI、評価データ、変更管理をつなげることで、導入時だけでなく利用が広がった後も品質を守れます。
要点
- 要件ID・入力・期待出力・処理後の状態を含む受入基準を作る。
- 精度だけでなく、AIプロジェクトKPI、利用率、リスク、ROIで価値を判断する。
- AI出力検証は根拠・公開可否・証跡まで管理し、重要文書は人が承認する。
- LLM評価、AI評価データセット、AI評価基盤を変更管理とAI運用保守へ接続する。
- 重大な禁止動作は平均スコアで相殺せず、明確な不合格条件として扱う。
まずは対象業務を1つ選び、代表的な正常系・異常系・禁止動作を受入ケースとして書き出してください。次に、承認者、評価データ、再試験条件、運用時に追うKPIを決めれば、AIを安心して業務へ定着させる土台が整います。
よくある質問
Q1. AI受入テストと通常のシステムテストは何が違いますか?
通常のテストが機能・性能・連携の正しさを主に確認するのに対し、AI受入テストは実際の業務で使えるか、誤答時に安全か、利用者が判断できるかまで含めて承認します。
Q2. LLMの出力が毎回異なる場合、どう合否を決めますか?
完全一致ではなく、必須情報、禁止動作、根拠性、安全性などの評価項目を定めます。同条件で複数回実行し、成功回数と失敗の重大度を記録して判定します。
Q3. 受入テストはリリース前に一度だけ実施すればよいですか?
いいえ。モデル、プロンプト、権限、連携ツール、評価データが変わると結果も変化します。変更時の回帰試験と、運用中の定期監視を組み合わせることが必要です。
Q4. 評価データに本番データを使えない場合はどうしますか?
匿名化したデータや合成データを使えます。ただし本番の質問傾向や例外を十分に表しているか、学習データへ混入していないかを確認し、アクセス権と改版履歴を管理します。
Q5. 誰がAI受入テストの最終承認をすべきですか?
技術面は開発・品質担当、業務適合性は現場責任者、リスク面はセキュリティや法務・コンプライアンスが確認し、業務責任を持つ承認者が最終判断する体制が適しています。
参考文献・出典
[メインコンテンツへスキップ](#main-content) AI更新: # AIプロジェクトのKPI設定|3層ツリーとフェーズ別の決め方・形骸化を防ぐ4原則  石川 瑞起…
syusodo.co.jp
[サインイン](/auth/cognito/sign-in)[お問い合わせ](https://calendly.com/contact-hmul/schedule)[無料で始める](/auth/cognito/sign-up) # 受け入れテストとは?AI 開発時代における UAT…
www.testsprite.com
 # 生成AIの出力情報をプロの眼で精査 「AI出力検証サービス」を提供開始 ### そのAI出力、本当に正しいですか?…
newscast.jp