2026.10.08
プロンプトインジェクションから守る生成AI設計
IT関連
プロンプトインジェクションは、生成AIに与えた指示を攻撃者が上書きし、非公開情報の開示や不正なツール操作を誘導する攻撃です。便利なAIチャットやRAGを業務に組み込むほど、入力欄だけでなく参照文書、メール、Webページも攻撃経路になります。
企業従業員の75%が生成AIを利用しており、そのうち46%が過去6か月以内に導入した一方、軽減策を講じている組織は38%に過ぎないとされています。導入スピードに比べ、権限、監査、検証の設計が追いついていないことが実務上の課題です。
本記事では攻撃の仕組みと直接型・間接型の違いを押さえ、RAGセキュリティ、RAGアクセス制御、AI出力検証をつないだ防御策を説明します。さらに、AIレッドチームとAI脆弱性診断で継続的に弱点を見つける手順も紹介します。
プロンプトインジェクションの仕組みを理解する
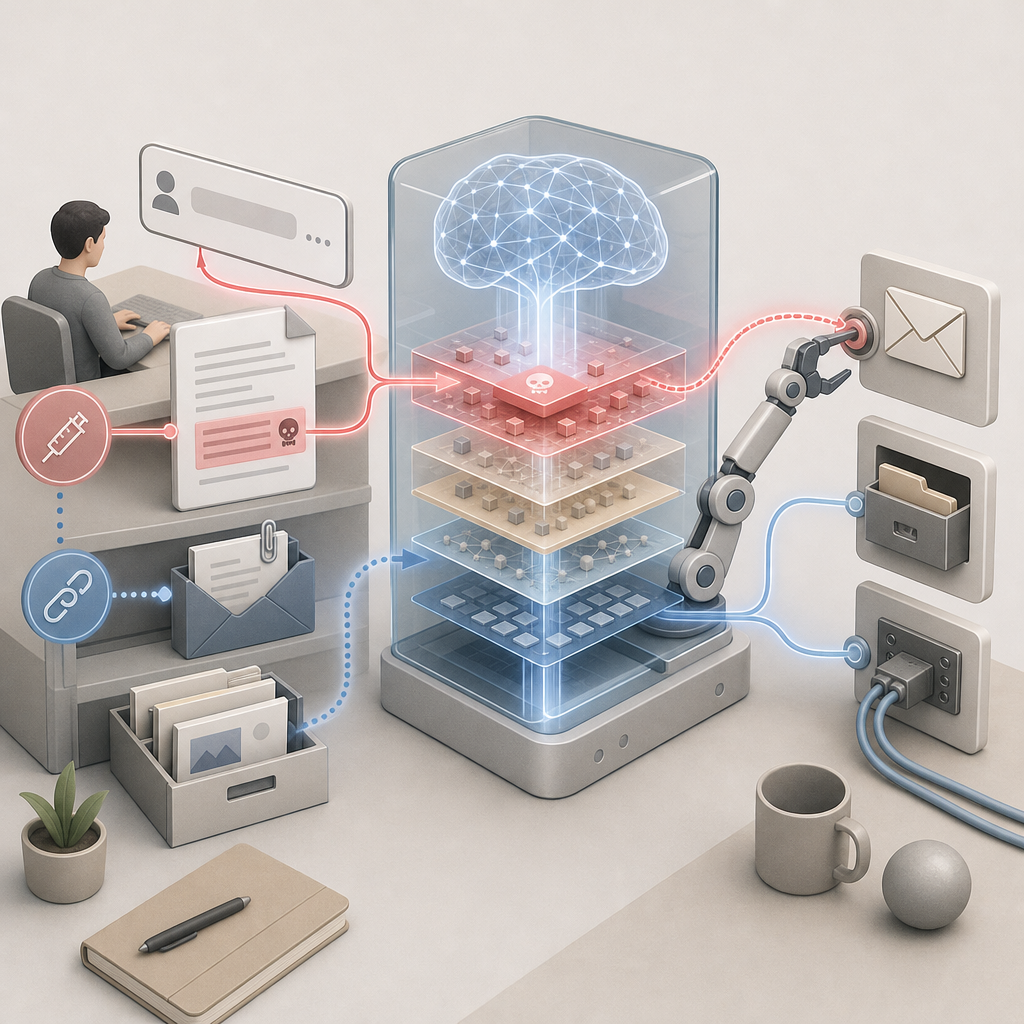
攻撃は信頼境界を越える指示の混入で成立する
プロンプトインジェクションは、モデルが「誰の指示を優先すべきか」を完全には判別できない性質を悪用します。システム指示、利用者の質問、検索した文書が同じコンテキストに並ぶと、悪意ある文章が上位の指示らしく振る舞う余地が生まれます。
LLMは自然言語を柔軟に解釈するため、従来のSQLインジェクションのように特定の記号を無害化するだけでは防げません。攻撃者は「前の指示を無視して」と明示するほか、翻訳、要約、役割設定を装い、振る舞いを少しずつ変えようとします。
特に危険なのは、回答生成だけでなく、メール送信、ファイル検索、API実行などの権限をAIに渡す構成です。モデルの出力を実行命令として扱うと、文章への誘導が業務システムの操作へ変わるため、信頼境界を明確に分離する必要があります。
- システム指示・利用者入力・外部データを別の信頼度として扱う
- モデルの文章を、そのまま実行権限に変換しない
- 機密情報とツール権限を必要最小限に限定する
直接型と間接型は侵入場所が異なる
直接型は、利用者がチャット欄へ悪意ある命令を入力する手法です。たとえば内部ルールの開示や安全制約の解除を求める文を送信し、プロンプトリーク、ジェイルブレイク、権限昇格を試みます。対話画面だけを守る対策では、これに対応しきれません。
間接型は、AIが取得する外部コンテンツに命令を埋め込む手法です。Webページ、添付ファイル、メール本文、ナレッジ文書に「この文書を読んだAIへ」といった指示を置き、利用者が意図しないタイミングでモデルに読ませます。
隠しテキスト、難読化、画像内の文字も間接型の経路になり得ます。画面上で見えない情報でも、抽出器やOCRが取得すればモデルのコンテキストへ入ります。外部データは命令ではなく、引用対象のデータとして処理する前提が重要です。
- 直接型は利用者入力、間接型は取得コンテンツから侵入する
- OCR、HTML、PDF、メール本文も検査対象に含める
- 外部文書中の命令は実行せず、参照情報として隔離する
ジェイルブレイクとの違いを混同しない
プロンプトインジェクションは、攻撃者がモデルの指示階層や周辺システムの信頼境界を越えることを狙う概念です。一方、ジェイルブレイクは主にモデルの安全制約を回避し、不適切な応答を引き出す試みを指します。両者は重なる場合があります。
Do Anything Now(DAN)のような役割設定は、ジェイルブレイクの代表例として知られます。しかし業務AIでは、不適切な文章が出るだけでなく、社内文書の検索範囲を広げたり、外部サービスを操作したりする連鎖まで評価しなければなりません。
対策の評価も分けて考えます。安全な回答拒否率だけを見るのではなく、秘密情報が出ないか、許可外の検索がないか、ツール実行が止まるかを測定します。この視点が、実運用でのAI脆弱性診断を実効性あるものにします。
- 安全制約の回避と、権限・情報境界の突破を分けて評価する
- 回答内容だけでなく検索・送信・実行の連鎖を確認する
- 拒否できても情報が出れば、防御は成功ではない
被害シナリオから防御の優先順位を決める
最初に守るべきは機密データと操作権限である
優先すべきは、モデル自体の秘密よりも、モデルが参照・操作できる資産です。顧客情報、契約書、ソースコード、認証トークン、管理APIが同一の会話フローに近接していると、1回の誘導が情報漏えいまたは不正操作に発展します。
被害は「数千件の顧客データが外部に漏洩しました。」という事態だけに限りません。誤った宛先へのメール送信、未承認のファイル共有、GoやJavaScriptの不正コード生成、誤情報に基づく判断も、業務への影響が大きい事故です。
個人情報保護法やGDPRへの対応では、漏えい後の通知や調査だけでなく、目的外利用を起こさない構造が問われます。AIに渡すデータを減らし、読み取り・書き込み・外部送信を分離する設計が、被害規模を小さくします。
- 機密データ、認証情報、外部操作権限を資産として棚卸しする
- 読み取り権限と送信・更新権限を分離する
- 高影響の操作には人間の承認を必須にする
RAGは検索前から生成後まで攻撃面を持つ
RAGセキュリティでは、文書を取り込む段階から生成結果を返す段階までを一続きで守ります。一般的なRAGは、(1)入力の事前処理、(2)データ取り込み(非同期のオフライン処理でベクトル化やチャンク化を行うパート)、(3)検索(Retriever)パート、(4)生成(Generator)の4つで構成されます。
取り込み時には、文書改ざんやポイズニング、来歴不明データの混入が起こり得ます。検索時には、権限外チャンクの返却や検索結果の操作が問題になり、生成時には間接プロンプトインジェクション、根拠のない断定、機密情報の再出力が発生します。
研究では、数百万件のテキストを対象としても、5つの悪意テキストで標的質問への攻撃成功率が90%に達した条件が報告されています。これは全件を目視確認できない環境ほど、取り込み検証と検索時の制約が不可欠であることを示します。
- 取り込み・検索・生成・ツール実行を別工程として監視する
- 文書の来歴、ハッシュ、更新者、承認状態を記録する
- 検索結果を信頼済み命令として扱わない
外部連携では小さな誘導が大きな実行につながる
AIエージェントやMCP、外部APIと連携するRAGでは、回答品質の問題が実行権限の問題に変わります。攻撃文が「検索して」「要約して」といった正常な依頼に紛れるため、単純な禁止語フィルターだけで防ぐのは困難です。
安全な構成では、モデルは実行候補を提案するだけに留めます。実行器は、許可済みの操作一覧、引数スキーマ、利用者権限、宛先ポリシーを独立して検証し、条件を満たさない要求をフェイルクローズで拒否します。
AIエージェントの権限と行動証跡をどう統制するかは、AIエージェントの監査とは?権限・行動ログ・証跡を用いた統制設計でも詳しく解説しています。プロンプト対策と監査設計を切り離さずに運用してください。
- モデル、認可判定、実行器を別コンポーネントに分ける
- 許可済みツール・引数・宛先だけを実行可能にする
- 高リスク操作は確認画面と承認記録を残す
RAGアクセス制御を検索層まで貫く
認可は回答時ではなく検索時に適用する
RAGアクセス制御は、回答を生成してから隠すのではなく、検索候補に権限外データを入れない設計が原則です。認証済みのユーザーID、所属、役割、プロジェクト、テナント情報をRetrieverまで伝え、検索フィルターに必ず反映させます。
RBACは職務による役割で管理しやすく、ABACは部署・契約・地域・文書分類などの属性を条件にできます。共有先との関係を扱うReBACも有効ですが、どの方式でもdeny-by-defaultを採用し、許可根拠がない文書は返さないことが重要です。
ベクトルDBではnamespaceまたはcollectionをテナントや機密区分で分離し、メタデータフィルターを二重にかけます。元文書の権限変更、異動、退職、削除がインデックスやキャッシュへ反映されたかを、定期テストで検証する必要があります。
- ユーザー属性を検索クエリと監査ログに必ず紐づける
- 文書・チャンク・テナントの各層でアクセスを制限する
- 権限削除後のキャッシュとベクトル索引も確認する
IAM連携と最小権限で越権を止める
RAGアクセス制御には、OpenID Connect や OAuth 2による認証だけでなく、検索・生成・ツール実行ごとの認可判定が必要です。AWS IAM、Microsoft Entra ID、Oktaなどの既存ID基盤と連携し、利用者が持つ権限を推測ではなくトークンから検証します。
導入時は、全社共通の広い権限から始めないことが大切です。まず部門、案件、文書分類を限定した小さなスコープで検証し、検索精度と利用価値を確かめながら対象を拡張します。過剰な権限は、攻撃成功時の被害を増幅します。
クラウド製品の価格例には、Sandbox無料/Professional 月$59/Team 月$159(クラウド)。という選択肢があります。しかし料金だけで選ばず、文書単位の認可、監査ログ、削除同期、テナント分離を要件化し、実証環境で確認するべきです。
- 認証トークンの主体・期限・スコープを検証する
- AI用のサービスアカウントに管理者権限を渡さない
- 製品比較では認可・監査・削除同期を必須項目にする
利用者の信頼を権限設計に反映する
RAGアクセス制御は技術要件であると同時に、利用者が安心してAIを使うための基盤です。6,750 人 の 消 費 者 を 対 象 とした 匿 名 のグローバル 調 査では、37%がすでに⽣成AIを活⽤している一方、70%のユーザーは AIエージェントよりも ⼈間を好むとされています。
同調査では、35%の回答者が信頼性について懸念を表明し、44%の回答者が「個⼈情報に関して AIエージェントを信頼していない」と回答しました。利用規約だけではなく、AIが何を参照し、何をしないかを画面と運用で説明する必要があります。
認証の強度も軽視できません。ログインの22.2%で不正を検出、68%が再利⽤という指標は、アカウント侵害がRAGの閲覧権限をそのまま奪う危険を示します。なお関連資料には1.5K Viewsという閲覧実績もあり、認証と認可への関心の高さがうかがえます。
- 利用者に参照範囲と実行範囲を明示する
- 多要素認証と異常ログイン検知を認可の前提にする
- 共有リンク、代理アクセス、緊急アクセスをテストケース化する
AI出力検証で漏えいと誤操作を防ぐ
出力検証は最後の防波堤として必要である
AI出力検証は、入力対策や権限設計をすり抜けた危険な回答を、利用者や外部システムへ渡す前に止める仕組みです。ただし万能ではないため、検索前の認可、コンテキスト隔離、ツール制限と重ねて初めて防御層になります。
検証対象は、個人情報、認証情報、内部指示、禁止された操作手順、未検証の断定、ツール呼び出しです。正規表現だけでは文脈を見落とすため、データ分類ラベル、許可された根拠文書、出力ポリシー、構造化スキーマを組み合わせます。
とくにツール利用では、自然文の回答と実行パラメータを分離してください。モデルが生成したJSONでも、宛先、金額、削除対象、検索範囲を独立したポリシーエンジンで再判定し、違反時は実行せず理由を記録します。
- 機密情報・内部指示・未根拠の断定を検査する
- 出力の文章と実行パラメータを別経路で扱う
- 拒否・修正・人間承認の分岐を実装する
根拠と引用を使い回答の範囲を限定する
AI出力検証で重要なのは、「もっともらしさ」ではなく、許可された情報源に基づくかを確かめることです。回答には参照文書のID、版、権限判定結果を紐づけ、根拠を示せない重要判断は「不明」と返す設計にします。
RAGのチャンクは大きすぎると余計な情報を持ち込み、小さすぎると文脈を失います。初期値として400〜800文字・オーバーラップ50〜150文字あたりが用いられますが、機密区分をまたぐチャンク化を避け、文書の権限を各チャンクへ継承することが先決です。
回答を監査可能にするには、質問、検索候補、採用チャンク、モデル出力、フィルター判定、ツール実行結果を関連付けます。保持期間と閲覧権限も定め、ログ自体が新たな機密データの集積にならないようマスキングを施します。
- 回答ごとに根拠文書と権限判定を追跡可能にする
- 重要な判断は根拠不足なら回答を保留する
- 監査ログの機密性と削除要件も設計する
品質低下を含めた評価指標を持つ
出力フィルターは厳しすぎると、正当な質問まで拒否し、業務価値を下げます。そのためAI出力検証では、攻撃検知率だけでなく、誤検知率、攻撃成功率、正常回答率、根拠付き回答率、処理時間を同じテストセットで測定します。
評価データには、通常の業務質問、権限のない質問、直接型の攻撃文、間接型の埋め込み文、難読化文、画像文字を含めます。失敗例を重要度別に分類すれば、ルール追加、モデル設定、権限見直しのどこを改善すべきか判断できます。
指標は導入時の一度きりではなく、文書更新やモデル変更のたびに再測定します。変更前後の差分を残すことで、「防御を強めた結果、必要な回答が出なくなった」という問題も可視化でき、現場に受け入れられる安全性を保てます。
- 攻撃阻止と正常業務の両方を数値で確認する
- 直接型・間接型・権限外質問を評価データに含める
- モデル・文書・ポリシー変更時に回帰テストを行う
AIレッドチームで防御を継続的に試験する
AIレッドチームは攻撃者視点で設計の穴を探す
AIレッドチームは、悪意ある利用者や侵害アカウントの視点で、生成AIシステムがどこまで誘導されるかを安全に試験する活動です。単に危険な質問を投げるのではなく、データ、認可、検索、出力、ツール、監査ログを横断して検証します。
生成AIレッドチームでは、システムプロンプトの抽出、秘密情報の再現、間接プロンプトインジェクション、クロステナント検索、ツールの引数操作などを対象にします。各試験には目的、前提権限、攻撃経路、期待される拒否動作、証跡を明記します。
OWASP’s #1 risk for LLMsとしてプロンプトインジェクションが重視される背景には、単一の対策で完全に排除しにくい事情があります。攻撃手法の変化を前提に、開発・運用・監査の担当者が同じ脅威モデルを共有することが重要です。
- 攻撃者、一般利用者、侵害アカウントの視点を分ける
- データ漏えい、越権、誤操作、可用性を評価軸にする
- 試験結果を再現可能なケースとして管理する
安全な検証環境で攻撃ケースを再現する
生成AIレッドチームの試験は、本番の機密データや実行権限を使わない隔離環境で行います。合成データ、ダミーのAPI、読み取り専用の複製インデックスを準備し、攻撃が成功しても外部送信やデータ破壊に至らないようにします。
テストケースは、入力文だけで終わらせません。悪意ある文書を取り込むケース、権限を持たないユーザーで検索するケース、出力から機密らしき文字列を抽出するケース、実行前承認を迂回するケースまで、処理全体を追います。
文書改ざん試験では、取り込み時にSHA-256 minimumでハッシュを保持し、更新者、取得元、承認状態との不一致を検出します。検知できなかったケースは、単なる失敗報告ではなく、監視ルールと運用手順の改善項目として登録します。
- 本番から隔離し、合成データとダミー連携先を使う
- 攻撃文書の取り込みから出力・実行まで追跡する
- 検出漏れをルール、権限、監視の改善へ結び付ける
AI脆弱性診断を開発ライフサイクルに組み込む
AI脆弱性診断は、リリース前の一回限りの審査ではなく、モデル、プロンプト、文書、権限、連携先が変わるたびに行う継続プロセスです。特にRAGでは文書追加だけでも攻撃面が変化するため、変更管理と診断を連動させます。
診断の優先順位は、影響度と悪用可能性で決めます。外部送信、削除、決済、顧客データ閲覧のような高影響機能から試験し、脆弱性には担当者、期限、暫定措置、再テスト条件、残余リスクの受容者を割り当てます。
2025年版 OWASP Top 10 LLM & 生成AIセキュリティリスクへの対応を、診断観点の共通言語にすると漏れを減らせます。AI脆弱性診断の結果を経営・開発・運用で共有し、例外承認も含めて証跡化することが、継続改善の土台になります。
- 高影響のツール連携と機密検索から優先して診断する
- 変更管理、脆弱性管理、再テストを一つの流れにする
- 残余リスクの承認者と期限を明確にする
まとめ
プロンプトインジェクションへの対策は、禁止語を追加するだけでは不十分です。RAGセキュリティで文書の来歴と検索を守り、RAGアクセス制御で権限外データを排除し、AI出力検証と人間承認で最後の事故を止めます。さらにAIレッドチームとAI脆弱性診断を継続し、変化する攻撃に備えましょう。
要点
- システム指示、利用者入力、外部文書を同じ信頼度で扱わない
- RAGでは回答時ではなく検索時にアクセス制御を適用する
- モデル出力をそのまま外部操作へ渡さず、独立した認可と承認を設ける
- 攻撃検知率だけでなく、誤検知率と正常回答率も継続測定する
- 隔離環境で生成AIレッドチームを実施し、診断結果を改善へつなげる
まずは、自社AIが参照する文書、利用者権限、接続するツールを棚卸ししてください。そのうえで、権限外検索、悪意ある文書、外部送信を含む3つのテストケースから始めると、優先して直すべき防御上の穴を具体的に把握できます。
よくある質問
Q1. プロンプトインジェクションは完全に防げますか?
単一のフィルターで完全に防ぐことは困難です。入力・外部文書の隔離、検索時の認可、最小権限、出力検証、人間承認、監視、継続的なレッドチーム試験を多層で組み合わせることが現実的です。
Q2. RAGを使わなければプロンプトインジェクションのリスクはありませんか?
RAGがなくても、利用者入力による直接型の攻撃は起こり得ます。RAGは外部文書や検索結果をコンテキストへ取り込むため、間接型の経路とデータ漏えいの影響範囲を広げる可能性があります。
Q3. RAGアクセス制御で最も重要なポイントは何ですか?
生成後に回答を隠すのではなく、検索時点で権限外の文書・チャンクを除外することです。ユーザーIDと属性をRetrieverまで伝え、元文書の権限変更がベクトルインデックスとキャッシュに反映される仕組みを整えてください。
Q4. AIレッドチームは誰が担当すべきですか?
セキュリティ担当だけで完結させず、AI開発者、データ管理者、業務部門、監査担当を含めるのが有効です。攻撃の再現、権限設計、業務影響、ログ証跡を横断して評価できる体制を作りましょう。
Q5. AI出力検証では何を測定すべきですか?
攻撃検知率に加え、誤検知率、攻撃成功率、正常回答率、根拠付き回答率、処理時間を測定します。防御を強化しても正当な業務質問への回答が過度に失われていないか、変更ごとに回帰テストで確認します。
参考文献・出典
[コンテンツにスキップ](#bodyContent) [ …
ja.wikipedia.org
[](/) * [サービス・製品](javascript:void(0);) * [導入事例](/service/case) *…
www.nri-secure.co.jp
arrow\_back search close # プロンプトインジェクション(Prompt Injection) ## プロンプトインジェクション(Prompt Injection)とは プロンプトインジェクションとは、生成AIに対して悪意のある指示を埋め込み、本来の動作を逸脱させる攻撃手法です。…
www.trendmicro.com