2026.09.30
LLM防護欄實戰指南:守住企業生成式 AI 的安全邊界
AI資訊
LLM防護欄不是在聊天機器人前面加幾條禁語而已,而是決定企業生成式 AI 能否安全上線的控制系統。當模型開始讀取內部知識庫、呼叫 CRM、查詢庫存或執行工作流程時,一段看似普通的使用者輸入,就可能被轉換成資料外洩、越權查詢或錯誤決策。
企業導入生成式 AI 時,常先關注回答品質與開發速度,卻低估模型不具備真正權限意識的事實。模型會依上下文預測下一個詞,無法自行辨認哪些文件可信、哪些指令應拒絕、哪些工具操作不可逆;因此,AI資安必須把模型視為高風險元件,而不是可信任的決策者。
本文以企業實務為主軸,說明 AI安全護欄 的分層架構、LLM提示注入 的防禦方法、LLM幻覺治理 的驗證流程,以及 AI紅隊測試 與 AI合規審計 的營運機制。您也會看到如何透過小規模 PoC,先用真實資料驗證風險、成本與成效,再決定是否擴大投資。
LLM防護欄是企業 AI 的執行期安全控制面
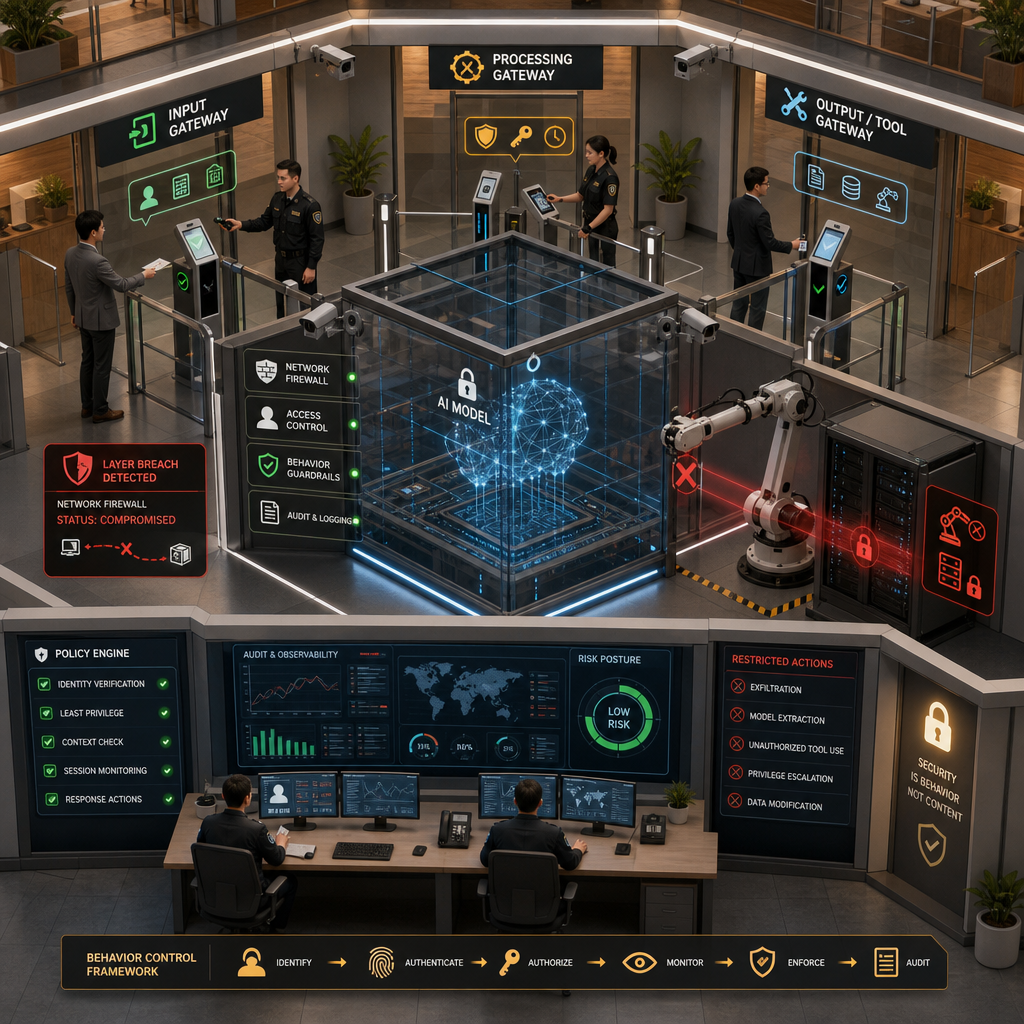
先釐清防護欄管理的是行為,不只是內容
直接答案是:LLM防護欄是在模型輸入、推論、輸出與工具執行前後運作的政策控制層。它的任務不只攔截不當文字,還要判斷請求者身分、資料敏感等級、允許工具、操作範圍與回覆格式,讓模型即使遭到操弄,也無法越過既定商業規則。
在企業架構中,防護欄應放在模型供應商 API、RAG 檢索器、Agent 編排器與內部系統之間。單靠系統提示詞寫著「不要洩密」並不是安全控制,因為提示詞會與使用者輸入、文件內容競爭注意力;真正的控制必須由外部程式、權限系統與可稽核政策共同執行。
實務上可把控制拆成預執行、執行中、後執行三段:預執行驗證使用者與輸入,執行中限制檢索與工具權限,後執行檢查內容、遮罩敏感資訊並記錄事件。這種縱深設計的重點是「任何一層失效,其他層仍能限制損害」,而非追求單一偵測器百分之百準確。
- 把模型視為不可信任的推論元件,而非安全決策者
- 將身分、資料、工具與輸出政策設計成可執行規則
- 每次阻擋、放行與升級處置都應留下可追溯日誌
輸入、輸出與工具層必須各自設防
直接答案是:輸入護欄防攻擊,輸出護欄防外洩,工具護欄防越權;三者不能相互取代。輸入層要正規化 Unicode、移除不可見字元、限制指令格式並偵測越獄語意;尤其 Unicode 標記字元的字碼範圍是從 E0000 至 E007F,若未先正規化,規則比對很容易被繞過。
輸出層則應檢查個資、機密片段、違規內容、無根據斷言與結構格式。對客服或內部問答而言,最安全的預設回覆不是「盡量回答」,而是當檢索證據不足時明確說明無法確認,並導向人工窗口、正式文件或下一步查核流程。
Agent 的工具層風險最高,因為文字輸出會轉變成真實世界的動作。每一項工具都要有允許清單、參數型別檢查、資料範圍限制、速率限制與不可逆操作的二次確認;例如刪除、付款、寄送郵件或更改庫存,不應因模型一句工具呼叫就直接執行。
| 防護層 | 主要風險 | 核心控制 | 失效後影響 |
|---|---|---|---|
| 輸入層 | 越獄與注入 | 正規化、分類器 | 錯誤上下文 |
| 輸出層 | 外洩與違規 | PII 遮罩、事實檢查 | 不當回覆 |
| 工具層 | 越權與誤操作 | 最小權限、確認 | 業務損失 |
- 輸入層:正規化、意圖分類、注入偵測與長度限制
- 輸出層:PII 遮罩、事實依據檢查與格式驗證
- 工具層:最小權限、參數驗證、預覽與人工核准
選型要以誤判、延遲與可攜性共同衡量
直接答案是:沒有一種技術能獨立完成 LLM防護欄。規則引擎延遲低、可解釋性強,適合格式與明確禁詞;分類器擅長大量常見風險;LLM as Judge 能理解複雜語意但成本與延遲較高。企業應以混合式架構處理不同風險,而不是把所有請求都送到昂貴的大模型判斷。
研究與產品測試常見的偵測效果差異很大,部分情境可見 60%–88% 或 57% 到接近 100% 的表現區間。這些數字不能直接當成採購保證,因為資料語言、攻擊變體、風險定義與評分標準不同;真正重要的是在自家繁中資料、真實工作流程與可接受誤攔率下重新驗證。
例如 MiniGuard-v0.1 與 Nemotron-8B 可作為模型化防護元件的評估對象,但仍必須檢查部署位置、資料是否離開租戶、模型更新週期與 API 可用性。若某護欄宣稱 90% 準確率,也要同時問清楚剩餘 10% 是漏報還是誤報,以及高風險事件是否集中在那一部分。
- 先用低成本規則處理確定性高的風險
- 以分類器或小型模型處理大量語意判斷
- 以大型模型覆核高風險、低頻且複雜的案件
防禦 LLM提示注入要先切開信任邊界
提示注入的本質是把資料偽裝成指令
直接答案是:LLM提示注入 是攻擊者利用模型無法可靠區分「資料」與「指令」的弱點,誘使系統忽略原始政策、洩漏提示詞或執行不該做的動作。它與 SQL 注入相似之處在於輸入改變了系統行為,但更難完全消除,因為自然語言本身就同時承載命令與內容。
直接注入通常來自使用者對話,例如要求模型忽略先前規則;間接注入則藏在網頁、電子郵件、PDF、試算表或 RAG 文件中。當 Agent 讀取外部內容後,把其中惡意文字當成高優先指令,可能進一步搜尋機密資料、外傳摘要,或濫用具有寫入權限的工具。
這類風險長期被列為首要治理議題,OWASP 2023至2025年的大型語言模型資安問題排名第一。實務上,防禦目標不應承諾「完全消滅」注入,而是透過隔離、權限與驗證,確保攻擊即使成功影響模型推論,也無法造成高影響的資料或系統操作。
- 將使用者文字、外部文件與系統政策標記為不同信任等級
- 禁止外部文件直接改寫系統指令或工具政策
- 把模型的建議與真正的系統授權機制分離
RAG 與 Agent 要建立可畫出的威脅模型
直接答案是:先畫出資料流,才能找出注入入口。盤點時應列出受保護資產、輸入來源、信任邊界、檢索資料庫、模型、工具與外部服務,再逐段標記誰能寫入、誰能讀取、資料是否可被回饋到下一輪提示,這比先挑選某個護欄產品更能降低盲點。
以內部知識助理為例,使用者提問、文件解析器、向量資料庫與模型都是不同邊界。文件上傳者不一定擁有指揮 Agent 的權限,因此文件內容必須被視為不可信資料;檢索時要保留來源、權限標籤與文件版本,並讓模型只能引用其身分可讀的內容。
工具呼叫應把「模型想做什麼」轉換成受驗證的交易請求。建議為每個工具設定作用範圍,例如只能查詢本人負責客戶、只能建立草稿、不可直接送出;對金額、收件人、刪除範圍等參數加上硬性限制。模型可提出建議,但不能自行擴大授權。
- 釐清每個入口:聊天、檔案、網頁、郵件與第三方 API
- 為文件建立來源、擁有者、敏感度與有效期限標籤
- 將讀取、寫入、付款與刪除設為不同風險等級
以多層控制降低注入成功後的爆炸半徑
直接答案是:提示消毒只能增加攻擊成本,最低權限才能真正限制損害。輸入端可偵測「忽略前述指令」、角色扮演、格式混淆與可疑編碼;文件端可隔離不受信任來源;執行端則必須限制模型能看見與能呼叫的資源,避免任何單一防線被繞過後全面失守。
測試結果必須以攻擊成功率與誤攔率雙軌呈現,而不是只展示單一準確率。某些公開比較曾列出 Claude 3.5 Sonnet 的 87.50% 與 0.00%,Claude 3.5 Sonnet v2 的 56.25% 與 31.25%;這類落差正說明測試提示、攻擊目標與判定標準會大幅改變結論。
提示注入的商業影響也不能只看聊天品質。資料指出,全球数据泄露的平均成本达到 499 万美元,而 AI 驱动的攻击增加了 56%。即使組織不直接處理金流,只要 Agent 能存取客戶資料、寄送文件或更新紀錄,就應把注入事件納入既有資安通報與權限撤銷流程。
- 輸入偵測不通過時拒絕、改寫或轉人工處理
- 工具操作前驗證身分、範圍、參數與業務規則
- 事件發生後保全提示、文件版本、工具呼叫與回覆證據
以 LLM幻覺治理確保答案可驗證、可追責
幻覺治理的核心是要求回答提出證據
直接答案是:LLM幻覺治理 不應只靠模型自評「我有沒有把握」,而要讓每個重要答案可回溯到授權來源。對企業問答系統而言,最有效的原則是沒有證據就不作答:檢索不到足夠來源、來源互相矛盾或文件已過期時,系統應坦白不確定並升級人工確認。
RAG 可降低模型憑記憶編造的比例,但不會自動保證正確。錯誤切分、過期文件、相似但不相關的檢索結果,甚至遭污染的文件,都可能讓模型產生看似合理的結論。因此,回答輸出應同時帶出來源連結、段落位置、文件版本與檢索分數,供使用者快速驗證。
高風險流程更適合使用結構化輸出,而非自由文字。例如合約條款比對可要求模型輸出條款編號、引用片段、風險類型與信心說明;若缺少引用欄位或格式驗證失敗,就不進入後續工作流。這種設計能把抽象的「可靠性」轉成可測試的系統條件。
- 每項關鍵結論必須附可讀取的來源證據
- 來源不足、衝突或過期時採取拒答或人工覆核
- 以 JSON Schema 等格式限制下游系統可接受的輸出
區分內容安全、事實正確與業務正確
直接答案是:內容沒有違規,不代表答案正確;答案有引用,也不代表符合業務規則。AI安全護欄 至少要分別管理內容安全、事實依據、權限合規與業務邏輯。若把所有檢查交給同一個判斷模型,出錯時既難找原因,也無法調整不同風險的容忍門檻。
內容安全可處理暴力、仇恨、個資與敏感主題;事實檢查則確認結論是否被檢索內容支持;業務驗證要比對資料庫中的庫存、價格、合約狀態或資格條件。特別是會影響報價、醫療建議、法務意見與人事決策的輸出,應由確定性規則或人工權責者作最後裁決。
部分服務提供 0-100 置信分並支持最小配置步长1,這類門檻可用於路由策略,但不可被誤解成真實機率。團隊應先定義何種風險可自動放行、何種風險必須 review、何種風險立即 block,再以實際案例校正門檻,避免高分錯誤被機械式放行。
- 內容檢查:是否含違規、機密或可識別個資
- 事實檢查:是否有足夠且相關的來源支持
- 業務檢查:是否符合資料、流程與權責規範
把評估集做成可持續回歸的品質資產
直接答案是:治理成效必須由固定評估集持續量測。建立資料集時,應納入正常問題、模糊問題、錯誤前提、過期資訊、多語言問法與惡意誘導,同時標記預期答案、必須引用的來源、應拒答的情況與允許的人工升級路徑,才能客觀比較模型與護欄改版前後的差異。
指標至少包括有證據回答率、引用正確率、拒答正確率、幻覺率、誤拒率與平均延遲。只看「使用者滿意度」容易掩蓋低頻高風險錯誤;只看自動評分則可能無法反映實際流程。因此應抽樣進行人工複核,並讓業務專家參與判斷何謂可接受的答案。
當模型、提示模板、文件解析器或向量模型更新時,應先在離線評估集與影子流量測試,通過門檻才逐步發布。若串流回答在中途被判定違規,系統還要能立即停止傳送、撤回尚未執行的工具任務、隔離對話並通知管理者,這是許多單純內容過濾方案忽略的營運能力。
- 將評估案例版本化並保留預期處置方式
- 同時監測正確率、誤拒率、漏報率、成本與延遲
- 針對串流輸出設計中止、隔離與補救流程
用 AI紅隊測試驗證防護欄能否承受真實攻擊
紅隊測試應從業務影響倒推攻擊劇本
直接答案是:AI紅隊測試 的目的不是蒐集幾句成功越獄提示,而是驗證攻擊者能否從某個入口走到具體業務損害。測試應先選定皇冠資產,例如客戶個資、薪資資料、付款流程、原始碼或管理權限,再倒推可能的外部文件、聊天輸入、權限漏洞與工具呼叫路徑。
一個完整劇本會同時描述攻擊前置條件、誘導內容、資料流、預期防線與可接受結果。以採購 Agent 為例,測試者可在供應商 PDF 放入隱藏指令,觀察系統是否把文件內容視為命令、是否嘗試修改收款帳戶,以及工具層是否因收款人異動而要求人工覆核。
OWASP 的 LLM01:提示注入、LLM02:敏感信息泄露與 LLM06:过度授权,可作為情境分類起點,但企業測試集必須加入自身流程。外部標準提供共同語言,內部資料與權限設計才決定實際曝險;沒有業務脈絡的紅隊結果,往往無法讓管理階層判斷修補優先順序。
- 以高價值資料與不可逆交易作為測試優先目標
- 覆蓋直接注入、間接注入、資料外洩與工具濫用
- 把成功條件定義為業務影響,而非模型是否說出禁句
測試報告要同時揭露漏報與誤報
直接答案是:一套防護欄若只展示攔截成功案例,不能證明可安全上線。測試報告應區分真陽性、假陽性、真陰性與假陰性,並按語言、使用者角色、資料來源、攻擊技術與模型版本切分。對客服系統而言,誤攔率過高會傷害服務;對付款 Agent 而言,漏報一次就可能不可接受。
原始論文探討了 12 種特定的字元注入技術,這提醒團隊不要只測試常見的「忽略前述指令」。測試集還應納入不可見字元、語言切換、HTML 註解、OCR 文字、長上下文稀釋、角色扮演與檢索文件污染,並在每次模型或護欄更新後重新執行。
效能也要列入安全驗收。單次護欄檢查若增加 10–100 毫秒,可能適合一般問答;若需跨模型判斷而增加 500 毫秒 – 5 秒,則應只套用於高風險路由。透過快取、非同步覆核與分級政策,可避免所有請求都承擔最高成本與最長等待時間。
- 報告應列出漏報、誤報、延遲與每次請求成本
- 以繁中、英文與混合語言分別衡量防護成效
- 模型、文件或規則更新後必須進行回歸測試
事件回應必須涵蓋中止、撤權與通知
直接答案是:防護欄失效後,最重要的是限制持續傷害,而不是只修正提示詞。事件流程應先停止相關 Agent、撤銷 API 金鑰或工作階段、凍結高風險工具權限,接著保存原始提示、檢索文件、模型回應、工具參數與存取日誌,避免關鍵證據在重試或清理後消失。
事件分級可依資料敏感度、是否已對外傳送、是否發生工具操作與影響範圍判斷。低風險事件可修正規則並追蹤;涉及個資、財務或跨租戶資料的事件,則應啟動法務、資安、隱私與業務負責人的聯合處置,確認通知義務、補救範圍與對外溝通。
修補完成後不能只重跑同一條攻擊提示,而要擴充相鄰變體並回歸測試。若根因是過度授權,就應收緊權限模型;若根因是文件來源不可信,就要修正攝取流程;若根因是偵測器漏報,才調整模型或規則。這樣才能避免每次事故都變成短暫的文字封鎖。
- 先中止任務與撤銷權限,再分析根因
- 保存提示、來源、回覆、工具呼叫與身分脈絡
- 以根因改善架構,而不是只新增單一禁詞
以 AI合規審計與 PoC 建立可長期營運的治理
合規審計要能回答誰、何時、為何放行
直接答案是:AI合規審計 的核心是可證明性。當內部稽核、客戶或監管單位詢問某次回答為何出現、使用了哪些資料、誰有權觸發工具、何時修改過政策時,團隊必須能從不可竄改的紀錄還原決策脈絡,而不是只提供模糊的模型日誌。
最小審計單位應包含使用者或服務身分、租戶、模型與版本、提示模板版本、檢索來源、護欄判定、政策版本、工具呼叫、人工覆核與最終處置。日誌需避免直接保存不必要的敏感原文,可採遮罩、雜湊、權限分層與保存期限管理,兼顧追溯需求與隱私風險。
政策本身也應採版本控制與核准流程。任何人調整阻擋門檻、允許工具、詞庫或資料範圍,都要留下變更理由、影響評估、測試結果與核准人。這能讓治理從「某位工程師知道怎麼調」轉成可交接、可覆核且能面對事故調查的組織能力。
- 記錄身分、來源、模型、政策、工具與最終處置
- 對敏感日誌採遮罩、存取分權與保存期限控管
- 將政策修改納入測試、核准與版本追蹤流程
先以 PoC 驗證風險與效益,再擴大上線
直接答案是:安全治理最適合從小範圍 PoC 開始,而不是在需求未明時一次建置完整平台。ALION 的 AI PoC 開發支援以現場調查、真實資料與最小原型驗證可行性,先定義要保護的資料、要允許的任務、可接受的誤攔率與處理時限,再以 Go/No-Go 作為後續投資依據。
PoC 階段建議選一個可量測的業務流程,例如內部知識助理、客服摘要或需求預測輔助,並建立基準線:未加護欄時的幻覺率、敏感資料命中率、人工處理時間與工具誤操作風險。完成後再比較輸入檢查、RAG 權限過濾、輸出遮罩與人工覆核各自帶來的改善。
ALION 的 AI 上游工程訂閱服務月費 20 萬日圓起,涵蓋需求梳理、設計文件與示範製作;若簽約進入正式開發,相關上游工程費用可自正式開發預算扣抵。這種做法讓企業能先把安全需求做成可操作原型,而不是在正式開發後才發現資料、權限或現場流程無法配合。
- 先定義 KPI:漏報、誤報、延遲、人工覆核量與業務效益
- 在貼近正式環境的資料與權限條件下驗證
- 保留 PoC 的設計、程式碼與測試資產,降低正式化成本
將成本、效能與資料主權納入採購決策
直接答案是:選擇 AI安全護欄 不能只看單次偵測價格,還要計算延遲、流量、資料出境、模型鎖定與人工覆核成本。市場報價可能出現 15元/万张起≈1.0版*45%、7.5元/万次起≈1.0版*41%、225元/万分钟起≈1.0版*22%,或 视频截帧画面15元/万次起,视频音频202.5元/万分钟≈1.0版*34% 等差異。
這些價格只能作為容量規劃參考,因為企業最終成本取決於內容型態、QPS、串流處理、重試機制與是否需多重判定。部分方案宣稱费用降低50%~70%,仍應以自家尖峰流量、繁中準確率、保留日誌需求及資料處理地點試算,避免低單價因誤報或延遲而轉化為高營運成本。
採購審查還應確認資料是否被用於供應商訓練、能否採私有部署、是否支援跨雲與多模型、日誌保留在哪裡,以及未來更換供應商時能否帶走政策與測試集。真正可持續的架構,應讓安全規則與評估資料屬於企業,而不是被綁死在單一模型或平台。
- 比較總持有成本,而非只比較每次 API 單價
- 確認資料所在地、訓練使用政策與多租戶隔離方式
- 要求政策、日誌與測試集具備可匯出與可移轉能力
參考來源
建議持續追蹤 OWASP LLM Top 10:https://genai.owasp.org/llm-top-10/;NIST AI Risk Management Framework:https://www.nist.gov/itl/ai-risk-management-framework;MITRE ATLAS:https://atlas.mitre.org/;AWS Bedrock Guardrails 文件:https://docs.aws.amazon.com/bedrock/latest/userguide/guardrails.html;Microsoft Azure AI Content Safety 文件:https://learn.microsoft.com/azure/ai-services/content-safety/。
總結
LLM防護欄的價值,不在於讓模型永遠不犯錯,而在於把模型可能犯的錯限制在可接受、可偵測、可補救的範圍內。企業應將輸入驗證、RAG 資料治理、輸出查核、工具最小權限、持續測試與審計紀錄整合為同一套營運機制,才能讓生成式 AI 從展示用途走向可信任的業務能力。
重點整理
- LLM防護欄必須同時覆蓋輸入、輸出、檢索與工具執行層。
- LLM提示注入無法只靠提示詞解決,必須以信任邊界與最小權限限制損害。
- LLM幻覺治理應以來源證據、拒答策略與回歸評估集為核心。
- AI紅隊測試要量測業務影響、漏報、誤報、延遲與修補後的回歸結果。
- AI合規審計需要完整的政策版本、資料來源、身分與工具操作紀錄。
若您的團隊正評估內部知識助理、客服 Agent 或自動化工作流,建議先從一個高價值、可量測的情境啟動 PoC。透過現場流程盤點、真實資料驗證與安全 KPI 設計,可在正式擴大前釐清技術可行性、治理缺口與投資效益,避免把風險帶進正式環境。
常見問題 FAQ
Q1. LLM防護欄和系統提示詞有什麼差別?
系統提示詞只是提供模型行為指引,可能被更長的上下文、惡意文件或提示注入影響。LLM防護欄則是模型外部的執行控制,能驗證輸入、限制資料與工具權限、過濾輸出並留下審計紀錄。
Q2. 只使用 RAG 就能解決 LLM 幻覺嗎?
不能。RAG 能讓模型取得外部資料,但仍可能檢索錯誤、引用過期內容、誤解文件或在證據不足時自行推論。必須搭配來源引用、權限過濾、拒答門檻與持續評估。
Q3. 防護欄會不會讓回覆速度變慢?
會,因此應採分級策略。低風險請求可先使用規則與快取,高風險內容、敏感資料與工具操作再啟動較嚴格的分類、模型覆核或人工確認,平衡安全、延遲與成本。
Q4. 企業應如何開始 AI紅隊測試?
先選定高價值資料與不可逆操作,畫出使用者、文件、RAG、模型及工具之間的資料流,再設計直接注入、間接注入、資料外洩與越權操作劇本。測試結果應記錄漏報、誤報、延遲與實際業務影響。
Q5. 為什麼建議先做 AI 安全 PoC?
PoC 能在小範圍內用真實資料與實際流程驗證防護準確率、使用體驗、資料治理需求與營運成本。若驗證結果不符合 KPI,也能在正式開發前選擇調整或停止,降低大規模導入風險。