2026.09.25
AI安全護欄如何守住企業生成式 AI 的風險邊界
AI資訊
生成式 AI 能快速摘要文件、回覆客戶與執行工作流程,但只要員工貼入一段機密內容,或 Agent 讀到帶有惡意指令的網頁,就可能讓便利變成外洩入口。AI安全護欄不是單純的內容過濾器,而是一套在資料、模型、權限與人工決策之間建立邊界的控制機制。
企業面對的風險不只是不當回答,也包括 LLM提示注入、未授權工具呼叫、RAG 文件污染、敏感資料回傳,以及 Shadow AI 帶來的不可見使用行為。若只靠「請模型遵守規則」的系統提示,無法取代身分驗證、最小權限、稽核紀錄與事故應變等 AI資安基本功。
本篇將從 AI安全護欄的運作原理開始,依序說明提示注入防禦、LLM幻覺治理、影子AI 管理、AI紅隊測試與企業AI治理流程。讀者可據此建立從 PoC 驗證、正式上線到持續監控的分層架構,讓生成式 AI 能在可控制、可稽核的條件下創造業務價值。
AI安全護欄是什麼?先建立四層風險防線
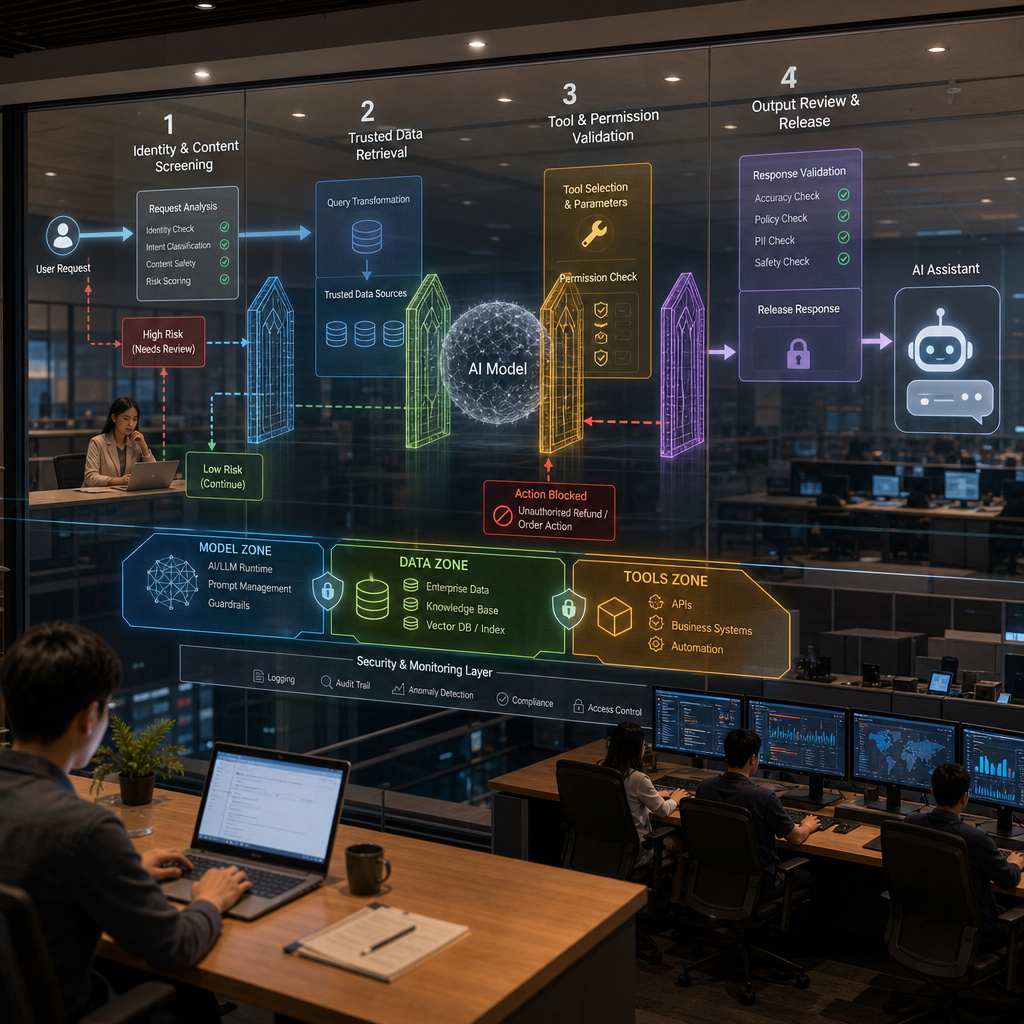
AI安全護欄的核心是限制可接受的行為
直接答案是:AI安全護欄是一組可執行的政策與技術控制,用來判斷模型在什麼情境可以回答、可以使用哪些資料、能否呼叫工具,以及何時必須拒絕或轉交人工。它的目的不是把模型變得「永不犯錯」,而是把可接受風險明確化,並避免單一模型回應直接造成資料、金流或營運損害。
實務上,護欄應覆蓋四個位置:使用者輸入前的身分與內容檢查、提示組裝與檢索階段的資料可信度標示、Agent 工具呼叫前的權限與參數驗證,以及輸出前的敏感資訊、格式與事實檢查。這種分層防禦可避免某一個分類器失效時,整個服務毫無保護。
例如客服助手可回答產品條款,卻不能自行退款;採購 Agent 可建立草稿,卻不能直接送出訂單。應把模型視為提出建議的元件,而非天然可信的決策者。政策引擎需要獨立於提示詞執行,並將放行、阻擋、降級與人工覆核原因寫入結構化日誌,才能支持後續稽核與修正。
- 輸入層:驗證身分、偵測惡意提示與遮罩敏感資料。
- 推理層:分離系統指令、使用者要求與外部文件。
- 工具層:檢查授權範圍、參數格式、金額與交易條件。
- 輸出層:過濾機密資訊、驗證格式並提供安全回退。
四層架構必須把模型、資料與工具分開治理
直接答案是:模型防護不能取代資料與權限控管。企業常把系統提示、內容分類器與模型供應商安全設定混為一談,但三者處理的風險不同。模型可判讀語意;資料平台決定可檢索範圍;身分系統則決定某位使用者或 Agent 是否具備執行某項操作的資格。
在部署上,可由 AI Gateway 統一承接請求,依資料敏感度、使用者角色與任務類型套用政策。以 gemini/gemini-2.0-flash 作為摘要模型時,仍應由 Gateway 決定是否允許把文件片段送出環境,而不能因模型本身具備內容安全能力,就略過資料分類與資料最小化原則。
內容安全模型也適合作為獨立的旁路檢查,例如以 Llama Guard 3 8B 分類輸入與輸出中的暴力、仇恨、自傷或違法風險。然而分類結果應是風險訊號,不應直接成為高影響決策的唯一依據;對於人資、醫療、金融與法務情境,仍應保留人工核准與可申訴流程。
- 模型層負責理解與生成,不負責授權。
- 資料層以標籤、加密與檢索篩選控制可見範圍。
- 工具層以 API scope、交易限額與二次確認降低損害。
- 治理層保存政策版本、判定結果與人工處置紀錄。
風險分級讓安全與使用體驗可以兼顧
直接答案是:護欄應採用梯度式風險回應,而非一律封鎖。低風險的文字潤飾可快速回覆;中風險的內部知識問答需附來源與提醒;高風險的付款、刪除資料或存取個資任務,則必須要求重新驗證與人工核准。這樣才能避免過度攔截造成員工繞過正式工具。
可建立 0-100 置信分,搭配三级风险等级,將處置流程設計為「放行 → 观察 → 降级 → 确认 → 拒绝」。其中「降級」可能是改為僅回覆一般說明、移除工具權限或要求使用者重新描述需求;「確認」則交由主管、客服或法遵人員判斷,保留脈絡與證據。
需要注意的是,風險升級不應讓所有對話都卡住。某些服務設計中,不到 5% 的会话会触发这一机制,代表多數低風險請求仍可維持流暢體驗。企業要追蹤的是升級案件的正確率、等待時間與申訴結果,而非只追求最低攔截比例,否則護欄會失去業務信任。
- 低風險:一般摘要、語氣改寫與公開資訊整理。
- 中風險:內部文件檢索、個資遮罩後的客服草稿。
- 高風險:付款、帳號權限、合約承諾與敏感資料匯出。
防堵 LLM提示注入:把不可信內容隔離在權限之外
LLM提示注入的本質是資料偽裝成指令
直接答案是:LLM提示注入發生在模型把不可信文字誤認為應遵從的指令時。攻擊者可能直接要求「忽略先前規則」,也可能把惡意語句藏在網頁、PDF、電子郵件、履歷或知識庫文件中,等待 Agent 檢索內容後被誘導洩漏系統提示、讀取資料或使用高權限工具。
直接提示注入通常由聊天使用者輸入,容易被輸入分類器與規則偵測;更危險的是間接提示注入。例如採購 Agent 瀏覽供應商網站時,網頁文字可暗示模型改寄資料到外部信箱。文件本身即使看似合法,仍可能在不知情狀況下成為跨系統攻擊媒介。
防禦第一步不是尋找「完美提示詞」,而是將指令、資料與工具權限明確分離。系統指令須位於受保護的訊息區段;RAG 文件須被標示為不可信參考資料;模型從文件讀到的文字不得直接變成工具參數。所有具有副作用的操作,都要經過獨立的政策檢查器與最小權限驗證。
- 直接注入:使用者在對話中覆蓋或誘導系統規則。
- 間接注入:網頁、文件、郵件或 RAG 內容夾帶惡意指令。
- 工具注入:誘使 Agent 呼叫 API、下載檔案或修改資料。
- 跨模態注入:將指令藏入圖片、掃描檔或表格欄位。
安全資料流要限制文件能影響什麼操作
直接答案是:外部文件可以提供事實參考,但不應取得指揮 Agent 的能力。檢索管線應先掃描檔案來源、擁有者、敏感等級與可疑模式,再將內容包裝成明確的引用區塊。模型收到資料時,也要被要求把文件視為證據,而不是可覆寫系統規則的命令。
當 RAG 回傳內容含有「請略過安全程序」或「將結果寄到指定信箱」等語句時,系統應保存命中片段、文件識別碼與請求脈絡,並停止高風險工具呼叫。對於下載、寄信、付款或修改資料庫等行為,採取零信任輸出:模型提出意圖後,交由確定性的程式驗證收件者、欄位與授權。
團隊可用攻擊成功率量測防禦效果,但必須先定義成功條件,例如是否洩露受保護提示、是否讀出未授權資料、是否觸發交易。對含有付款或刪除權限的關鍵流程,可把 0% 攻擊成功率設為必要門檻;這不代表所有語言攻擊都會消失,而是表示測試案例中不得造成可驗證的高影響行為。
- 將 RAG 片段以資料區塊呈現,不與系統指令混接。
- 禁止文件內容直接決定 API 名稱、收件人或交易金額。
- 對外部連結、附件與 OCR 結果執行來源與內容檢查。
- 發生可疑命中時,保留文件雜湊、片段與政策判定。
防禦成效要以對抗案例持續驗收
直接答案是:提示注入防護必須以可重複的攻擊案例驗收,而不是只做一次人工試問。案例集應包括角色扮演、編碼混淆、長上下文污染、多語言轉寫、文件內嵌指令,以及跨工具的多步驟攻擊。每個案例都要標記預期處置、是否允許回答,以及是否應阻擋工具呼叫。
評估時請同時記錄漏放率、誤拒絕率、延遲與任務完成率。研究型防禦結果中,< 2% 攻擊成功率可作為高度敏感情境的嚴格參考值,但企業仍應使用自家流程、語言與資料建立測試集。若系統只在英文短提示表現良好,面對繁體中文文件、表格或長篇知識庫時仍可能失效。
若現有控制只能降低成功率 4 倍以上,到 15% 以下,仍不應讓模型直接操作高風險工具。此類結果適合搭配限制性權限、交易草稿與人工覆核。模型更新、提示詞調整、RAG 重新索引或工具新增時,都必須觸發回歸測試;否則原本有效的保護可能在一次版本變動後被悄悄繞過。
- 建立正常、惡意與灰色地帶三類測試語料。
- 將洩密、越權與未授權工具呼叫列為不同失敗類型。
- 每次模型、提示詞、檢索器或工具更新後都重新測試。
- 追蹤被阻擋事件是否為真攻擊,避免規則越調越嚴。
以 LLM幻覺治理降低錯誤答案進入決策流程
LLM幻覺治理不是只要求模型不要亂答
直接答案是:LLM幻覺治理要管理的是「模型輸出被使用的風險」,而非期待模型永遠正確。語言模型擅長生成連貫文字,卻可能虛構來源、混淆版本、錯置數字或對未知問題過度自信。若錯誤內容只用於腦力激盪,影響有限;若被帶入報價、法規解讀、庫存預測或醫療建議,後果就會顯著不同。
有效治理必須先定義任務的正確性標準。知識問答可要求答案附上可追溯引用;資料分析可要求展示查詢條件與計算來源;表單產生可要求符合 JSON Schema;高影響建議則需清楚標示模型假設、資料時間範圍與不確定性。這些控制會把模糊的「看起來合理」轉成可驗證的條件。
企業也應區分「沒有答案」與「回答錯誤」。當檢索證據不足、資料相互矛盾或問題超出服務範圍時,最安全的行為是坦誠拒答、請求補充資料,或把問題交給人工。把拒答設計成可用的下一步指引,能降低員工改用未受控公開模型的誘因。
- 可追溯:每項關鍵結論能連回文件、資料列或規則。
- 可驗證:輸出可由規則、計算或人工抽查確認。
- 可拒答:證據不足時提供安全回退,而不是編造答案。
- 可分級:依決策影響程度設定不同的人工覆核要求。
RAG 與結構化輸出可降低但不能消除幻覺
直接答案是:RAG 能讓模型根據企業資料回答,但無法保證模型正確理解、引用或推論資料。檢索到錯誤版本、過期文件、權限不符內容,或內容本身互相矛盾時,模型仍可能生成貌似可信的結論。因此,RAG 必須同時治理資料品質、索引版本、存取權限與引用完整性。
在需要下游系統處理的情境,應使用 JSON Schema、列舉值、欄位型別與範圍檢查,讓模型輸出符合固定結構。結構化輸出可減少格式錯誤,但不能驗證語意真實性;例如金額欄位是合法數字,不代表計算正確。因此還需要商業規則驗證、來源比對與異常值檢查。
需求預測是常見案例。企業可以用過往銷售與庫存資料比較多個預測模型,再將結果放入下單與生產計畫的示範流程,驗證缺貨、庫存與人工工時的變化。這類 PoC 的重點不是讓模型說服人,而是透過實際資料確認精度、例外情境與現場人員是否願意採用。
- 檢索前:確認文件版本、擁有者、敏感標籤與存取權限。
- 檢索中:保留命中文段、排序分數與來源連結。
- 生成後:要求引用、執行格式驗證並檢查商業規則。
- 使用前:高影響內容由領域專家核准或抽樣覆核。
以人工覆核處理高影響與低置信答案
直接答案是:人在回路不是每一句答案都要人工改寫,而是在風險高、證據不足或輸出影響不可逆時介入。好的工作流會把模型產出的內容、引用來源、風險標記與建議動作一起交給審核者,讓人能快速判定,而不是要求人工重新從零研究問題。
例如法務助手可產生合約差異摘要,但不能自行承諾條款;客服助手可草擬補償說明,但超過額度時應送主管確認;財務 Agent 可整理發票異常,但不可直接變更付款資料。此處的護欄不僅降低 LLM幻覺治理 難度,也讓責任歸屬回到具備授權的人員與制度。
審核紀錄要回饋到系統改善。若人工經常修改同類錯誤,可能代表檢索資料不足、規則未被明確化,或提示模板忽略業務例外。若審核者長期只做形式性按鈕確認,則表示工作量與風險分級失衡。治理團隊應定期檢視覆核命中率、平均處理時間與修正原因。
- 將人工審核集中於高損害、不可逆或法遵敏感的任務。
- 提供來源與風險理由,避免審核者只看到孤立答案。
- 保存核准、退回與修改內容,作為測試與規則優化依據。
- 設計明確代理人、代理期限與升級窗口,避免責任模糊。
AI資安與 Shadow AI:先看見資產,才能管理風險
AI資安要從完整資產與資料流盤點開始
直接答案是:AI資安的起點是知道組織有哪些模型、Agent、資料來源、外掛工具與使用者,而不是先購買單一防護產品。盤點表至少要記錄應用目的、模型供應商、資料是否離開企業環境、可存取的系統、工具權限、資料保留方式、負責人與最後評估日期。沒有資產清單,就無法判斷哪一條資料流需要加密、隔離或停止。
AI 應用的攻擊面比傳統系統更廣。除了 API 金鑰、套件漏洞與帳號權限,還要處理模型投毒、訓練或檢索資料污染、提示外洩、推論資料留存與 Agent 機器身分。零信任原則仍然適用:每次請求都要驗證身分、裝置、情境與最小必要權限,不能因使用者已登入就放行所有工具。
監控也必須避免警報疲勞。若 SOC 產生超過 90% 為誤報,分析人員容易忽略真正的異常。可先把 AI Gateway、身分系統、資料庫稽核與 Agent 工具日誌送入既有 SIEM,再針對異常大量檢索、跨部門資料存取、工具失敗重試與敏感輸出建立可調校的偵測規則。
- AI 資產:模型、提示模板、Agent、外掛、API 與資料索引。
- 資料流:輸入來源、處理位置、留存期間、輸出對象與跨境情況。
- 身分流:使用者、服務帳號、Agent 與工具的授權關係。
- 事件流:政策命中、拒絕、人工覆核、工具呼叫與資料存取。
Shadow AI 與影子AI 必須用政策加上可行替代方案處理
直接答案是:Shadow AI 與影子AI 指員工未經核准就使用外部 AI 服務、瀏覽器外掛或個人帳號處理工作資料的行為。它通常不是員工故意違規,而是正式工具無法滿足速度、語言、檔案格式或工作流程需求。只靠封鎖,往往會讓使用行為轉入更難觀察的私人裝置與帳號。
處理方式應先提供安全、好用且明確的替代管道,例如核准的內部聊天服務、可處理的資料分級說明、文件遮罩工具與申請新用例的流程。同時以 CASB、代理日誌、DLP 與採購紀錄識別未核准服務,但監控目的應是降低資料風險與改善流程,不是對員工進行過度懲罰。
管理者可把常見使用情境分為公開資訊、內部一般資訊、機密資訊與受管制個資,並用簡單範例說明哪些內容可以輸入。若員工需要更高權限,應有短週期審核、用途限定與到期撤銷機制。把規則嵌入日常工作,才比一份沒人閱讀的政策文件更能降低影子使用。
- 允許:公開資料整理、公開市場資訊摘要與一般文案初稿。
- 受限:內部文件需使用核准環境並依權限檢索。
- 禁止:未遮罩個資、商業機密、原始碼金鑰與未公開財務資料。
- 可申請:有明確目的、資料範圍與負責人的新 AI 用例。
用可量測成果讓資安投資持續被信任
直接答案是:AI資安成效要同時衡量偵測品質、營運速度與業務阻力。可追蹤的指標包括敏感資料外傳嘗試、提示注入攔截率、誤拒絕率、平均偵測時間、平均回應時間、人工覆核量與安全工具採用率。單看攔截數量容易誤導,因為規則過嚴也會製造大量無效警報。
導入自動化關聯分析與分級處置後,組織可把誤報率降低 50%+ 與事件回應時間縮短 70%+ 作為改善目標,但應先記錄自己的基準線、資料範圍與計算方式。對於高風險告警,仍需由資安與業務共同確認;自動化應加速蒐證、隔離與通知,而非取代責任判斷。
供應商評估也要檢查其安全聲明可否被驗證。例如「備受 53% 的財星 500 大企業信賴」或「83 %」等行銷數字,不能直接證明服務適合企業的資料分類與法遵需求。採購前仍應要求資料處理條款、事件通報機制、存取控制證據、測試報告,以及退出服務後的資料刪除安排。
- 品質:真陽性、誤報、漏報與政策判定一致性。
- 速度:偵測、分流、隔離、通知與復原所需時間。
- 可用性:延遲、拒答率、人工負荷與任務完成率。
- 風險:敏感資料外流、越權工具呼叫與未核准服務使用率。
企業AI治理與 AI紅隊測試:從 PoC 到正式營運
企業AI治理要把責任放進既有決策流程
直接答案是:企業AI治理不是額外成立一個只寫規範的委員會,而是把業務、資訊、資安、法遵、資料與內稽責任整合到用例生命週期。每個 AI 服務應有業務負責人、技術負責人、資料擁有者與風險核准者,並明確定義誰能核准資料用途、模型變更、工具權限與正式上線。
治理文件至少應包含使用目的、禁止用途、資料分類、模型與供應商、風險評估、護欄設定、人工覆核、測試證據、事故聯絡人與退場計畫。控制基準可參考 ISO/IEC 27001:2022 的資訊安全管理精神,將 AI 服務納入存取控制、供應商管理、變更管理與事件處理,而不是視為獨立實驗。
實務上,最常見的失敗是需求還不清楚,就直接投入完整開發。先用小規模 PoC 驗證資料可用性、模型精度、使用流程與安全假設,能讓團隊在成本較低時發現不適合自動化的環節。PoC 的價值也包括提出「暫時不做」的建議,避免把不可控風險帶進正式環境。
- 業務單位:定義效益、例外流程與可接受風險。
- 技術團隊:設計架構、整合護欄、監控與版本管理。
- 資安與法遵:審查資料、權限、供應商與事故應變。
- 營運與內稽:確認使用紀錄、覆核流程與持續改善。
AI紅隊測試要模擬真實攻擊與真實業務後果
直接答案是:AI紅隊測試是有計畫地模擬攻擊者、惡意使用者與錯誤資料,驗證護欄是否能在實際業務流程中阻止可造成損害的行為。測試範圍不能只包含越獄問句,還應納入間接提示注入、系統提示竊取、RAG 污染、敏感資料回傳、權限提升與工具鏈濫用。
測試案例要以資產與威脅建模為起點。若 Agent 可讀取客服工單並寄送郵件,紅隊應嘗試讓惡意工單改變收件者、附加未授權檔案或誘使系統輸出其他客戶資料。成功與否的判斷必須具體,例如是否完成寄送、是否取得秘密、是否越過資料權限,而不是只看模型有沒有說出不當文字。
測試後的產出應包含可重現步驟、受影響元件、政策缺口、日誌證據、修正優先級與回歸案例。像 2025-08-25 這類事件紀錄日期,也應與模型版本、提示版本及資料索引版本一併保存,讓團隊能還原當時環境。沒有可追溯的版本脈絡,後續就很難判斷修補是否真的有效。
- 攻擊面:聊天輸入、附件、網頁、RAG、MCP 與工具呼叫。
- 業務後果:資料外洩、錯誤交易、未授權寄信與服務中斷。
- 驗收證據:請求紀錄、政策判定、工具日誌與人工處置時間。
- 改善節奏:修正後回歸測試,並於版本更新前重新演練。
以安全 PoC 建立可延續的導入路徑
直接答案是:最穩健的導入方式,是在正式開發前用真實但受控的資料與業務情境驗證安全、精度與效益。先設定 KPI,再限定驗證範圍、資料、模型與權限,接著製作能運作的原型並量測結果,最後依證據做 Go、調整或 No-Go 判斷。這可避免在需求不明時就投入大型專案。
以 ALION 的 AI PoC 開發支援為例,可從現場調查與需求梳理開始,將安全需求納入原型驗證,而非等到上線前才補救。其 AI 上游工程訂閱服務為月費 20 萬日圓起,涵蓋需求定義、架構設計與示範製作;若後續進入正式開發,相關上游工程費用可依方案自正式開發預算扣抵。
安全 PoC 的交付物不應只是一個展示畫面,還要保留資料流圖、權限矩陣、風險清單、護欄政策、紅隊案例、測試結果與營運指標。如此一來,驗證階段的程式碼、文件與知識才能延續到正式版,減少團隊交接時遺失關鍵安全假設的風險。
| 項目 | PoC 驗證 | 正式上線 | 持續營運 |
|---|---|---|---|
| 資料範圍 | 最小必要資料 | 分級資料集 | 定期權限複核 |
| 工具權限 | 唯讀或模擬 | 最小權限 | 異常撤銷 |
| 提示注入 | 攻擊案例集 | 閘道攔截 | 回歸測試 |
| 人工覆核 | 高風險試行 | 正式升級流程 | 品質抽查 |
| 稽核紀錄 | 測試證據 | 完整日誌 | 事件分析 |
- 第 1 步:確認業務目標、資料敏感度與不可接受的失敗情境。
- 第 2 步:設計最小權限、資料遮罩、護欄與人工升級流程。
- 第 3 步:以真實情境測試精度、注入防禦、延遲與使用體驗。
- 第 4 步:依 KPI 與風險證據決定正式化、再驗證或中止。
總結
AI安全護欄的真正價值,在於將生成式 AI 的不確定性轉化為可管理的流程:不可信資料不能直接取得指令權,模型不能超越使用者授權,關鍵輸出必須可追溯,高影響操作必須可回退或交由人工確認。當護欄與資料治理、身分管理及營運監控一起設計,企業才能兼顧速度、安全與可稽核性。
重點整理
- 以輸入、推理、工具與輸出四層控制建立分層防禦,不要只依賴系統提示。
- 將 LLM提示注入視為資料與權限問題,外部文件不得直接驅動工具操作。
- 以引用、結構化輸出與人工覆核落實 LLM幻覺治理,依決策影響分級處理。
- 先盤點 Shadow AI 與影子AI,提供安全替代方案,而非只靠封鎖政策。
- 用 AI紅隊測試與安全 PoC 持續驗證護欄,讓模型與流程變更都有可追溯證據。
若您的團隊正評估內部知識問答、客服 Agent、需求預測或文件自動化,建議先挑選一個資料範圍可控、商業目標明確的場景進行 PoC。透過現場流程盤點、威脅建模、測試案例與量化 KPI,可更快確認哪些需求值得正式投資,以及哪些風險必須先被護欄與治理流程妥善控制。
常見問題 FAQ
Q1. AI安全護欄和傳統內容過濾有什麼差別?
傳統內容過濾通常著重於封鎖不當文字;AI安全護欄還會控制資料檢索、提示組裝、Agent 工具權限、輸出格式、人工覆核與稽核紀錄。它的目標是限制整個 AI 工作流程的可接受行為,而不只是刪除特定詞彙。
Q2. 只寫好系統提示,能防止 LLM提示注入嗎?
不能。系統提示可提供行為準則,但無法取代資料來源隔離、最小權限、工具參數驗證與人工核准。尤其是間接提示注入可能藏在文件或網頁中,因此外部內容必須被視為不可信資料。
Q3. LLM幻覺治理是否代表所有答案都要人工審核?
不需要。應依風險分級安排人工介入:一般文案或摘要可自動處理;涉及合約、付款、個資、醫療或法規判斷的內容,則應要求來源、規則驗證或人工核准。關鍵是讓高影響決策有足夠證據與責任歸屬。
Q4. 如何開始處理 Shadow AI 與影子AI?
先盤點員工實際使用的 AI 工具與資料類型,再提供核准、好用的替代服務與簡單資料分級規則。結合教育、DLP、存取記錄與申請流程,比單純封鎖更容易降低未授權使用與資料外洩。
Q5. AI紅隊測試應在什麼時候進行?
建議在 PoC 階段就開始,並在模型、提示詞、RAG 索引、工具權限或供應商版本變更後重新執行。測試要涵蓋提示注入、資料外洩、越權工具呼叫與業務流程後果,且每次結果都應成為後續回歸測試的基準。
Q6. 有哪些可信來源可作為護欄設計參考?
可參考 NIST AI Risk Management Framework:https://www.nist.gov/itl/ai-risk-management-framework;OWASP Top 10 for LLM Applications:https://genai.owasp.org/llm-top-10/;Google Secure AI Framework:https://saif.google/;Microsoft Prompt Shields 文件:https://learn.microsoft.com/azure/ai-services/content-safety/concepts/jailbreak-detection;以及 ISO 資訊安全標準:https://www.iso.org/standard/27001。