2026.09.23
LLM可觀測性如何讓企業看見品質、成本與風險
AI資訊
當生成式 AI 的回答開始影響客服、法務、醫療與營運決策時,團隊最需要的不是「模型看起來能用」,而是能回答它為何答錯、花了多少錢、影響了誰。LLM可觀測性正是把黑盒推論過程轉化為可追蹤證據的基礎能力。
傳統應用程式只要監看 CPU、記憶體與錯誤碼,通常就能定位異常;LLM 應用卻同時涉及 Prompt、檢索文件、模型版本、Token、工具呼叫與自然語言輸出。這使得延遲正常卻答非所問、成本下降卻安全性惡化等情況,成為企業上線後最難處理的問題。
本文將從端到端追蹤、LLM模型評估、LLM幻覺治理、LLM提示注入防護與 AI紅隊測試切入,說明如何建立企業可執行的資料模型、SLO、告警與事件應變流程。最後也會提供適合 PoC 階段驗證的做法,讓企業AI治理不只停留在政策文件。
LLM可觀測性是什麼,為何不能只看系統監控
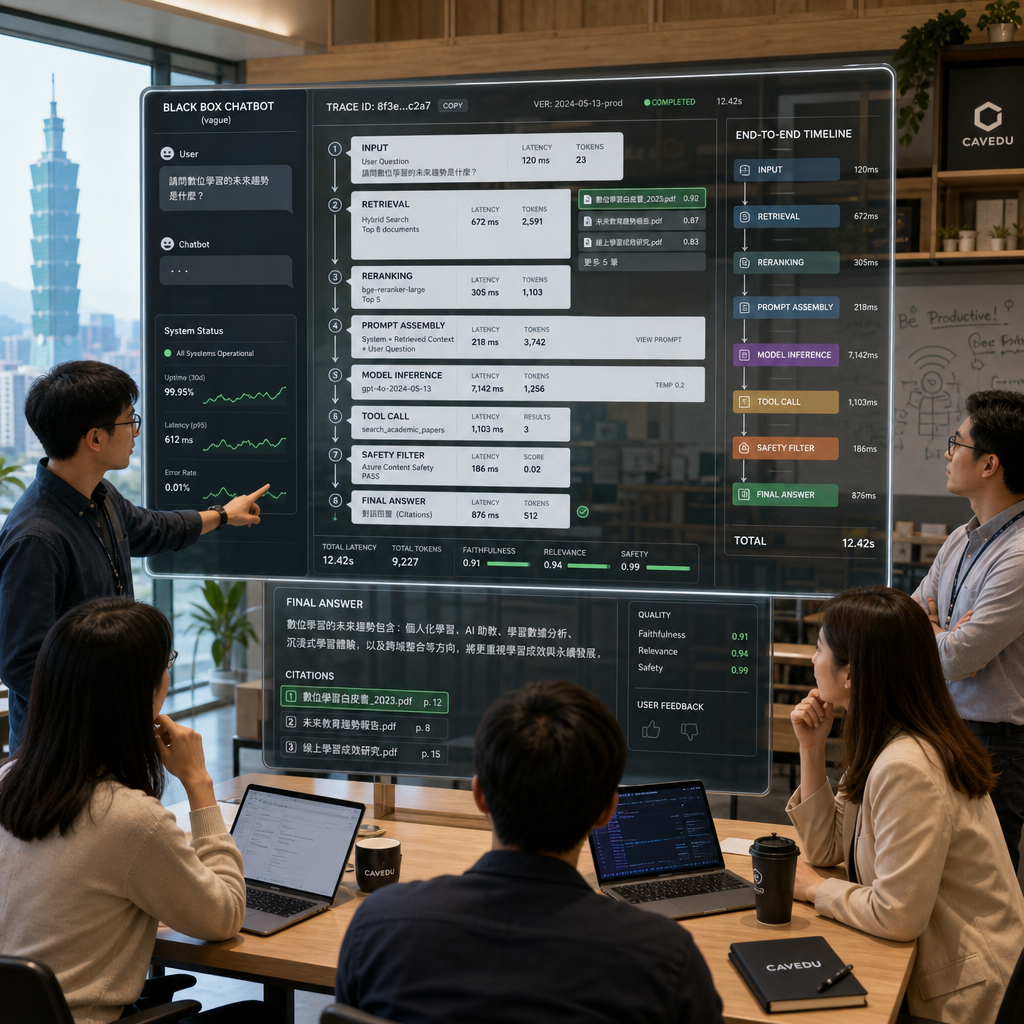
從黑盒回答還原端到端決策路徑
直接來說,LLM可觀測性是用一致的追蹤資料,重建一次使用者請求從輸入、檢索、模型推論、工具呼叫到最終回覆的完整歷程。它不只記錄「成功或失敗」,還要保留每個環節的版本、耗時、Token 與品質訊號,才能讓工程、產品與風控使用同一份事實判斷問題。
在實務上,一個客服 RAG 回答可能依序經過意圖分類、向量檢索、重排序、Prompt 組裝、模型生成與安全過濾。若客戶質疑答案來源,僅有 API 存活率毫無幫助;團隊必須能查看是哪份文件被取回、引用是否支持結論,以及哪個 Prompt 版本改變了輸出。
研究資料顯示,仅约 10% 的企业能将超过 25% 的 LLM 开发项目推进至生产阶段,而逾 75% 的企业则尚未实现任何 LLM 应用的商业化落地。這些數字說明障礙往往不只是模型能力,而是上線後無法持續證明品質、成本與風險可控。
- 每筆請求都應有可關聯的 trace_id 與 session_id。
- 品質訊號必須與延遲、成本及安全事件一起分析。
- 記錄模型、Prompt、知識庫與程式版本,才能做回歸追查。
MELT 指標之外,加入模型行為與業務結果
直接來說,MELT 的 Metrics、Events、Logs、Traces 是觀測起點,但對 LLM 還不夠。企業應額外量測輸入與輸出 Token、首字延遲、完整回覆時間、檢索命中率、工具失敗率、拒答率、引用支持率與人工覆核結果,才能理解模型是否真正完成任務。
例如回覆延遲下降不一定代表使用體驗改善:可能是模型過早中止,也可能是 RAG 根本沒有取到文件。建議將技術指標連到業務結果,例如客服一次解決率、人工轉接率、案件處理時間與客訴率,避免團隊只優化容易量測卻不重要的數字。
有些團隊以80%作為文件檢索相關性或測試案例通過率的初步門檻,並將超過30%的 Token 成本波動列為調查條件;這不是通用標準,而是可供 PoC 設計假設與告警規則的起點。門檻必須依風險等級、任務特性與資料品質校準。
- 技術層:延遲、錯誤率、吞吐量、CPU/GPU 與 Token。
- 模型層:事實性、引用完整性、拒答品質與毒性。
- 業務層:任務完成率、人工介入率與實際效益。
Trace、Span 與欄位字典是可追查性的核心
直接來說,Trace 要代表一個使用者任務,Span 則代表任務內可獨立量測的步驟。以「查詢保單理賠資格」為例,可拆成 query rewrite、retrieval、rerank、generation、citation check 與 policy check;每個 Span 都要記錄開始時間、結果、錯誤類型與關聯版本。
建議建立固定欄位字典:prompt_template_version、model_name、model_version、input_tokens、output_tokens、retrieved_document_ids、tool_name、tool_result、policy_decision、user_feedback 與 evaluator_score。欄位命名一旦統一,跨產品、跨模型與跨團隊的比較才不會失真。
OpenTelemetry 可作為跨服務傳遞 Trace Context 的共同語言,但資料送出前應先遮罩個資、帳號、地址與商業機密。早期範例曾以SERVICE_VERSION: ‘0.0.1’標識服務版本;真正重要的是每次部署都要保留可比較的版本識別,不能讓異常發生後才猜測變更內容。
- Trace 對應一個完整任務,Span 對應一個可診斷步驟。
- 文件 ID 與引用片段應可回查原始知識來源。
- 敏感 Prompt 與輸出要先去識別化,再進入觀測平台。
建立可執行的 LLM可觀測性資料與告警架構
以五層架構涵蓋從基礎設施到業務影響
直接來說,完整架構至少要觀察五層:基礎設施、模型服務、中介工作流、應用體驗與業務成果。基礎設施看 GPU、記憶體與佇列;模型服務看限流與推論延遲;工作流看檢索與工具呼叫;應用看回答品質;業務層才衡量是否創造實際價值。
只監控 API 成功率會漏掉大量「技術成功、業務失敗」的案例。舉例而言,模型正常回傳文字卻引用過期的合約版本,對系統而言是 200 成功,對法務與客戶而言卻是高風險錯誤。可觀測設計應讓這類語意失敗成為可查詢、可分類的事件。
可先採用事件匯流排與結構化日誌,將各層訊號送往同一分析區。對於多代理系統,除了最終答案,還應記錄代理路由、委派原因、工具輸入輸出與中止條件;否則失敗時只會看見最後一段自然語言,無法找出真正的根因。
- 基礎設施層用於容量、資源與可用性管理。
- 工作流層用於 RAG、Agent 與工具鏈的根因分析。
- 業務層用於判斷是否達成投資目標。
用 SLI、SLO 與告警門檻取代主觀判斷
直接來說,SLI 是量測值,SLO 是可接受目標,告警則是需要採取行動的門檻。客服問答可定義「P95 完整回覆時間」、「具支持引用的答案比例」、「檢索空結果率」與「高風險回答人工覆核率」;每項指標都要有計算方式、觀察窗口與負責人。
建議把問題分級為 P0、P1、P2。P0 是可能造成法規違反、重大錯誤決策或大規模資料外洩,應立即停用相關功能並保全 Trace;P1 是特定流程品質明顯下降,需要在既定時限內回滾或改由人工處理;P2 則納入迭代待辦與週期性改善。
告警不應只看單一請求。若同一模型版本在短時間內出現延遲、檢索失敗與低評分同步上升,才是較強的異常訊號。這種關聯分析也能避免把偶發網路抖動誤判成模型退化,降低值班人員的告警疲勞。
| 觀測層級 | 主要訊號 | 常見異常 | 建議行動 |
|---|---|---|---|
| 模型服務 | 延遲、限流、Token | 逾時、成本飆升 | 調整路由或配額 |
| RAG 工作流 | 召回率、引用支持 | 空檢索、過期文件 | 重建索引或重排 |
| 應用品質 | 評分、拒答率 | 答非所問、幻覺 | 修正 Prompt 與護欄 |
| 業務成果 | 完成率、轉人工率 | 滿意度下降 | 檢討流程與 KPI |
- 每個 SLO 都要定義分母、分子、觀察期間與資料來源。
- 告警應連結事件等級、處理時限與回滾權限。
- 品質、成本與安全指標需要一起判讀。
資料隱私、留存與存取權限要內建於管線
直接來說,觀測資料本身可能比模型輸出更敏感,因為它同時包含使用者問題、檢索內容、工具參數與身分脈絡。因此,插樁程式必須在資料離開應用前完成遮罩、雜湊或權杖化,不能把「日後再清理」當成治理方案。
多租戶產品應至少以 tenant_id 隔離資料、限制跨租戶查詢,並依角色區分工程、產品、資安與稽核可見欄位。針對含個資或機密的 Trace,需訂定留存週期、刪除程序、跨境傳輸條件與存取稽核紀錄,讓問題調查不會犧牲資料保護。
若團隊採用外部可觀測平台,選型時要檢查資料儲存區域、匯出能力、加密方式與供應商鎖定風險。可先以匿名化的 PoC 資料驗證整合,再決定是否將正式流量導入;這比一開始就將所有 Prompt 全量上傳更符合最小揭露原則。
- 先遮罩再送出,避免原始敏感內容進入第三方平台。
- 以租戶、角色與案件需求設計細緻存取權限。
- 保留稽核軌跡,並定期測試刪除與匯出流程。
以 LLM模型評估把「回答很好」轉成可驗證標準
區分模型能力、應用任務與 Agent 工作流評估
直接來說,LLM模型評估不能只看公開排行榜。模型能力評估回答「模型知道什麼」;應用評估確認「它能否完成企業任務」;Agent 評估則檢查「它是否以正確順序呼叫工具並安全完成流程」。三者混在一起,容易讓高基準分數掩蓋真實流程的失敗。
公開基準如 MMLU、HumanEval、TruthfulQA、GLUE、SuperGLUE、SQuAD 與 ToxiGen,可用來理解模型的廣泛能力與限制。MMLU 的基準涵蓋了57個主題,包括STEM、人文學科、社會科學等,但它無法直接證明模型能處理台灣企業的內規、繁體中文慣用語或專屬客服流程。
模型比較資料中,Mixtral 8\*7B 採用多專家架構,總量可寫為 56B;另一項比較指出,LLaMA-2 70B 尤其脫穎而出,在 10 項基準測試中的 6 項中獲得最高分。這些結果適合做選型起點,卻不能取代以自家資料進行的任務驗證。
- 公開 Benchmark 用於初步篩選,不等於生產可用性。
- 私有測試集要涵蓋正常、邊界、錯誤與惡意案例。
- Agent 評估必須保留軌跡與工具執行證據。
用私有測試集與評分規準建立可重現實驗
直接來說,企業應從業務目標反推測試案例,而不是先挑模型再找理由。例如「客服理賠說明」可拆成正確性、引用支持、語氣、個資保護、拒答行為與處理時間;每一項都要有明確標準、權重、標註範例與不通過時的處置方式。
測試資料應保存 query、expected_answer、allowed_sources、risk_level、prompt_version、model_version、retrieval_config、random_seed 與 evaluator_result。這些欄位讓團隊能重跑同一批案例,分辨品質變化是模型更新、Prompt 修改、知識庫調整,還是評分器本身造成。
人工評分適合處理複雜語意,但至少應由至少 2 位評分者獨立判讀,再以 Krippendorff’s alpha 檢查一致性。自動評分可加速回歸測試,但需要使用校準樣本持續驗證;否則 LLM-as-a-Judge 也可能把自己的偏誤帶進評估流程。
- 將成功條件拆成可標註、可計算、可複驗的子指標。
- 每次實驗必須記錄資料、設定、版本與評分結果。
- 人工與自動評估要互相校準,而非彼此取代。
結合離線評估、線上回饋與回歸測試
直接來說,離線測試告訴你「改版前是否值得上線」,線上觀測告訴你「真實使用時是否維持品質」。前者應包含黃金資料集與對抗案例,後者則整合使用者評價、人工轉接、重試行為與生產 Trace,兩者共同形成持續改善的閉環。
F1 scores range 0–1, with 1 signifying excellent recall and precision. 不過,對生成式問答而言,F1 不足以代表回答有用性;企業還需要衡量引用是否支持答案、關鍵限制是否揭露,以及模型是否在不知道時正確拒答。不同風險任務也不應共用同一個分數門檻。
ALION 的 AI PoC 做法是先在實際資料與接近現場的環境中驗證精度與效益,再做 Go/No-Go 判斷。這種設計能避免把公開測試成績誤當投資證據,也能將需求定義、評估規準與原型程式保留為後續正式開發可延續的資產。
- 離線集用於部署前把關與版本回歸。
- 線上訊號用於發現分布漂移與未預期需求。
- 評估結果要能支援 Go/No-Go,而非只產出分數。
用 LLM幻覺治理降低高風險錯誤的影響
把幻覺視為可偵測、可分級的營運事件
直接來說,LLM幻覺治理的目標不是承諾零錯誤,而是降低錯誤機率、及早偵測、限制影響並保留追責證據。常見類型包括捏造事實、錯誤引用、來源不支持結論、忽略提供內容,以及在資料不足時以流暢語句掩飾不確定性。
對受監管場景而言,事件嚴重度應取決於錯誤內容、受影響人數、可逆性與法規後果。P0 可包括錯誤醫療建議、錯誤法律依據或洩漏機密;P1 可能是重要政策答錯;P2 則是低影響的資訊不完整。每級都要預先定義停用、人工覆核、回滾與通報步驟。
某些觀察以10%~20%描述高風險任務可能面臨的幻覺區間,提醒團隊不能把單次展示的漂亮回覆當成可靠度證明。发布于 2025-10-13 11:02的案例整理也顯示,治理成效必須對照資料、任務與評估方法,不能抽離情境解讀單一數字。
- 幻覺事件需同時記錄內容、來源、影響範圍與處置結果。
- 拒答與人工轉接是風險控制,不是產品失敗。
- 高風險領域應設置人工核准與停止條件。
從 RAG 接地、生成控制到引用驗證建立防線
直接來說,降低幻覺要同時改善資料、檢索與生成。知識文件須有來源、版本、生效日期與權限標記;檢索流程則應評估切分、混合搜尋、重排序與文件衝突處理。若系統沒有足夠證據,模型必須明確說明資訊不足,而非自行補齊答案。
生成端可用較低溫度、結構化輸出、引用要求與拒答模板降低隨機性。例如在需要穩定答覆的流程,常以降低temperature值(如0.3)搭配Top-p采样:限制生成概率质量(如p=0.9)。但參數調整只能降低漂移,無法修復錯誤或過期的知識來源。
治理時要特別檢查「看似有引用」的陷阱:引用文件可能根本不支持結論,也可能已失效、相互矛盾或遭惡意內容污染。因此,Trace 應保存實際引用片段、文件版本與驗證結果;只記錄 URL 或文件名稱,無法證明模型答案是否真正接地。
- 知識庫文件需要版本、權限、日期與責任人。
- 檢索品質與生成品質必須分開評估。
- 引用驗證要比較答案主張與原文證據,而非只檢查連結存在。
以量化 KPI 管理改善,而不是追求單點神話
直接來說,幻覺 KPI 應至少包含事實性錯誤率、引用正確率、拒答率、誤拒答率、人工覆核率與事件解決時間。單看幻覺率可能導致模型過度拒答;單看回答率又可能鼓勵模型自信作答,因此必須將安全性、可用性與業務損失一起衡量。
部分實驗結果呈現29.67%降至24.67%,或推理准确率从 85.3% 提升至 94.7%、复杂任务解决率从 72.5% 提升至 89.2%。這類改善值得做為假設,但導入時仍要確認資料集、任務難度、評分器與人工抽查方式是否能在自家情境重現。
在醫療類案例中,曾出現医疗场景幻觉率从12%降至3%的結果;另有評估以真实性率14.45%呈現特定方法的提升。這些成果更凸顯高風險業務需要嚴謹驗證、版本追蹤與人工覆核,不能以其他領域的成績直接推論安全性。
- 同時看錯答、拒答與人工介入,才能避免指標失真。
- 每次改善都要做消融比較,確認改善來自哪一層。
- 高風險結果需抽樣人工稽核,不能只信自動評分。
以 AI紅隊測試與企業AI治理守住上線邊界
LLM提示注入必須用真實攻擊路徑驗證
直接來說,LLM提示注入是攻擊者透過使用者輸入、網頁、文件或工具回傳內容,誘使模型忽略既有規則、洩漏資料或執行不當動作。若 RAG、瀏覽器代理與外部工具互相串接,惡意指令還可能藏在檢索文件或第三方頁面中,讓單純的系統 Prompt 防護失效。
防護原則是將外部內容視為不可信資料,而不是可直接執行的指令。架構上應分離系統規則、使用者需求與檢索內容;工具採最小權限、參數驗證與明確核准;高風險動作如付款、刪除、寄信與資料匯出,則必須加入人類確認或政策引擎判斷。
可觀測性在此扮演取證角色:團隊應記錄可遮罩的輸入分類、規則命中、模型決策、工具請求與最終副作用。當攻擊成功或差點成功時,才能判斷漏洞來自 Prompt、文件管線、權限設計或工具參數,而不是只把責任歸咎於模型。
- 不可信文件與網頁內容不可擁有系統指令權。
- 工具呼叫需要權限、參數驗證與高風險確認。
- 安全 Trace 應記錄決策證據,但避免保存未遮罩機密。
AI紅隊測試要從單次演示變成持續回歸
直接來說,AI紅隊測試是以對抗者思維系統性測試越權、資料外洩、偏見、幻覺、工具濫用與規避護欄的過程。它不是在上線前做一次攻擊展示,而是將攻擊案例納入版本化測試集,讓每次模型、Prompt、RAG 或工具更新都要重新驗證。
紅隊案例可分成直接提示注入、間接提示注入、跨租戶資料探測、越權工具呼叫、機密摘要、惡意文件檢索與多輪誘導。每個案例都要定義預期安全行為,例如拒答、遮罩、停止工具呼叫、要求人工確認或回傳受限內容,並以 Trace 證明護欄實際生效。
ALION 在 AI PoC 中強調先以最小配置驗證可行性與效益,這同樣適合安全驗證:先選擇最關鍵的資料、流程與高風險工具建立測試原型,再擴大範圍。如此能避免正式開發後才發現權限模型、資料界線或現場流程根本無法承受 AI 自動化。
- 紅隊案例要可重跑、可版本化並連結到修正結果。
- 測試不只看模型回覆,也要驗證工具副作用。
- PoC 階段優先挑選高影響流程,建立可量化證據。
企業AI治理要明確分配責任與投資判斷
直接來說,企業AI治理必須清楚定義誰負責模型選型、資料品質、RAG 維運、Prompt 變更、資安審查、人工覆核與最終業務結果。若責任只寫成「AI 團隊負責」,發生幻覺、資料外洩或錯誤決策時,往往會因為權限與決策鏈不清而延誤處置。
治理委員會應要求每個高影響用例具備用途說明、資料流圖、風險評估、測試證據、SLO、事件應變流程與停止條件。模型供應商的能力聲明可以參考,但企業仍必須對自身資料、使用情境、權限配置與對外承諾負責,不能把治理責任完全外包。
若企業仍在探索階段,可採月費20 萬日圓起的上游工程支援方式,以需求梳理、設計文件與原型測試先建立決策依據。相較於聘僱 CTO 級人才的月薪 80〜150 萬日圓,或外包開發啟動費約 300 萬日圓起,小規模驗證更有利於先確認是否值得投入。
| 責任角色 | 主要職責 | 必要證據 | 常見失誤 |
|---|---|---|---|
| 業務負責人 | 定義 KPI 與風險 | 驗收標準 | 只看展示效果 |
| 資料負責人 | 資料品質與權限 | 來源與版本紀錄 | 忽略過期文件 |
| 工程團隊 | Trace 與可靠性 | 部署與回滾紀錄 | 缺少版本關聯 |
| 資安與法遵 | 風險審查與稽核 | 測試與存取紀錄 | 上線後未追蹤 |
- 責任矩陣要涵蓋資料、模型、應用、資安與業務端。
- 高風險用例應具備上線證據與可停止的營運條件。
- 先以 PoC 驗證假設,可降低大規模投資前的不確定性。
從 PoC 到正式上線,讓觀測資料成為決策資產
先定義要證明什麼,再選工具與模型
直接來說,導入順序應是先定義商業問題、風險邊界與成功證據,再決定模型、框架與可觀測平台。若一開始就被工具功能牽著走,團隊容易蒐集大量日誌,卻回答不了管理層最在意的問題:是否提升效率、是否安全、是否值得擴大投資。
PoC 的第一步可由現場訪談開始,釐清使用者實際怎麼工作、目前痛點在哪裡、哪些決策不能出錯,以及哪些資料可合法使用。接著將「有用」轉譯成可量測 KPI,例如完成時間、正確引用比例、人工修正量與可接受成本,而不是只以聊天回覆是否流暢作判斷。
在模型路由與成本設計方面,可搭配閱讀企業 LLM 營運指南:從模型路由、成本控管到可觀測性的架構設計。觀測資料能幫助團隊確認不同模型是否真的在品質、延遲與費用間達到預期平衡,而非憑主觀印象選擇。
- 先決定 Go/No-Go 證據,再設計觀測欄位與測試集。
- PoC 應使用接近正式情境的資料與流程。
- 模型選型必須同時比較品質、成本、延遲與風險。
用短週期實驗建立品質、成本與風險基線
直接來說,PoC 不必一次驗證所有功能;應先挑選高價值且可控制的單一流程,例如內部知識查詢、客服摘要或需求預測輔助。為該流程建立基線後,再逐一測試文件切分、重排序、Prompt、模型與安全規則,才能知道每項調整帶來的真實影響。
每次實驗至少要比較任務完成率、事實性、引用支持、P95 延遲、每任務 Token 成本、人工介入率與紅隊通過率。若只比較平均成本,很容易忽略少數超長對話或工具失敗造成的尾端支出;若只看品質平均值,也可能掩蓋高風險案例的重大錯誤。
提示快取能降低重複上下文的延遲與支出,但必須透過 Trace 確認命中率、快取鍵設計與資料隔離是否正確。關於實作細節,可參考提示快取是什麼?降低 LLM API 延遲與 Token 成本的實作策略,再將相關指標納入既有儀表板。
- 先建立基線,再以單一變因進行可比較的實驗。
- 平均值之外,務必查看 P95、P99 與高風險個案。
- 成本最佳化不得破壞租戶隔離、品質與安全規則。
把 PoC 成果交付為可延續的營運能力
直接來說,好的 PoC 交付物不只是可展示的聊天介面,而應包含需求文件、評估資料集、Prompt 與模型版本紀錄、觀測欄位字典、儀表板、風險清單、紅隊案例與 Go/No-Go 報告。這些資產能直接成為正式開發與維運的基礎,避免驗證完成後全部重做。
正式化前,應以演練確認告警是否真的會觸發、P0 事件能否停用功能、資料是否可依規則刪除,以及回滾後是否能用同一批測試案例驗證恢復品質。觀測系統若只在平常展示漂亮圖表,事故發生時無法支援決策,就沒有完成它的核心任務。
最終判斷應回到企業能否用可稽核證據說明:模型在哪些情境可靠、哪些情境必須拒答、出錯後誰處理、成本如何控制,以及改善是否持續有效。這正是將 LLM可觀測性、評估、安全測試與治理整合後,能為決策者提供的真正價值。
- 交付物應包含程式、資料、規則、儀表板與決策文件。
- 上線前要演練告警、停用、回滾與資料刪除。
- 可持續改善的能力,比一次性展示更有商業價值。
總結
LLM 應用的核心挑戰,不是讓模型產生更多文字,而是讓企業能以證據掌握每一次回答的來源、品質、成本與風險。LLM可觀測性將 Trace、指標、評估與安全事件串成共同語言,使團隊能從個案除錯走向可重現的持續改善。
重點整理
- 以 Trace 與 Span 串接 Prompt、檢索、模型、工具及最終業務結果。
- 將 LLM模型評估、LLM幻覺治理、LLM提示注入防護與 AI紅隊測試納入同一營運閉環。
- 以私有測試集、SLO、事件分級與版本紀錄取代主觀判斷。
- 先用小規模 PoC 建立可量測的 Go/No-Go 證據,再擴大正式投資。
- 企業AI治理必須明確分配資料、模型、資安與業務決策責任。
若您正規劃企業生成式 AI 導入,建議先選擇一個高價值流程,建立最小可行的 Trace、測試集與風險清單。透過貼近實際資料與現場情境的 PoC,先驗證品質、成本與治理條件,再決定是否進入正式開發,能大幅降低後續重工與投資失誤。
常見問題 FAQ
Q1. LLM可觀測性與一般 APM 監控有何不同?
一般 APM 主要處理服務可用性、延遲與錯誤碼;LLM可觀測性還必須追蹤 Prompt、Token、檢索文件、模型與工具版本、引用品質、幻覺、安全規則與使用者回饋。它的重點是說明模型為何產生某個答案,以及該答案是否可靠。
Q2. 企業應先做 LLM模型評估還是先建可觀測性?
兩者應同步建立最小版本。評估提供部署前的品質門檻,可觀測性則提供部署後的真實證據。建議先挑一個流程建立測試集、版本欄位與 Trace,再逐步擴大至線上評估、告警與安全治理。
Q3. RAG 已經能引用文件,還需要 LLM幻覺治理嗎?
需要。引用存在不代表來源支持答案,也不代表文件仍有效或未被惡意內容污染。治理必須檢查檢索品質、引用片段、文件版本、衝突資訊、拒答行為與人工覆核結果,才能降低看似可信卻錯誤的回答。
Q4. AI紅隊測試要測哪些 LLM提示注入風險?
至少包含直接與間接提示注入、惡意文件檢索、跨租戶資料探測、系統規則竄改、越權工具呼叫、機密資料摘要與多輪誘導。每個案例都要定義預期的安全動作,並以 Trace 驗證系統是否真的拒絕、遮罩或中止操作。
Q5. 本文參考哪些可信來源?
OpenTelemetry 官方文件:https://opentelemetry.io/docs/;NIST AI Risk Management Framework:https://www.nist.gov/itl/ai-risk-management-framework;OWASP Top 10 for LLM Applications:https://genai.owasp.org/llm-top-10/;Stanford HELM 評估專案:https://crfm.stanford.edu/helm/;arXiv 論文索引:https://arxiv.org/abs/2411.05285。