2026.09.17
LLM成本優化實戰:從推論架構到部署治理的降本策略
AI資訊
LLM成本優化的核心不是盲目砍預算,而是找出每一次回答究竟花了多少 token、GPU 時間與工程維運成本。當使用量從內部試用走向客戶服務、知識搜尋或流程自動化後,原本看似便宜的 API 呼叫,往往會因冗長提示、重複查詢與尖峰流量而快速失控。
企業常在模型效果驗證成功後才發現,成本問題其實分散在模型選擇、RAG 檢索、請求排程、GPU 閒置與人力維運。更值得注意的是,只有一半(约 48%)的 AI 项目投入生产。若沒有把成本、品質與可維運性納入上線門檻,PoC 即使展示效果亮眼,也可能無法通過正式投資審查。
本篇將以可執行的成本基線為起點,說明提示與快取治理、模型推論優化、GPU 資源規畫、AI模型部署與私有環境治理。你會學到如何用單位成本與服務水準指標判斷該先換模型、做快取、採批次處理,或評估私有化架構。
先建立 LLM成本優化 的成本基線與決策原則
把成本拆成每次任務都能追蹤的單位
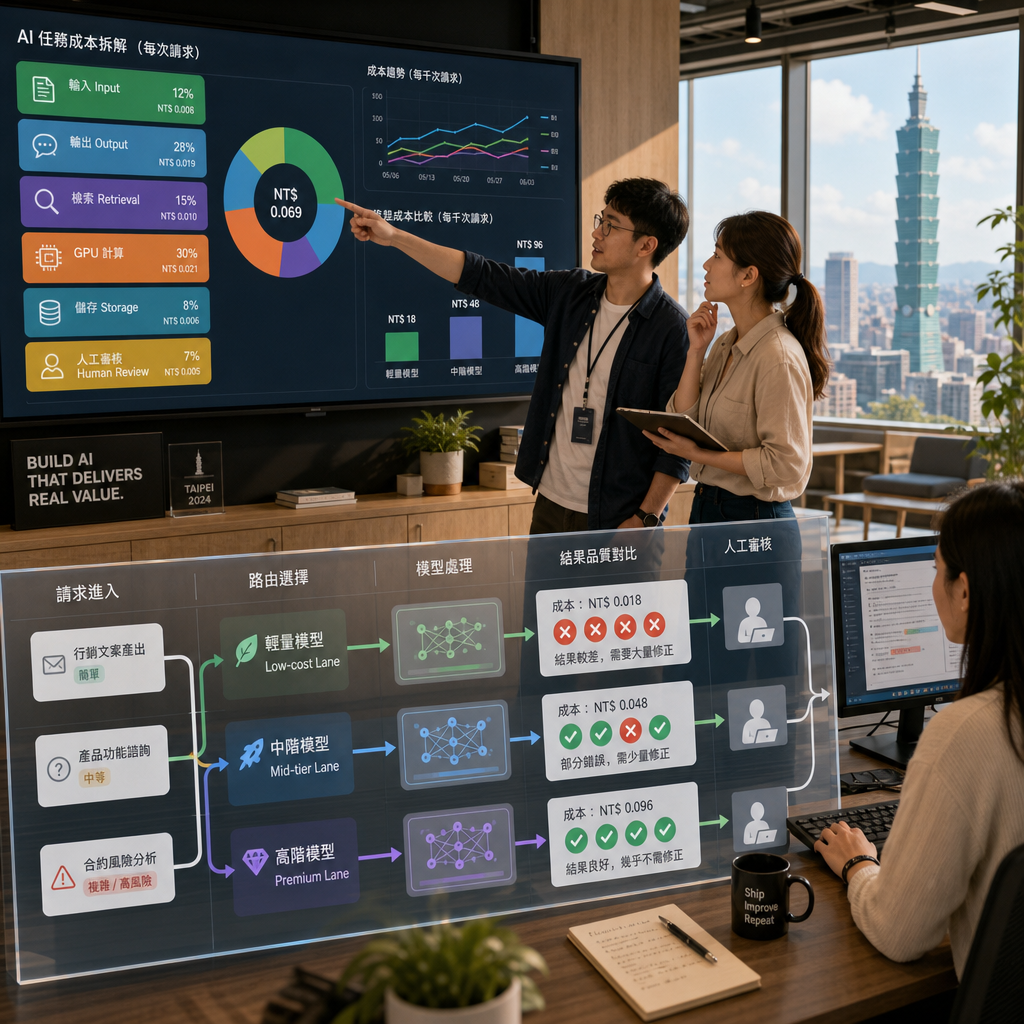
直接答案是:先以「每次成功完成任務的成本」取代單看月帳單。完整成本應包含輸入與輸出 token、檢索與向量資料庫、模型 API 或 GPU 租用、儲存與網路、人力維運,以及尖峰時段的閒置容量。只有把這些項目歸屬到產品、部門、功能與模型版本,管理者才看得出真正昂貴的是哪一種工作負載。
建議建立成本公式:單次任務成本=模型輸入成本+模型輸出成本+檢索成本+基礎設施分攤+人工覆核成本。接著搭配任務成功率、人工改寫率與 P95 延遲觀察;若回答便宜卻需要大量人工修正,並不是真正的降本。這套基線也能避免團隊只因單一 API 單價低,就忽略整體 TCO。
大型模型的記憶體需求會直接改變自建門檻。Llama 3.1 LLM 具有 4,050 亿个参数,仅推理就需要 810GB 内存(FP16)。這代表即使不計流量,僅模型載入就需要多張 GPU 與高速互連;因此在低至中等流量下,託管服務可能比長期閒置的自建叢集更具成本彈性。
- 以產品、部門、模型版本與功能標記每筆請求。
- 同時追蹤成本、任務成功率、人工覆核率與 P95 延遲。
- 把閒置 GPU、觀測工具與維運工時納入 TCO。
依任務難度做模型路由,而不是全數使用旗艦模型
直接答案是:將任務按風險與複雜度分級,讓低風險工作優先使用輕量模型。分類、格式轉換、意圖辨識與固定欄位擷取,通常不需要最高階推理能力;涉及合約、醫療、財務或高價客訴的內容,才應交給能力較強的模型,並保留人工覆核與升級路徑。
模型路由應由可量測規則驅動,例如輸入長度、資料敏感度、所需工具數、預估輸出長度與信心分數。先以小模型產生答案或判斷是否能回答,低於品質門檻才升級,可避免所有請求都走最昂貴端點。實際業務中,60%-80%的请求可以通过降级处理而不影响用户体验。
採用較小模型不等於犧牲所有品質。ChatGPT-4o mini 比 GPT-3.5 Turbo 便宜 60%。適合的做法是把它放入明確、可驗證的子任務,並以黃金測試集比較正確率、格式遵循率與拒答率;若未達門檻,才回退至較高能力模型,而非憑主觀印象選型。
- 以任務風險、輸入長度與輸出格式決定路由。
- 把升級模型視為例外流程,而非預設流程。
- 為每個路由規則保留品質測試集與回退條件。
用 PoC 證明節省的是總成本,不是局部帳單
直接答案是:成本策略應先在貼近真實資料的 PoC 驗證,再擴大到正式服務。只在乾淨測試資料上比較模型價格,往往看不見文件品質不一、使用者追問、尖峰併發與人工覆核所造成的額外費用。PoC 應先界定一個可衡量的業務假設,例如降低客服轉人工比例或縮短查詢處理時間。
ALION 的做法是從現場調查與訪談釐清 KPI,再以最小配置建立原型,驗證精度、使用體驗與效益。這種方式特別適合尚未確定該用 API、專用 GPU 或私有模型的團隊;驗證結果若顯示品質不足或 ROI 不成立,提出暫緩建議本身就是避免後續成本膨脹的重要成果。
在投資審查時,建議同時呈現優化前後的每千次任務成本、P95 延遲、快取命中率、人工覆核率與任務成功率。月費 20 萬日圓起的上游工程訂閱,可先用於需求定義、架構設計與示範製作;若進入正式開發,前期成果也能減少重新交接與重工的風險。
- 先定義一項可驗證的業務 KPI 與停損條件。
- 使用真實文件、真實流程與代表性尖峰負載測試。
- 以 Go/No-Go 報告連結成本、品質與投資決策。
從提示、RAG 與快取降低不必要的 token 支出
先減少無效上下文,再談更換模型
直接答案是:提示越短不一定越好,但每一段上下文都必須能改善答案。常見浪費包括把整份文件塞入提示、每輪都帶入完整聊天紀錄,以及重複附上不會影響回答的系統規則。應先量測每個欄位的 token 占比與對答案品質的貢獻,再刪除或摘要低價值內容。
對多輪對話而言,可保留最近幾輪原文,較早內容則改為結構化摘要,例如使用者目標、已確認事實、未解問題與限制條件。摘要也必須設定長度上限與更新時機,否則會逐步累積錯誤。對需要精確引用的任務,應以檢索文件取代依賴聊天歷史的記憶。
輸出 token 往往比想像中昂貴,因此須明確指定答案格式、最大篇幅與是否需要逐步說明。若使用者只需要分類結果,就要求 JSON 欄位,而不是生成冗長解釋;若系統需要說明,可在前端依需求展開。這類提示治理通常是最低風險、最快可驗證的節流手段。
- 為系統提示、歷史訊息與檢索片段各自設定 token 預算。
- 要求模型依任務輸出固定格式與合理長度。
- 以品質測試確認刪減上下文後沒有增加幻覺或漏答。
讓 RAG 只帶回能支持答案的內容
直接答案是:RAG 的成本控制關鍵在檢索精準度,不在於塞入更多片段。文件切分應配合內容結構與使用者問題,例如條款、產品規格與作業流程應保有標題、版本與權限等中繼資料。檢索後再以重排序或規則過濾,可降低不相關內容佔用提示空間並改善引用品質。
實務上可先取得較多候選片段,再選出少量最相關結果送入模型,同時排除重複段落與過期版本。對企業知識庫,答案還應附來源節點,讓使用者能回查依據;這不只提升信任,也能協助團隊發現是檢索錯誤、文件缺漏,還是模型生成錯誤。
評估 RAG 時不要只看回答是否流暢,至少要追蹤檢索命中率、引用正確率、無依據陳述比例與每次查詢的 token。若某類問題需要帶入大量片段才能回答,可能更適合改造原始資料、建立結構化查詢,或交由專門流程處理,而不是持續拉高上下文上限。
- 在片段中保存文件版本、權限、標題與來源連結。
- 以重排序、去重與相關性門檻限制最終上下文。
- 分開量測檢索品質與生成品質,避免錯誤歸因。
以語義快取和批次工作負載提高重複使用率
直接答案是:重複問題應優先由快取回答,延後性允許的任務則改為批次執行。快取鍵不可只比對完全相同字串,還應結合語義相似度、使用者權限、知識庫版本、模型版本與提示版本;否則雖然命中率提高,卻可能把過期或不該共享的答案回傳給使用者。
語義快取適合常見問答、文件摘要、商品屬性整理與固定格式轉換。每次命中都要記錄節省的 token 與品質回饋,並設置 TTL 與失效條件。尤其當資料更新、權限變動或安全規則改版時,應主動清除相關快取,不能只依賴時間到期。
批次處理適合夜間摘要、標籤建立、歷史資料分類與大量報表生成。三家目前都是標準價的 50%,但批次通常以完成時間交換即時性;因此應將同步互動與可等待工作分流,並對失敗請求保留重送、去重與結果校驗機制。
- 快取鍵必須納入權限、內容版本與模型版本。
- 將即時互動與可延後工作導向不同佇列。
- 追蹤命中率、節省 token、失效原因與錯誤回傳率。
模型推論優化:把吞吐量、延遲與品質一起驗證
量化與蒸餾應先設定可接受的品質損失
直接答案是:量化和蒸餾能有效降成本,但必須以任務品質門檻決定是否上線。INT8精度损失通常在1%以内,而显存占用直接减半,速度提升2-3倍。這適合作為多數模型的第一輪實驗,但仍應在企業專屬資料上測試,因為格式抽取、罕見術語與多語言任務的敏感度不同。
更激進的 4 位量化可將內存需求减少 4 倍,對顯存受限的環境很有吸引力。不過團隊不能只測平均正確率,還要觀察長文一致性、數字抄錄、結構化輸出與安全拒答。若品質波動集中在高風險案例,可採分層路由,而不是讓所有請求都使用未量化版本。
蒸餾適合把成熟模型的能力轉移到較小模型。将 Google 的 BERT 模型提炼为 DistilBERT 后,模型规模缩小 40%,推理速度提升 60%,同时保留了原模型 97% 的语言理解能力。對企業而言,蒸餾資料必須涵蓋真實任務與失敗案例,並留意授權、敏感資料與教師模型輸出的治理。
- 先以 INT8 做基準,再評估更低位元量化。
- 以正確率、幻覺率、格式遵循與拒答率設定發布門檻。
- 對高風險任務保留高精度模型或人工覆核。
連續批次與 KV Cache 要依流量型態調校
直接答案是:高併發服務通常可從連續批次獲得顯著吞吐量,但低流量服務不該為批次等待犧牲延遲。推理引擎 llama.cpp, DeepSpeed-FastGen, vLLM 都使用了 Continuous Batching,使新請求能在既有生成任務進行時加入批次,改善 GPU 利用率與長短請求混跑的效率。
KV Cache 會保存已處理 token 的注意力狀態,對長上下文、多輪對話與共用系統提示特別重要。Prefix Cache 或 Prompt Cache 可讓相同前綴不必重複預填充,但快取容量、淘汰策略與多租戶隔離需一併規畫;否則顯存被長對話占滿後,反而增加 OOM 與尾端延遲。
批次大小不應照抄範例值,而應透過壓力測試決定。如果你的推理服务每秒请求数不到10,批处理收益有限。測試時要區分首 token 時間、完整回應時間與 P50、P95、P99,並加入請求取消、超時、長輸出與尖峰突發情境,才不會只得到實驗室中的漂亮吞吐量。
- 分別監測首 token 延遲、完整回應延遲與排隊時間。
- 為 KV Cache 設定容量上限、租戶隔離與淘汰策略。
- 低併發優先縮短等待,高併發再提高批次效率。
GPU推論伺服器的選型要從顯存與利用率反推
直接答案是:GPU推論伺服器不是越大越省,而是要能在目標模型、上下文與併發下維持穩定利用率。每个高端 GPU 的成本高达 30,000 美元,若沒有足夠流量、排程能力或其他共享工作負載,採購後的閒置成本很容易高於 API 單價差額。
顯存估算至少要包含模型權重、KV Cache、啟動預留與推論引擎工作區。以大型模型為例,GPT-175B(GPT-3)權重約為 325GB,至少需要五块英伟达 A100(80GB)。實際部署還要保留批次與快取空間,因此不能僅以權重大小除以單卡顯存,便直接判定可部署。
硬體實驗應固定模型版本、量化方式、輸入輸出長度、併發量與暖機條件,才可比較不同伺服器。記錄每秒 token、每小時 GPU 成本、顯存峰值、P95 延遲與每次成功任務成本;若某台機器吞吐量高但夜間長期閒置,應考慮自動縮容、排程批次任務或改用彈性雲端容量。
- 先算權重、KV Cache、批次與工作區的總顯存需求。
- 用每次成功任務成本比較 API、雲端 GPU 與自建設備。
- 以自動縮容與佇列排程降低尖離峰閒置。
AI模型部署要把上線可靠性納入成本設計
用部署模式匹配延遲與流量需求
直接答案是:即時、批次、串流與私有端點的選擇,應由服務水準目標與資料限制決定。客服對話通常需要串流輸出與低首 token 延遲;大量文件摘要可以進入批次佇列;現場設備或高度敏感資料則可能需要靠近資料來源的端點。把所有工作都部署成即時服務,通常是最昂貴也最難維運的做法。
以部署Qwen3-0.6B模型為例,團隊應先完成容器映像、模型權重來源、健康檢查、就緒探針、資源限制與日誌格式,再進行壓力測試。部署流程不是把模型跑起來就結束,而是要驗證冷啟動時間、權限、請求上限、回滾方案,以及模型更新後提示與輸出格式是否仍相容。
下表可協助團隊先依工作負載選擇服務模式。真正的成本差異不只在單次推論,也在尖峰容量、排隊容忍度與營運複雜度;因此應先選模式,再決定模型、推論引擎與 GPU 規模。
| 面向 | 即時/串流端點 | 批次佇列 | 私有端點 |
|---|---|---|---|
| 適合任務 | 客服、互動問答 | 摘要、分類、標註 | 敏感文件、內網知識 |
| 延遲要求 | 低首 token 延遲 | 可等待完成 | 依內網服務水準 |
| 成本重點 | 尖峰容量 | 折扣與排程 | 設備利用率 |
| 主要風險 | 尾端延遲 | 失敗重送 | 閒置與維運 |
- 將互動式、可等待與資料敏感任務拆成不同部署路徑。
- 每個端點都要定義健康檢查、限流、逾時與回滾條件。
- 在正式上線前測試冷啟動、尖峰、取消請求與故障轉移。
以金絲雀發布與回滾控制模型更新風險
直接答案是:模型、提示、檢索器與推論引擎任一項變更,都應視為可回滾的版本發布。建立模型登錄、容器標籤、提示版本與評估資料集的對應關係,才能在品質下降或成本異常時迅速定位原因。沒有版本可追溯性,團隊往往只能靠人工回憶處理生產事故。
建議先讓少量流量進入新版本,比較舊版與新版的任務成功率、工具呼叫正確率、P95 延遲、每千次成本與安全攔截率。若任何核心指標超出門檻,就自動回切;不要等到大量客訴才人工停用。金絲雀期間也要避免將相同使用者在不同版本間頻繁切換,以免體驗不一致。
高可用不能只看供應商宣稱。可用性高达 99.999% 仍不代表你的應用端點必然可靠,因為網路、身分驗證、向量庫、工具 API 與前端逾時都可能成為單點故障。成本較佳的設計是針對重要流程提供降級答案、非同步補償與明確的人工接手機制。
- 將模型、提示、資料索引與引擎設定一起版本化。
- 以小流量金絲雀比較品質、延遲、安全與成本。
- 預先定義自動回切門檻與人工接手流程。
從告警到對帳,建立可營運的成本控制閉環
直接答案是:部署後的成本治理必須做到可歸因、可預警、可對帳。每一筆請求至少要記錄租戶、功能、模型、輸入輸出 token、快取狀態、檢索文件數、延遲、錯誤碼與估算成本。這些欄位能讓財務、產品與工程討論同一份數據,而不是各自解讀供應商帳單。
異常告警建議結合「絕對金額」與「行為偏差」,例如單一租戶 token 激增、快取命中率突然下降、輸出長度異常增加,或重試率提高。對使用者輸入也要設限,包括最大上下文、每分鐘請求量、單次輸出長度與每日配額,避免提示注入或程式錯誤演變成帳單事故。
監控資料應定期與供應商帳單對帳,釐清差異是計價單位、重試、批次折扣或日切時間造成。官方文件若標示上次更新時間:2026-09-08 (世界標準時間),團隊仍應在變更前重新確認限額、區域可用性與計費條件,避免沿用過期設定做錯誤預算預估。
- 建立請求層級成本事件與部門、產品歸屬標籤。
- 同時設定預算、用量偏差、重試率與快取下降告警。
- 每月將內部估算與供應商帳單逐項核對。
私有化LLM部署與 LLMOps平台 的長期治理方法
私有化LLM部署適合有資料邊界與穩定負載的情境
直接答案是:私有化LLM部署最適合資料不能離開內網、推論量穩定且能共享硬體的組織,不是所有團隊都應立即自建。評估時要比較 API 的彈性成本與私有環境的設備折舊、電力、網路、備援、資安、人力及閒置率;低流量或需求仍快速變動時,託管 API 往往有更低的試錯成本。
私有環境必須設計網路分段、身分與權限控管、密鑰管理、資料加密、稽核軌跡及模型供應鏈檢查。尤其 RAG 文件與使用者提示可能含有商業機密,除了限制模型端點,也要防止日誌、快取與除錯快照將敏感內容外流。資料保留期限和刪除流程應在上線前明確定義。
不要將私有化誤解為零邊際成本。每个数据中心的耗电量已翻倍至近 150 兆瓦。即使企業規模遠小於大型資料中心,功耗、散熱與容量備援仍是 TCO 的一部分。較務實的策略是先以小規模環境驗證模型、負載與合規,再依實際利用率擴充節點。
- 先比較穩定流量下的 TCO,而非只比較 API 單價。
- 將日誌、快取、備份與向量庫納入資料保護範圍。
- 先用最小叢集驗證利用率、品質與資安流程。
LLMOps平台要讓品質、成本與安全能共同管理
直接答案是:LLMOps平台的價值在於讓提示、模型、資料與評估流程可追溯,而非只是一個觀測儀表板。平台應集中管理模型路由、提示範本、金鑰、用量、評估集、人工回饋、內容安全規則與發布紀錄,使每次成本或品質異常都能還原到具體設定與版本。
良好的 LLMOps平台 會把離線評估和線上監控串起來。離線階段測試事實正確性、引用品質、格式遵循與安全拒答;線上階段觀察使用者回饋、人工接手率、延遲分位數、token 用量與快取命中率。兩者都必須依產品場景分群,不能只用總平均掩蓋高風險任務的退化。
治理規則也應落到權限與流程:誰能改提示、誰能調整模型路由、何時需要安全審核、何時可直接回滾。透過每週檢視成本異常、失敗案例與評估落差,團隊才能把優化從一次性專案變成持續改善。這也能降低關鍵知識只掌握在單一工程師手中的風險。
- 集中管理提示、模型、評估集、金鑰與發布紀錄。
- 同時監測離線品質與線上成本、延遲、人工接手率。
- 以角色權限與審核流程限制高風險變更。
把優化計畫變成可持續執行的營運節奏
直接答案是:先做高影響、低風險的調整,再進入硬體與架構投資。第一階段通常是建立成本標籤、token 預算、輸出限制與快取;第二階段驗證模型路由、RAG 重排序與批次佇列;最後才依穩定流量評估量化、自建 GPU 與私有化。每一階段都應有明確 KPI、負責人與停止條件。
實際推進時,可由業務、資安、財務與工程共同檢視代表性案例。ALION 以需求定義、原型、效益驗證到投資判斷的方式,協助團隊把技術選擇連回現場流程;PoC 的程式碼、設計文件與評估結果也能延續至正式開發,避免為了展示而做出無法維運的原型。
以下資料可作為技術決策與驗證方法的起點。閱讀官方文件時,應將建議參數帶回自己的模型、語言、文件長度與流量曲線重新測試;沒有任何一組量化、批次或快取設定能直接套用到所有企業情境。
- 以成本基線與品質門檻排定優化優先順序。
- 讓業務、工程、資安與財務共用同一套 KPI。
- 將 PoC 產物設計為可延續的正式開發資產。
總結
LLM成本優化真正要管理的是「在符合品質與服務水準下,每次成功完成任務的總成本」。從提示縮減、RAG 精準化、語義快取與模型路由開始,通常能快速降低浪費;當流量與資料邊界明確後,再以量化、GPU推論伺服器、AI模型部署與私有架構提升長期效率。
重點整理
- 先建立請求層級成本基線,將 token、檢索、GPU、閒置與人工覆核一起計算。
- 以品質門檻驅動模型路由、量化與快取,不以單一價格或吞吐量做決策。
- 將部署、版本發布、告警、對帳與資安納入同一套 LLMOps 治理流程。
- 用貼近真實資料與流程的 PoC,驗證 ROI 後再擴大硬體與正式開發投資。
- 參考來源:https://docs.vllm.ai/ 、https://docs.nvidia.com/deeplearning/tensorrt/ 、https://cloud.google.com/vertex-ai/docs 、https://ai.google.dev/gemini-api/docs/caching 、https://arxiv.org/abs/1910.01108
若你的團隊已經有 AI 應用構想,卻還無法判斷 API、GPU 或私有化哪一條路最划算,建議先選定一個高頻、可量測的業務流程做小規模驗證。以真實資料測出成本、品質與現場使用性,再決定是否進入正式開發,能把不確定性轉化為可執行的投資依據。
常見問題 FAQ
Q1. LLM成本優化應該先從換模型開始嗎?
不一定。建議先盤點輸入輸出 token、重複查詢、聊天歷史、檢索片段與人工覆核成本。提示治理、快取與輸出限制通常風險較低;確認這些改善後,再用評估集測試模型路由或降級是否符合品質門檻。
Q2. 什麼情況適合自建 GPU推論伺服器?
當推論流量穩定、資料不能離開私有網路、模型與工作負載可由多個團隊共享,且能維持足夠 GPU 利用率時,自建才較有機會攤薄固定成本。若使用量波動大或需求尚未定型,彈性 API 或雲端 GPU 通常更適合先驗證。
Q3. 量化模型會不會讓回答品質明顯下降?
影響取決於位元數、模型、語言與任務。應比較量化前後的正確率、引用品質、格式遵循、幻覺率與拒答率,並對高風險案例保留高精度模型或人工覆核。只看平均速度與顯存節省,不足以決定是否發布。
Q4. 私有化LLM部署是否就不需要 LLMOps平台?
仍然需要。私有部署同樣有模型更新、提示版本、資料索引、權限、成本歸屬、資安稽核與品質退化問題。LLMOps平台可將這些流程集中管理,讓團隊在出現成本或品質異常時能快速追溯並回滾。
Q5. PoC 如何避免成為無法上線的展示品?
PoC 一開始就應使用代表性的真實資料、定義業務 KPI、設定品質與成本門檻,並把程式碼、架構圖、評估集與發布流程視為可延續資產。驗證完成後,以 Go/No-Go 決策報告判斷是否擴大,而不是只展示模型能否回答問題。