2026.09.15
AI評価基盤で生成AIの品質を継続改善する方法
IT関連
AI評価基盤とは、生成AIの回答・検索・ツール実行を同じ基準で測定し、改善につなげる仕組みです。モデルを入れ替えただけで品質が上がるとは限らず、評価を仕組みにすることが安定運用の出発点になります。
従来のソフトウェアテストは、入力に対する正解が固定される処理に強みがあります。一方、生成AIは質問の表現、参照文書、モデル更新で出力が変わるため、正確性だけでなく事実性、関連性、安全性、応答体験を多面的に確かめる必要があります。
本記事では、評価対象の分解、AI評価データセットの作り方、LLM評価とRAG評価指標の使い分け、AIエージェント評価、運用監視までを順に説明します。開発・業務・統制の担当者が共通言語を持てる実践的な設計図としてご活用ください。
AI評価基盤とは何かを業務品質から捉える
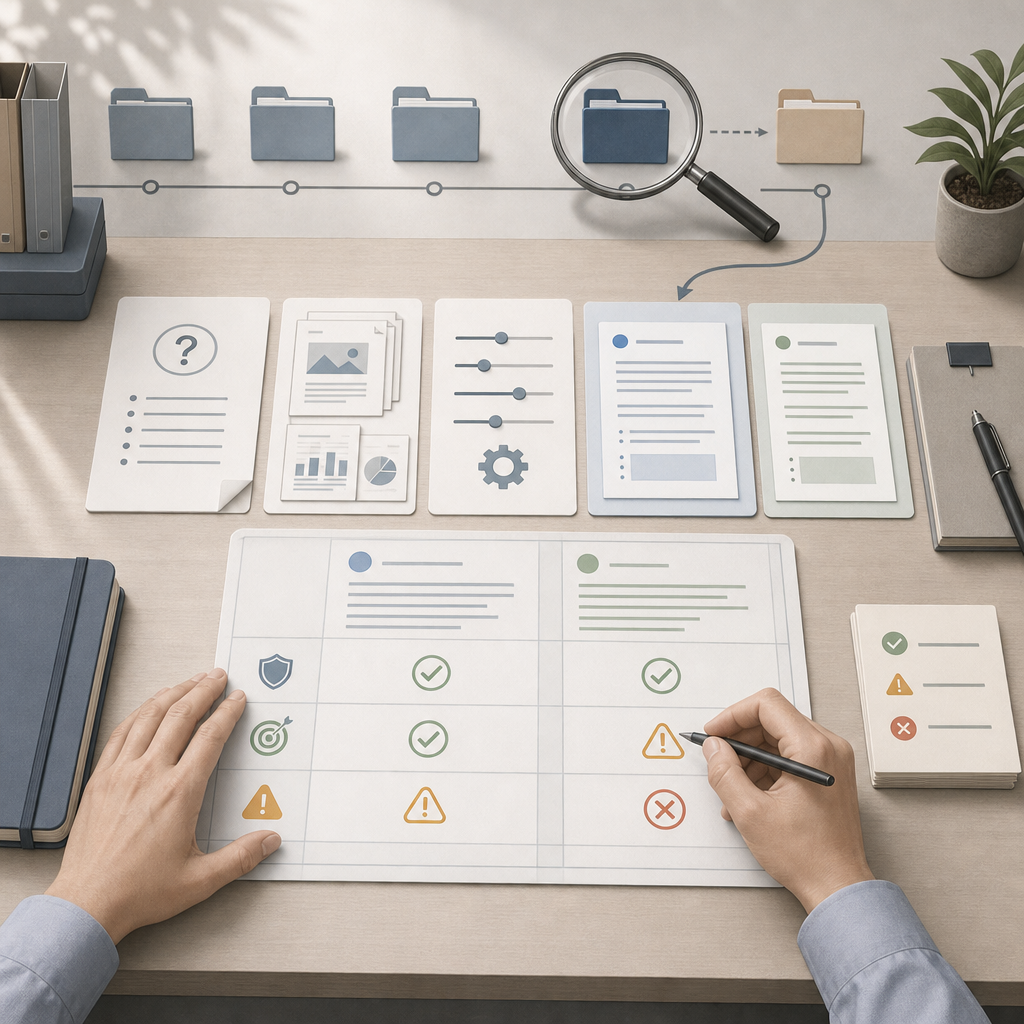
評価基盤は品質判断を再現可能にする仕組み
AI評価基盤の役割は、生成AIの良し悪しを担当者の印象だけに任せず、評価条件・データ・判定結果を一元管理することです。質問、参照文書、モデル設定、出力、採点根拠を結び付けることで、変更後の品質を同じ条件で比較できます。
特に社内規程検索や顧客対応では、「自然な文章だった」だけでは合格にできません。回答が根拠文書に忠実か、質問意図に合うか、禁止情報を出していないかを分けて記録すると、障害時に原因を検索・生成・指示のどこまで遡るべきか判断できます。
基盤は単なる採点ツールではなく、改善判断の記録帳でもあります。評価結果をリリース履歴と結び付ければ、モデル、プロンプト、検索設定、文書更新のどれが品質変化を起こしたかを追跡でき、再実行や再採点にも耐えられます。
- 入力・出力・参照情報を同じ識別子で保存する
- 品質軸ごとに合否基準と判定根拠を残す
- 変更前後を同一テストケースで比較する
従来テストだけでは生成AIを保証できない理由
生成AIでは、同じ質問でも表現の揺れや会話履歴によって回答が変わります。そのため、期待文字列との完全一致だけで判定すると、有用な言い換えを誤って不合格にし、もっと重要な事実誤認や安全上の問題を見落とすおそれがあります。
評価では機能的正確性に加え、事実性、関連性、網羅性、流暢性、毒性、偏見、応答時間を扱います。高リスク領域では、誰がどの基準で承認したかも品質の一部です。AI出力検証を開発工程に埋め込むことが欠かせません。
たとえば回答に「最大2%還元」という販売条件が含まれる場合、表現の自然さではなく、参照した制度文書との一致、有効条件の欠落、対象外ユーザーへの誤案内を確認します。業務上の正解は、文法的な正しさよりも根拠と適用条件で決まります。
- 完全一致テストと意味評価を併用する
- 安全性・根拠・適用条件を別々に判定する
- 人が確認すべき失敗を優先表示する
評価対象をモデル・RAG・行動に分解する
評価対象は、LLM単体、RAGを含む応答システム、複数ツールを使うエージェントの3層に分けると明確です。LLM単体で文章能力が高くても、検索文書の選択や外部ツールの操作まで正しいとは限らないため、層ごとに責任範囲を定義します。
コードや端末操作を伴うAIでは、最終回答だけでなく実行経路が重要です。たとえばTerminal-Bench 4.0のようなタスク型ベンチマークは、指示理解、コマンド実行、状態変更、最終成果物を含む評価の必要性を示しています。
評価契約には、入力形式、期待する振る舞い、禁止事項、採点方法、例外処理を明記します。これにより、開発者は何を最適化すべきかを把握し、業務部門は本番利用で許容できる失敗と、即時停止すべき失敗を区別できます。
- モデル能力とシステム品質を混同しない
- 最終回答と実行軌跡をそれぞれ記録する
- 業務ごとに許容不可の失敗を定義する
評価データを資産として設計する
AI評価データセットは実業務の失敗を写す
AI評価データセットは、実際の利用場面でAIが期待通りに働くかを測るための検証用データです。公開ベンチマークだけでは自社の規程、商品、顧客表現、例外ルールを十分に扱えないため、業務ログと専門家知識を組み合わせて育てます。
良いデータセットには、頻出質問だけでなく、曖昧な質問、表記揺れ、複数文書をまたぐ質問、答えられない質問、権限外情報を引き出そうとする質問が入ります。成功例に偏ると、本番で起こりやすい失敗を測れず、見かけだけ高い評価になります。
各データには、質問、正解または評価観点、参照すべき文書、期待しない回答、難易度、作成者、更新日を付与します。情報源が更新された際に影響するケースを抽出できるため、文書改訂のたびに全件を手作業で点検する負荷を抑えられます。
- 実ログから失敗・曖昧さ・例外を採取する
- 回答不能が正解となるケースを含める
- 作成根拠と変更履歴をデータ単位で残す
ゴールデンデータはラベル基準とセットで管理する
ゴールデンデータとは、重要業務において合格と認める回答・根拠・判定基準を定めた基準データです。文章の唯一解を無理に作るのではなく、「必ず含める条件」「根拠外で述べてはならない事項」「回答を控える条件」を明確にすることが実務的です。
ラベルの信頼性を上げるには、複数人が同じケースを採点し、不一致を議論して判定ガイドを更新します。人間のラベラー間の一致率は通常60〜80%程度であり、(Cohen’s kappa) ≈ 0.4-0.7という前提を置くと、単発の主観評価を過信しにくくなります。
初期段階では、業務の重要度に応じて少なくとも500〜1000サンプルを目標にし、データ量よりも多様性を優先します。問い合わせ分類、検索、要約、回答生成を同じ集合に押し込まず、利用目的ごとに合格定義を分けることが比較可能性を守ります。
- 必須要素・禁止要素・回答保留条件をラベル化する
- 二重評価の不一致を基準書の改善に使う
- 用途別にデータセットと合格基準を分ける
日本語業務に合わせてデータの代表性を確保する
日本語の評価では、敬語、主語の省略、社内略語、表の注記、法令名、固有名詞が品質に直結します。英語の公開問題で高得点でも、社内規程の但し書きや日本語の曖昧な依頼を誤解する可能性があるため、自組織の文書形式を反映させる必要があります。
公開ベンチマークは能力比較の出発点として有用です。MMLU(Massive Multitask Language Understanding)は57の学科領域にわたる15,908問を収録し、幅広い知識・推論の比較に役立ちますが、社内業務の合格判定を直接代替するものではありません。
データのアクセス権も設計対象です。個人情報、契約情報、未公開の規程を評価用に複製する場合は、マスキング、保管期間、閲覧者、外部評価モデルへの送信可否を定めます。統制観点は生成AI監査の進め方も参照してください。
- 敬語・略語・表・注記を含む実文書で試験する
- 公開ベンチマークと業務データを役割分担する
- 評価データ自体の権限と持ち出しを管理する
LLM評価を多面的な判定へ変える
LLM評価は目的に応じて指標を組み合わせる
LLM評価では、単一スコアでモデルの良否を決めず、ユースケースに必要な品質軸を組み合わせます。要約なら重要事項の欠落と事実性、問い合わせ対応なら関連性と安全性、コード生成なら実行結果と保守性を優先し、目的外の指標で最適化しないことが重要です。
分類や抽出のように正解ラベルがある仕事では、精度・再現率・F1を使えます。F1スコアは0〜1の範囲で、正解を取りこぼさない再現率と、誤答を減らす適合率のバランスを確認する際に有効です。ただし生成文の根拠までは示しません。
自由回答では、参照回答との類似度だけでなく、評価者が定義したルーブリックで事実性、論理性、指示追従を採点します。指標の数を増やすより、各指標がどの意思決定を支えるのかを先に決めると、チーム間の解釈のずれを減らせます。
- ユースケース別に最優先の品質軸を決める
- 正解ラベル型と自由回答型の評価を使い分ける
- スコアの用途をリリース判断まで定義する
自動採点と専門家レビューを校正して使う
LLM-as-a-Judgeは、大量の回答を一定の観点で迅速に評価するのに有効です。ただし評価モデル自身の好み、回答位置、長文への過大評価、自己強化バイアスを持ち得ます。自動採点を唯一の真実とせず、専門家レビューで定期的に校正する運用が必要です。
GPT-4のJudgeは人間との一致率80%以上を達成したという報告がある一方、人間のアノテーター間一致率 ≈ 81%でもあります。この差は、評価者の完全な一致を前提にするのではなく、曖昧なケースを許容しつつ判定基準を改善する重要性を示します。
実務では、全件を自動採点し、境界付近のケース、安全性に関わるケース、判定モデル間で割れたケースを人手で確認します。人が訂正した結果を蓄積すれば、評価プロンプトとルーブリックを更新でき、レビュー時間を高リスクの判断へ集中できます。
- 自動採点の結果を標本監査する
- 不一致ケースを判定ガイド改訂に使う
- 安全性・法務判断を自動判定だけで完結させない
変更の影響を比較して回帰を防ぐ
LLM評価で最も重要なのは、モデル更新後に何が悪化したかを早く検知することです。モデル名、温度、システム指示、ツール定義、評価器のバージョンを固定して記録し、同一データセットで変更前後を比較することで回帰を見つけられます。
公開性能をそのまま採用判断に使うのは危険です。元のMMLUスコア:88%に対し、パラフレーズスコア:72%となる例は、設問形式への適応で能力が過大評価され得ることを示します。社内の自然な質問で再評価する理由はここにあります。
継続評価は、リリース前のオフライン試験と、本番ログを用いるオンライン監視をつなぐ工程です。回答率の変化だけで満足せず、根拠のない断定、拒否すべき依頼への応答、重要回答の誤りを失敗モード別に追うことが改善を速めます。
- 評価条件を固定して差分を比較する
- 公開スコアを業務品質の代用にしない
- 本番ログで新しい失敗パターンを追加する
RAG評価指標で検索と回答の原因を切り分ける
RAGは検索品質と生成品質を別々に測る
RAG評価指標では、検索した文脈が適切か、生成回答がその文脈に忠実かを分けて確認します。検索が誤っていれば優れたモデルでも正答しにくく、検索が正しくても生成が補完や誤読をすれば誤案内になるため、総合点だけでは原因を特定できません。
代表的な観点は、文脈の関連性を測るContext Precision・Context Recall、回答と文脈の整合を見るFaithfulness、質問への適合を見るAnswer Relevanceです。Context Relevanceは0から1の値をとり、0は関連のある回答が存在せず、1が全ての文において質問と関連があると判定されたことになります。
指標が高いほど常に業務品質が高いわけではありません。医療のスクリーニングのように、100万人の病気でない人と100人の病気の人という偏りがあった場合は、陽性判定を受けた人のうち実際に病気である人はたった6%にすぎません。用途ごとに誤判定の影響を考える必要があります。
- 検索・生成・最終回答を分離して測定する
- 各スコアの入力と意味をチームで共有する
- 業務リスクを無視して平均点だけで判断しない
スコアからRAG精度改善の打ち手を選ぶ
RAG精度改善は、低い指標を見て一律にモデルを変更することではありません。Context Recallが低いなら文書不足や検索漏れ、Context Precisionが低いならノイズ混入、Faithfulnessが低いならプロンプトや生成制約の問題を優先的に疑うのが合理的です。
たとえばRagas v0.4+で、faithfulness 0.91、answer_relevancy 0.87、context_precision 0.82、context_recall 0.78という結果なら、まず必要情報の取りこぼしを精査します。回答の忠実性より検索再現率が弱い状況では、チャンク化やメタデータ、クエリ設計を見直す余地があります。
改善後は同じ質問群で再評価し、良くなった指標と悪化した指標を併記します。検索範囲を広げるだけではノイズが増えることがあるため、Hybrid Search、Reranker、文書の版管理、回答保留の設計を組み合わせ、特定の数字だけを追いかけないことが大切です。
| 評価観点 | 低い場合の主因候補 | 主な改善箇所 |
|---|---|---|
| Context Recall | 文書不足・検索漏れ | チャンク・検索式 |
| Context Precision | 無関係文書の混入 | Reranker・フィルタ |
| Faithfulness | 根拠外の補完 | 生成制約・引用 |
| Answer Relevance | 質問意図の誤読 | クエリ変換・指示 |
- 低い指標を検索・生成・データの仮説に結び付ける
- 改善前後で同一ケースを再実行する
- 再現率向上によるノイズ増加も確認する
本番ログを評価ケースへ戻して監視する
RAGの品質は、文書の追加、権限変更、埋め込みモデル更新、問い合わせ傾向の変化で継続的に揺れます。リリース前の固定データだけでは新しい失敗を捉えにくいため、本番ログから匿名化・承認済みのケースを選び、評価集合へ定期的に追加します。
ログでは、無回答、再質問、有人対応への転送、根拠リンクの未クリック、低評価を手掛かりに失敗を抽出します。その後、検索文書、回答、参照箇所、会話文脈を確認し、データ欠損、検索漏れ、生成誤り、仕様不足に分類すると改善担当を割り当てやすくなります。
評価結果をダッシュボードで可視化する際は、平均値とともに重要質問の合否、失敗件数、文書版別の変化を示します。現場は平均スコアの小さな変動より、「どの規程の、どの質問が、誰に誤案内されるか」を知ることで適切に対処できます。
- 本番の失敗を承認・匿名化してテストへ戻す
- 失敗を原因別に分類して担当を明確にする
- 平均値と重要ケースの合否を併記する
AIエージェント評価を継続運用と統制につなげる
AIエージェント評価は最終回答だけでは足りない
AIエージェント評価では、最終回答に加えて、計画、検索、ツール選択、引数、実行順序、停止判断という軌跡を検証します。最終結果が偶然正しくても、不要な権限でツールを呼んだり、危険な操作を試みたりした経路は、本番運用では合格にできません。
評価ケースには、正常完了だけでなく、権限不足、ツール障害、矛盾する指示、承認が必要な操作を含めます。エージェントが不確実な状態で実行を続けず、質問し直す、処理を止める、人へ引き継ぐという安全な選択を取れるかを明示的に採点します。
Terminal-Bench 3.xと4.0のように実行環境を伴う評価では、結果ファイルだけでは十分ではありません。コマンド履歴、外部アクセス、試行回数、失敗後の回復を追跡し、許された行動空間の外へ出ていないことまで確認する設計が必要です。
- 成果物と実行軌跡を別々に採点する
- 失敗時に安全停止できるかを検証する
- ツール呼び出しの権限と引数を監査可能にする
評価を開発パイプラインに組み込む
評価を継続させるには、プロンプト、モデル、検索設定、ツール定義、文書を変更するたびに、重要な評価集合を自動実行する仕組みが必要です。開発者が任意で確認するだけでは、納期が近い変更や小さな設定変更で回帰を見落としやすくなります。
運用では、軽量な自動評価を日常の変更確認に使い、重要リリース前に専門家レビューを重ねます。評価器そのものを更新する場合も、過去スコアとの比較不能性を避けるため、評価器の版、プロンプト、判定モデルを結果と一緒に保管します。
ALION株式会社のように専属チームで開発を伴走する体制では、業務担当者が評価基準を定め、開発者が計測と自動化を実装し、運用担当がログから新ケースを回収する役割分担が有効です。基盤は導入時の成果物ではなく、協働で育てる運用資産になります。
- 変更時に重要ケースを自動評価する
- 評価器の設定・版も結果と保存する
- 業務・開発・運用の責任境界を決める
監査証跡と改善サイクルを一つの基盤で扱う
信頼できる運用では、誰がどのデータで評価し、どの結果を根拠に公開したかを後から説明できなければなりません。評価データの出所、モデル設定、採点結果、例外承認、リリース判断を結び付けることで、品質改善と説明責任を同時に満たせます。
アクセス制御では、評価データの閲覧者、評価を実行できる人、合格基準を変更できる人、公開承認者を分けます。特に顧客情報や社内規程を含む環境では、便利さを理由に全員へ権限を開放せず、最小権限と操作記録を前提に設計します。
改善サイクルは、計測、失敗分析、仮説設定、変更、再評価、承認の順に回します。AI出力検証の記録を監査にも活用すれば、品質部門と統制部門が別々の資料を作る重複を減らし、利用部門に説明しやすい運用へ近づけます。
- 評価条件から公開承認まで証跡をつなぐ
- 権限変更と基準変更を記録する
- 失敗分析を次のテストケースへ反映する
まとめ
AI評価基盤は、生成AIを一度採点するための仕組みではなく、LLM評価、RAG評価指標、AIエージェント評価を業務品質へ結び付ける継続的な運用基盤です。評価データ、判定基準、実行履歴を一貫して管理することで、改善の優先順位と公開判断を根拠あるものにできます。
要点
- 評価対象をLLM単体、RAG、エージェントの層に分ける。
- AI評価データセットは実業務の失敗・例外・回答保留を含めて育てる。
- RAG精度改善では検索指標と生成指標を分け、原因に応じて施策を選ぶ。
- 自動採点は人手レビューで校正し、重要な判断を置き換えない。
- 本番ログ、変更履歴、承認記録を結び、継続評価と統制を両立する。
まずは、影響の大きい業務を1つ選び、質問・参照文書・期待する振る舞い・禁止事項を整理してください。その小さな評価集合を起点に、変更前後を比べる仕組みを実装すると、AI評価基盤を無理なく組織の品質管理へ定着させられます。
よくある質問
Q1. AI評価基盤は、小規模な生成AI導入でも必要ですか?
必要です。最初から大規模な製品を導入する必要はありませんが、重要な質問、期待する回答、禁止事項、変更前後の比較記録は小規模でも整備すべきです。利用拡大後の品質劣化を防ぎやすくなります。
Q2. LLM評価とRAG評価指標の違いは何ですか?
LLM評価は文章生成、指示追従、安全性などモデルや回答の品質を広く扱います。RAG評価指標はそれに加え、検索した文脈の関連性・網羅性と、回答が文脈に忠実かを分けて確認する点が特徴です。
Q3. LLM-as-a-Judgeだけで公開判定をしてよいですか?
高リスク業務の公開判定を自動評価だけで行うことは推奨できません。自動評価は大量処理と傾向把握に使い、安全性、法務、顧客影響が大きいケースは専門家レビューで校正・承認する体制が必要です。
Q4. RAG精度改善で最初に見るべき点は何ですか?
まず検索結果に正しい根拠が含まれているかを確認します。根拠がなければ文書整備や検索設定を、根拠があるのに回答が誤るなら生成指示、引用、回答保留のルールを優先して見直します。
Q5. AIエージェント評価で残すべきログは何ですか?
ユーザー入力、計画、ツール呼び出し、引数、実行結果、エラー、最終回答、使用モデルと設定、承認者を関連付けて残します。これにより、結果だけでなく危険な経路や権限逸脱も検証できます。
参考文献・出典
[Artificial Intelligence](https://www.ibm.com/jp-ja/think/artificial-intelligence) [Business operations](https://www.ibm.com/jp-ja/think/business-operations)…
www.ibm.com
* [会社概要](https://a-x.inc/about/) * [メンバー](https://a-x.inc/member/) * [サービス](https://a-x.inc/service/) + [AXCAMP サービスページ](https://a-x.inc/service/ax_camp/) +…
a-x.inc
…
azure.microsoft.com